Unsere Website enthält Links zu Partnerseiten. Wenn Sie von unserer Website auf die Seite eines Partners wechseln und dort dessen Dienste kaufen, erhalten wir für die Vermittlung eine Provision (Mehr erfahren). Diese Form der Zusammenarbeit beeinflusst die Objektivität unserer Bewertungen nicht. Mit jedem Kauf über Links von unserer Website unterstützen Sie unsere Redaktion, damit wir auch in Zukunft hochwertige und nützliche Inhalte erstellen können. Vielen Dank.

Lokale KI-Hardware 2026: So finden Sie den richtigen Rechner für LLMs zu Hause

Inhalt
Sie möchten Sprachmodelle auf dem eigenen Rechner betreiben – ohne Abo, ohne dass Daten Ihren Schreibtisch verlassen, und ohne Internetverbindung? Dann zählen der Prozessor und der „TOPS“-Aufkleber auf der Verpackung weit weniger als zwei andere Dinge: wie viel Speicher das Modell nutzen kann und wie schnell der Rechner diesen Speicher lesen kann. Dieser Ratgeber erklärt, wie lokale KI auf einem Computer tatsächlich läuft, wie viel Speicher populäre Modelle brauchen und was aktuelle Hardware in der Praxis leistet – von der Grafikkarte, die Sie in Ihren vorhandenen PC stecken, bis zur Workstation für ein ganzes Team. Zu jedem Gerät gibt es geprüfte Zahlen, Quellen und ein klares Urteil, für wen es sich eignet; einige Abschnitte enthalten zusätzlich ein kurzes Video.
Das Wichtigste in 30 Sekunden
- Der Speicher entscheidet alles. Das gesamte Modell muss in schnellen Speicher passen, auf den die GPU zugreifen kann. Bei 4 Bit rechnen Sie mit etwa 0,6 GB pro Milliarde Parameter.
- Die Speicherbandbreite bestimmt, wie schnell das Modell schreibt, die Rechenleistung, wie schnell es einen langen Prompt liest. Deshalb schreibt ein Mac schneller als ein DGX Spark, während der Spark lange Dokumente schneller liest.
- Derzeit das beste Preis-Leistungs-Verhältnis: Mac Studio M5 Max mit 128 GB (schnelle Ausgabe), Ryzen AI Max+ 395 mit 128 GB (günstigster großer Speicher), RTX 5060 Ti 16 GB (günstigster sinnvoller Einstieg).
- Ein „KI-PC“ mit NPU ist kein Rechner für lokale KI. Weder Ollama noch LM Studio nutzen die NPU.
Wir haben diese Geräte nicht selbst getestet – die Zahlen stammen aus den am Ende aufgeführten Quellen, Messungen aus der Community sind als solche gekennzeichnet. Bei den Preisen handelt es sich um US-Listenpreise mit Datumsangabe; die Speicherknappheit hat viele davon im Lauf des Jahres 2026 steigen lassen.
Was Sie kaufen sollten: die Kurzempfehlungen
Wer nicht den ganzen Ratgeber lesen möchte, findet hier die Abkürzung. Jede Empfehlung wird weiter unten ausführlich behandelt, einige auch mit Video.

| Klasse | Empfehlung | Geeignete Modelle |
|---|---|---|
| Einstieg | RTX 5060 Ti 16 GB im vorhandenen PC | 8–20B (Qwen3 14B, gpt-oss-20b) |
| Starter | Mac mini M6 mit 32 GB oder RTX 5070 Ti | bis 14B flott, Qwen3 30B-A3B |
| 64 GB | Mac mini M5 Pro mit 64 GB | 20–35B, leiser Heimserver |
| 128 GB, günstig | Ryzen AI Max+ 395 mit 128 GB | große MoE-Modelle bis 120B |
| 128 GB, schnell | Mac Studio M5 Max mit 128 GB | gpt-oss-120b mit über 100 Token/s |
| CUDA-Entwicklung | DGX Spark oder ein anderer GB10-Rechner | CUDA-Entwicklung, Coding-Agenten |
| Max. Speicher | Mac Studio M5 Ultra mit 256 GB | 100–250B-Modelle zu Hause |
| Team-Workstation | RTX PRO 6000 | 70–120B für ein ganzes Team |
Warum KI lokal betreiben – und was Sie nicht erwarten sollten
Ein lokales Modell läuft auf Ihrem eigenen Rechner. Ihre Daten verlassen nie den Schreibtisch, Sie zahlen weder ein Monatsabo noch Gebühren pro Token, das Modell funktioniert offline, und niemand kann es über Nacht verändern oder abschalten. Das passt gut zu sensiblen Dokumenten, zu Coding-Assistenten, die mit Firmencode arbeiten, zu Automatisierungen, die Tausende Anfragen am Tag verschicken – oder einfach zum Experimentieren aus Spaß an der Sache.
Es gibt zwei Haken. Erstens sind die offenen Modelle, die auf Heim-Hardware passen, zwar klug, reichen aber nicht an die besten Cloud-Dienste heran. Zweitens ist die Hardware nicht billig, und 2026 hat die Speicherknappheit die Preise nach oben getrieben. Die wichtigsten Gründe für lokale KI sind Datenschutz, Kontrolle und Unabhängigkeit – nicht Kostenersparnis.
So läuft ein Modell auf Ihrem Rechner
Wenn Sie einem Modell eine Frage schicken, laufen zwei Phasen ab, und jede wird von etwas anderem begrenzt:
- Prompt lesen (Prefill). Das Modell verarbeitet Ihre gesamte Eingabe auf einmal – die Frage, ein eingefügtes Dokument, den Code Ihres Projekts. Diese Phase hängt von der Rechenleistung der GPU ab und bestimmt, wie lange Sie auf das erste Wort der Antwort warten. Bei einer kurzen Frage dauert das Sekundenbruchteile, bei einem Dokument mit Zehntausenden Wörtern können es Minuten werden.
- Antwort schreiben (Decode). Das Modell erzeugt den Text Wort für Wort (genau genommen Token für Token). Für jedes Token muss es das gesamte Modell aus dem Speicher lesen – bei Mixture-of-Experts-Modellen nur den aktiven Teil. Diese Phase hängt von der Speicherbandbreite ab: wie viele Gigabyte pro Sekunde der Chip lesen kann.
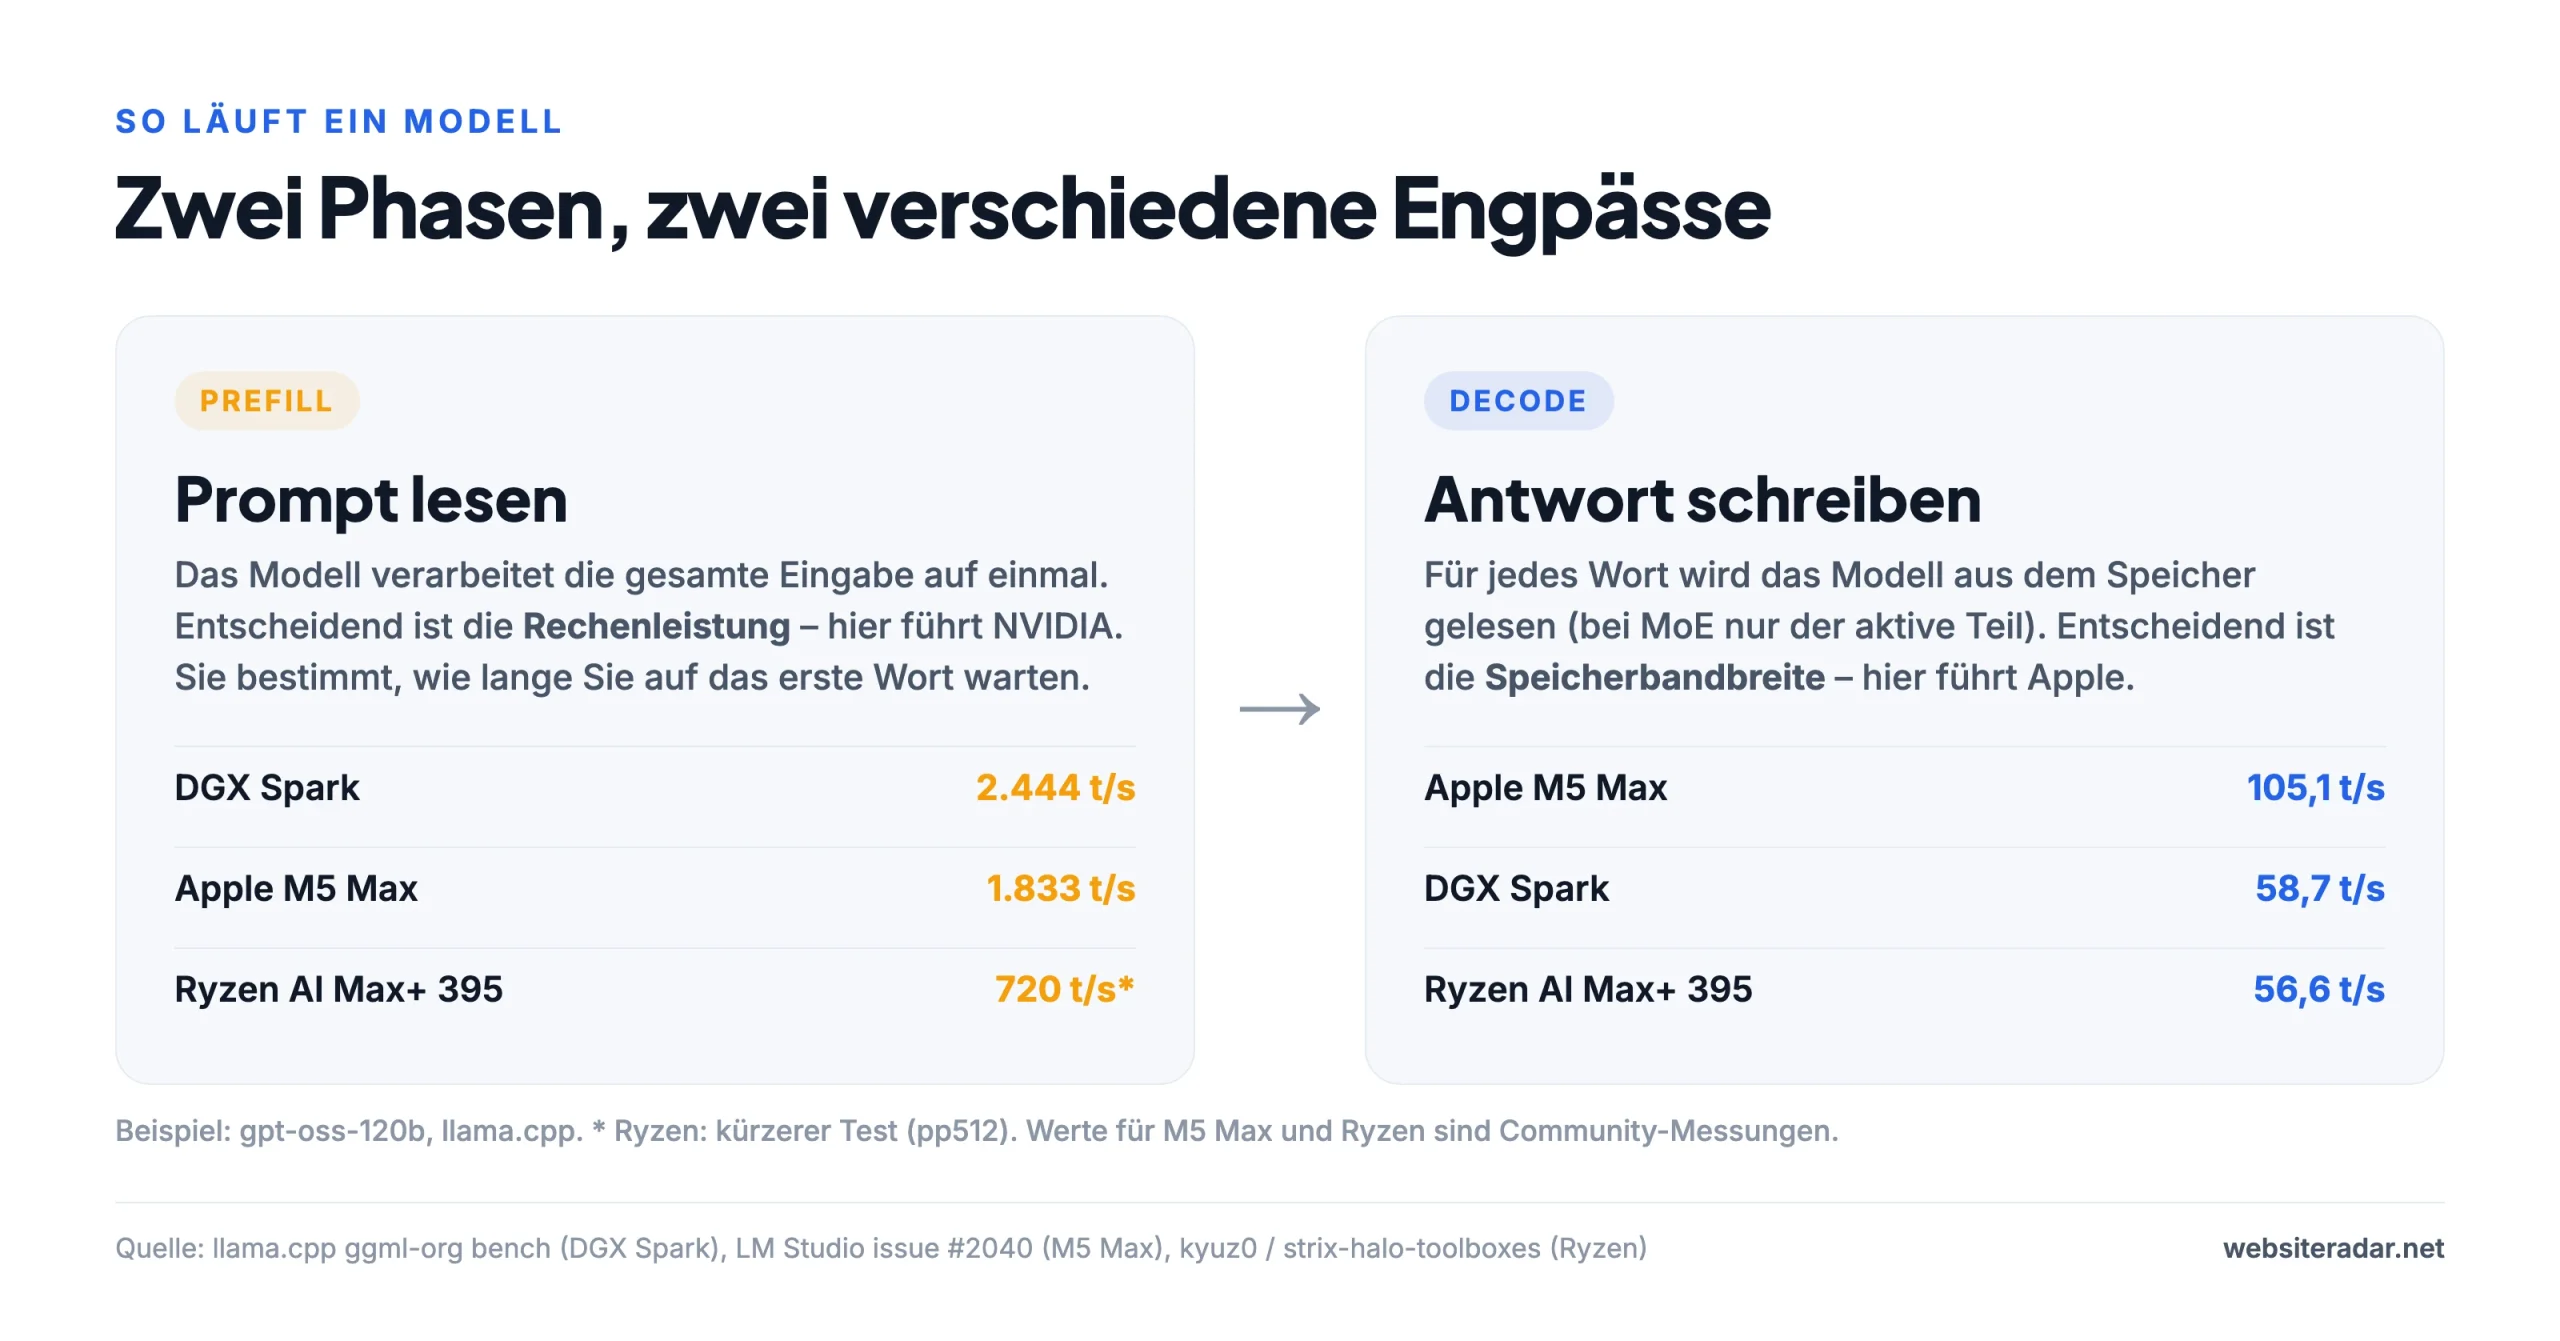
Der praktische Unterschied: Im Chat spüren Sie vor allem die schnelle Ausgabe (hier glänzt der Mac). Bei Coding-Agenten und der Arbeit mit Dokumenten, die dem Modell ständig riesige Mengen Kontext schicken, zählt schnelles Prompt-Lesen genauso viel (und da führt NVIDIA). Die Geschwindigkeit wird in Token pro Sekunde gemessen – ein Token entspricht ungefähr drei Vierteln eines Wortes. Rund 15 Token pro Sekunde entsprechen der Lesegeschwindigkeit, ab 50 wirkt das Modell flott.
Wie viel Speicher Sie brauchen
Das gesamte Modell muss in schnellem Speicher liegen, auf den die GPU zugreifen kann: entweder im VRAM der Grafikkarte oder im gemeinsamen Speicher (Unified Memory), wie ihn Macs, der DGX Spark oder der Ryzen AI Max haben. Passt es nicht hinein, landet ein Teil im normalen Arbeitsspeicher, und die Geschwindigkeit bricht ein. In einem Test auf einer RTX 5060 Ti senkte die Auslagerung von nur einem Sechstel der Schichten von Qwen 14B die Ausgabegeschwindigkeit von 43 auf 12,5 Token pro Sekunde; allein auf der CPU waren es 2,9.

| Modell | Typ | Größe (4 Bit) | Passt in |
|---|---|---|---|
| Llama 3.1 8B / Qwen3 8B | dicht | 4,9–5,0 GB | alles mit 8 GB |
| Qwen3 14B | dicht | 9,0 GB | 12–16 GB |
| gpt-oss-20b | MoE | 12,1 GB (MXFP4) | 16 GB |
| Gemma 3 27B | dicht | 16,6 GB | 24 GB |
| Qwen3 30B-A3B | MoE, 3B aktiv | 18,6 GB | 24 GB |
| Qwen3 32B | dicht | 19,8 GB | 24–32 GB |
| Llama 3.3 70B | dicht | 42,5 GB | ab 48 GB |
| gpt-oss-120b | MoE | 63,4 GB (MXFP4) | 96–128 GB |
| GLM-4.5-Air 106B | MoE | 73,0 GB | ab 96 GB |
| Qwen3.5 122B-A10B | MoE | 76,5 GB | 96–128 GB |
| Qwen3 235B-A22B | MoE | 142,2 GB | 192–256 GB |
| DeepSeek R1 671B | MoE | 404,9 GB | 512 GB |
Auch der Kontext braucht Speicher
Zusätzlich zum Modell selbst brauchen Sie Speicher für den Kontext (den KV-Cache) – alles, was sich das Modell aus der Unterhaltung oder dem Dokument „merkt“. Bei Llama 3.3 70B sind das bei 32.000 Token Kontext etwa 10 GB zusätzlich, bei 128.000 Token rund 40 GB. Die gpt-oss-Modelle sind dank eines gleitenden Fensters (Sliding Window) weit genügsamer: gpt-oss-120b braucht selbst für 128.000 Token höchstens etwa 9 GB. Mit wachsendem Kontext sinkt zudem die Ausgabegeschwindigkeit – gpt-oss-120b schreibt auf einem M5 Max mit kurzem Kontext etwa 80 Token pro Sekunde, bei 128.000 Token nur noch 14.
Nicht der ganze Speicher steht der GPU zur Verfügung
- macOS lässt die GPU standardmäßig etwa 75 % des RAM nutzen (Apple veröffentlicht den genauen Wert nicht). Ein Mac mit 64 GB bietet dem Modell also rund 48 GB, ein Mac mit 128 GB etwa 96 GB. Mit
sudo sysctl iogpu.wired_limit_mb=…lässt sich das Limit anheben, nach einem Neustart gilt aber wieder der Standardwert. - Windows auf dem Ryzen AI Max teilt den Speicher im BIOS in einem festen Verhältnis auf – die GPU erhält höchstens 96 von 128 GB. Unter Linux sind bis zu etwa 124 GB möglich.
- Notebooks mit NVIDIA RTX Spark teilen den Speicher unter Windows standardmäßig etwa 50:50 auf, manuell eingestellt sind höchstens 96 von 128 GB möglich. Die 32-GB-Version gibt der GPU nur 16 GB.
- DGX Spark weist den Speicher unter Linux dynamisch zu, sodass das Modell den Großteil der 128 GB nutzen kann.
Quantisierung und MoE einfach erklärt
Quantisierung ist Kompression für Modelle: Statt 16 Bit pro Parameter verwenden Sie 8 oder 4. Bei 4 Bit (bezeichnet als Q4, Q4_K_M oder MXFP4) belegt ein Modell etwa ein Viertel seiner ursprünglichen Größe, und die Qualität sinkt nur leicht – eine vernünftige Standardwahl für den Heimgebrauch. Acht Bit (Q8) sind nahezu verlustfrei, aber doppelt so groß.
Mixture of Experts (MoE) ist eine Architektur, bei der das Modell sehr viele Parameter hat, für jedes Wort aber nur einen kleinen Teil davon nutzt. gpt-oss-120b hat 117 Milliarden Parameter, aktiviert pro Schritt aber nur etwa fünf Milliarden, Qwen3 30B-A3B gerade einmal drei Milliarden. Ein solches Modell braucht viel Speicher, schreibt aber so schnell wie ein deutlich kleineres. Damit sind MoE-Modelle ideal für Rechner mit großem, aber langsamerem gemeinsamem Speicher – DGX Spark, Ryzen AI Max oder Macs. Dichte Modelle (Llama 70B, Qwen3 32B) lesen dagegen für jedes Wort das gesamte Modell und kriechen auf langsamem Speicher dahin.
Speicherbandbreite: Warum ein Mac schneller schreibt als ein Spark
Die Ausgabegeschwindigkeit lässt sich recht gut abschätzen: Speicherbandbreite geteilt durch die Datenmenge, die das Modell pro Token lesen muss. Ein dichtes 70B-Modell bei 4 Bit (~42 GB) kann auf einem DGX Spark mit 273 GB/s daher nicht schneller als etwa 6–7 Token pro Sekunde schreiben – gemessen werden rund 4,4.
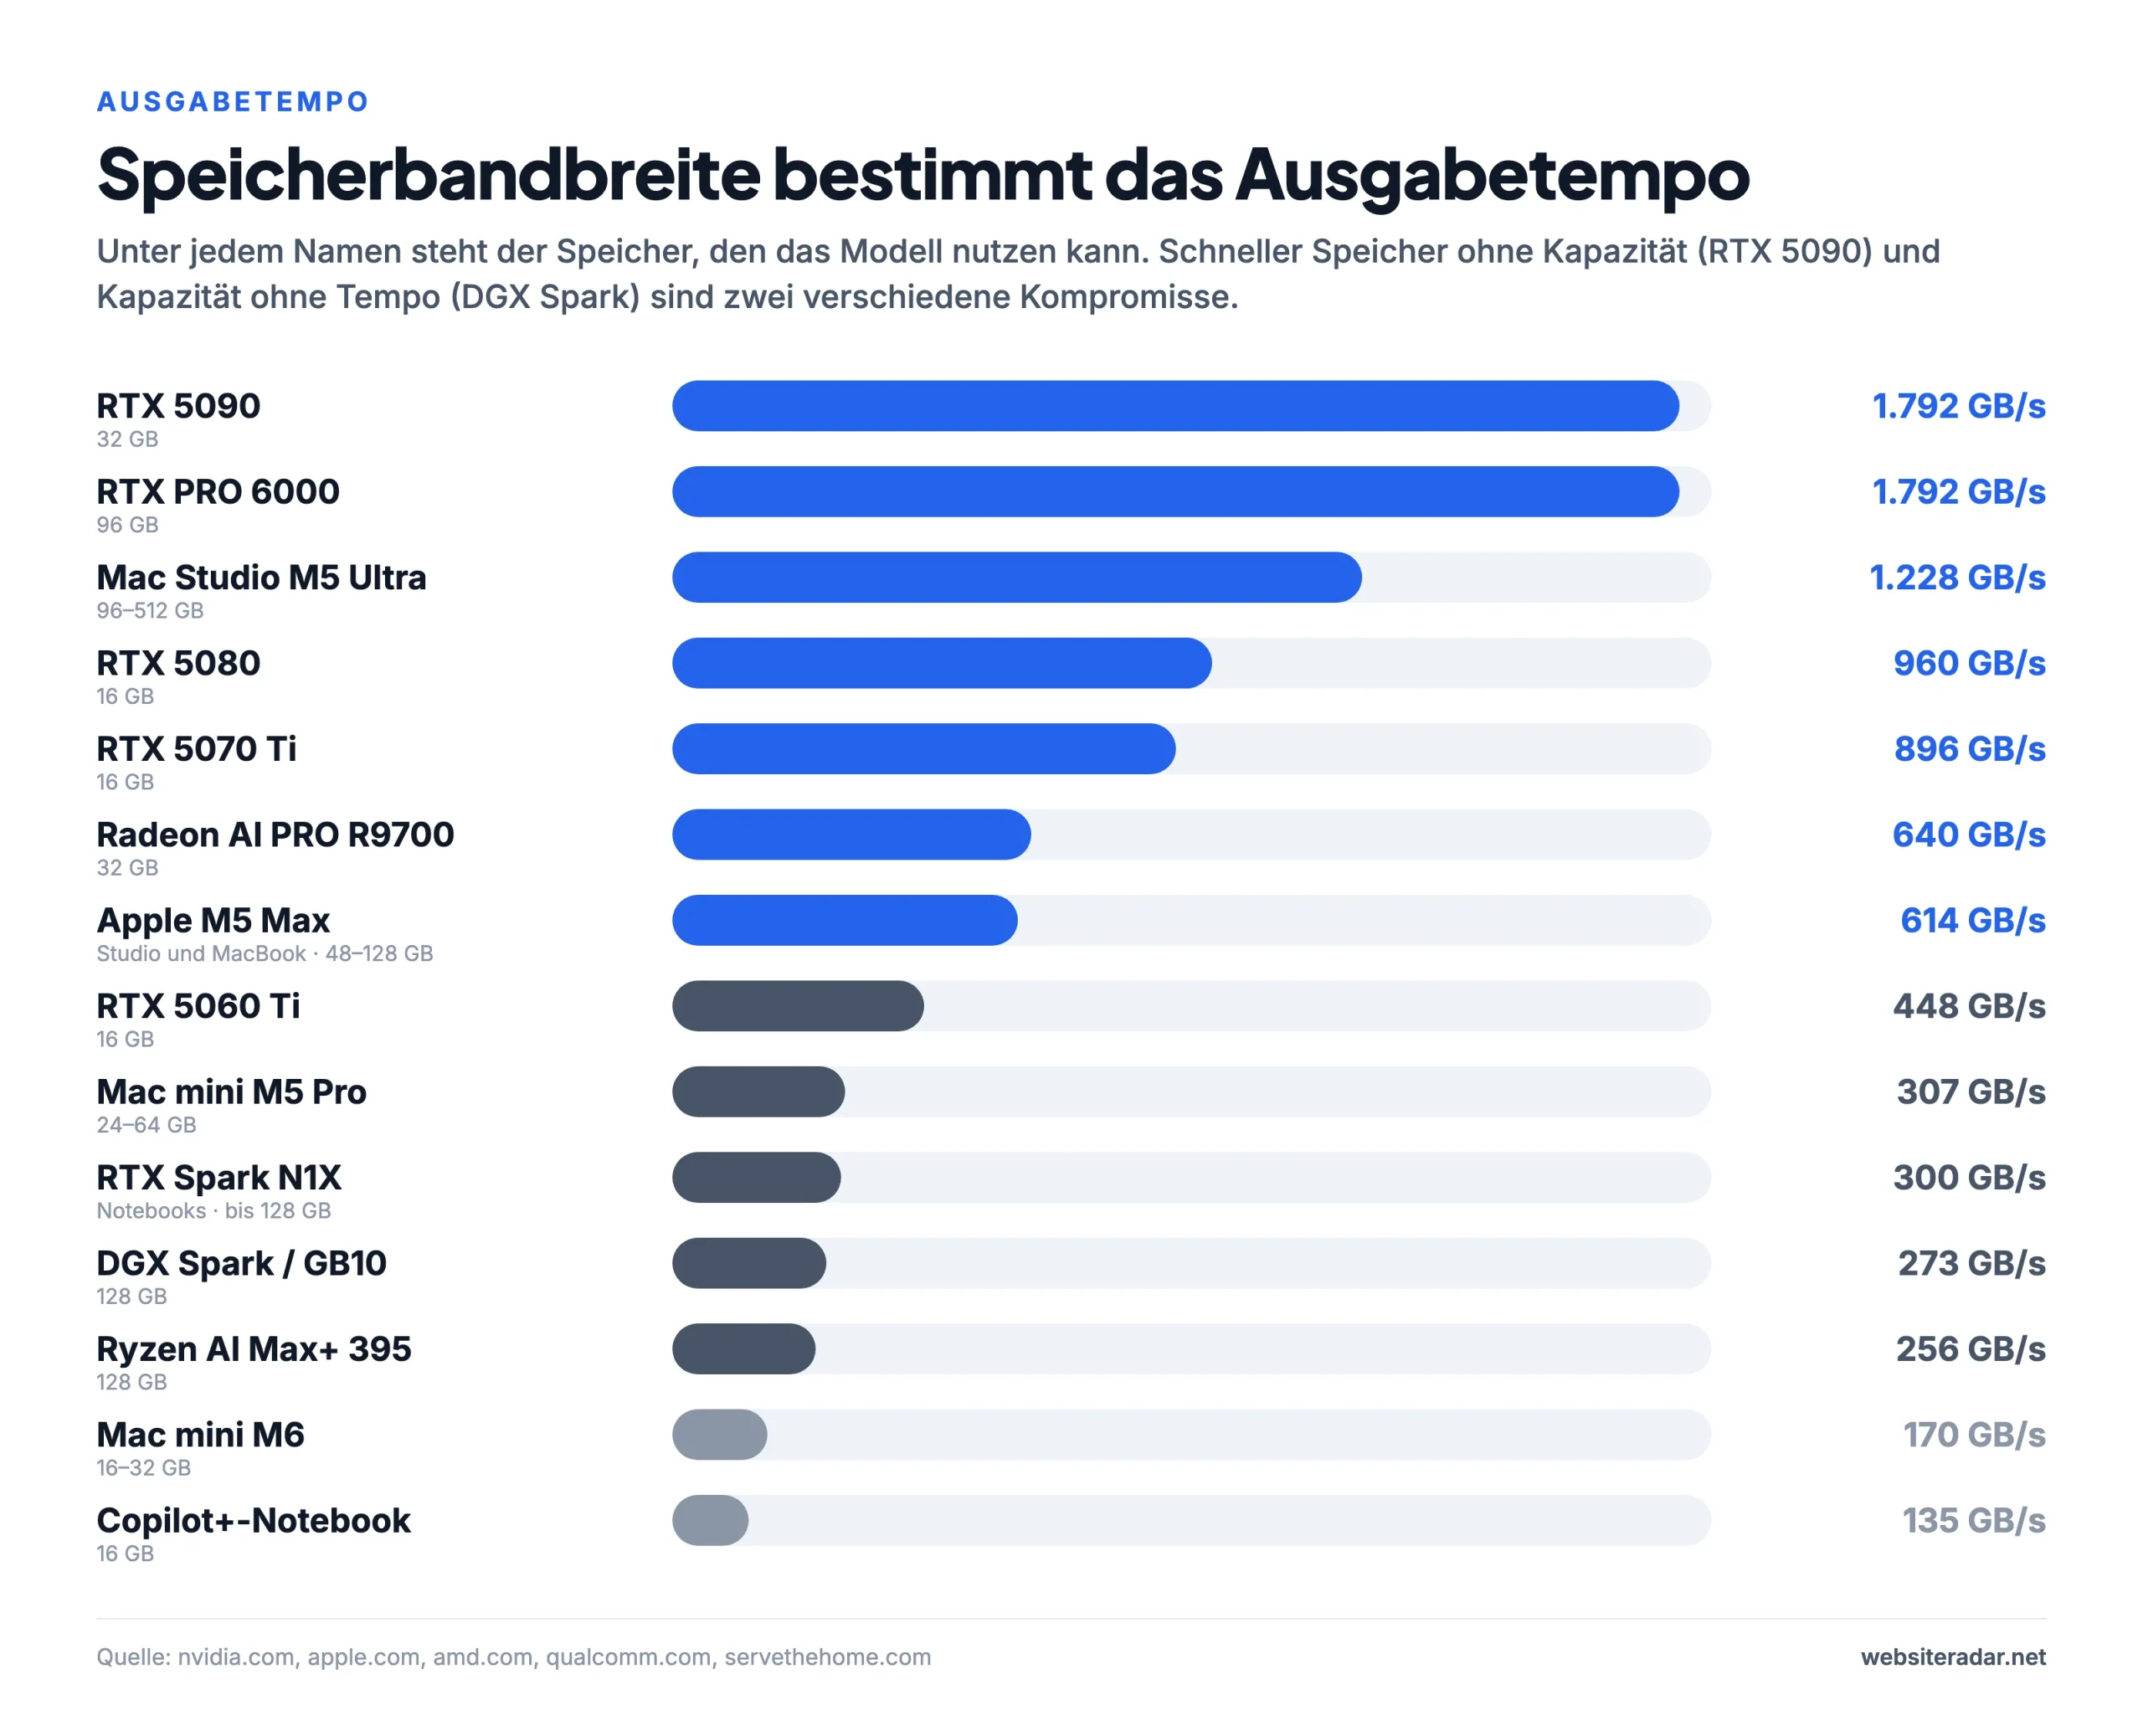
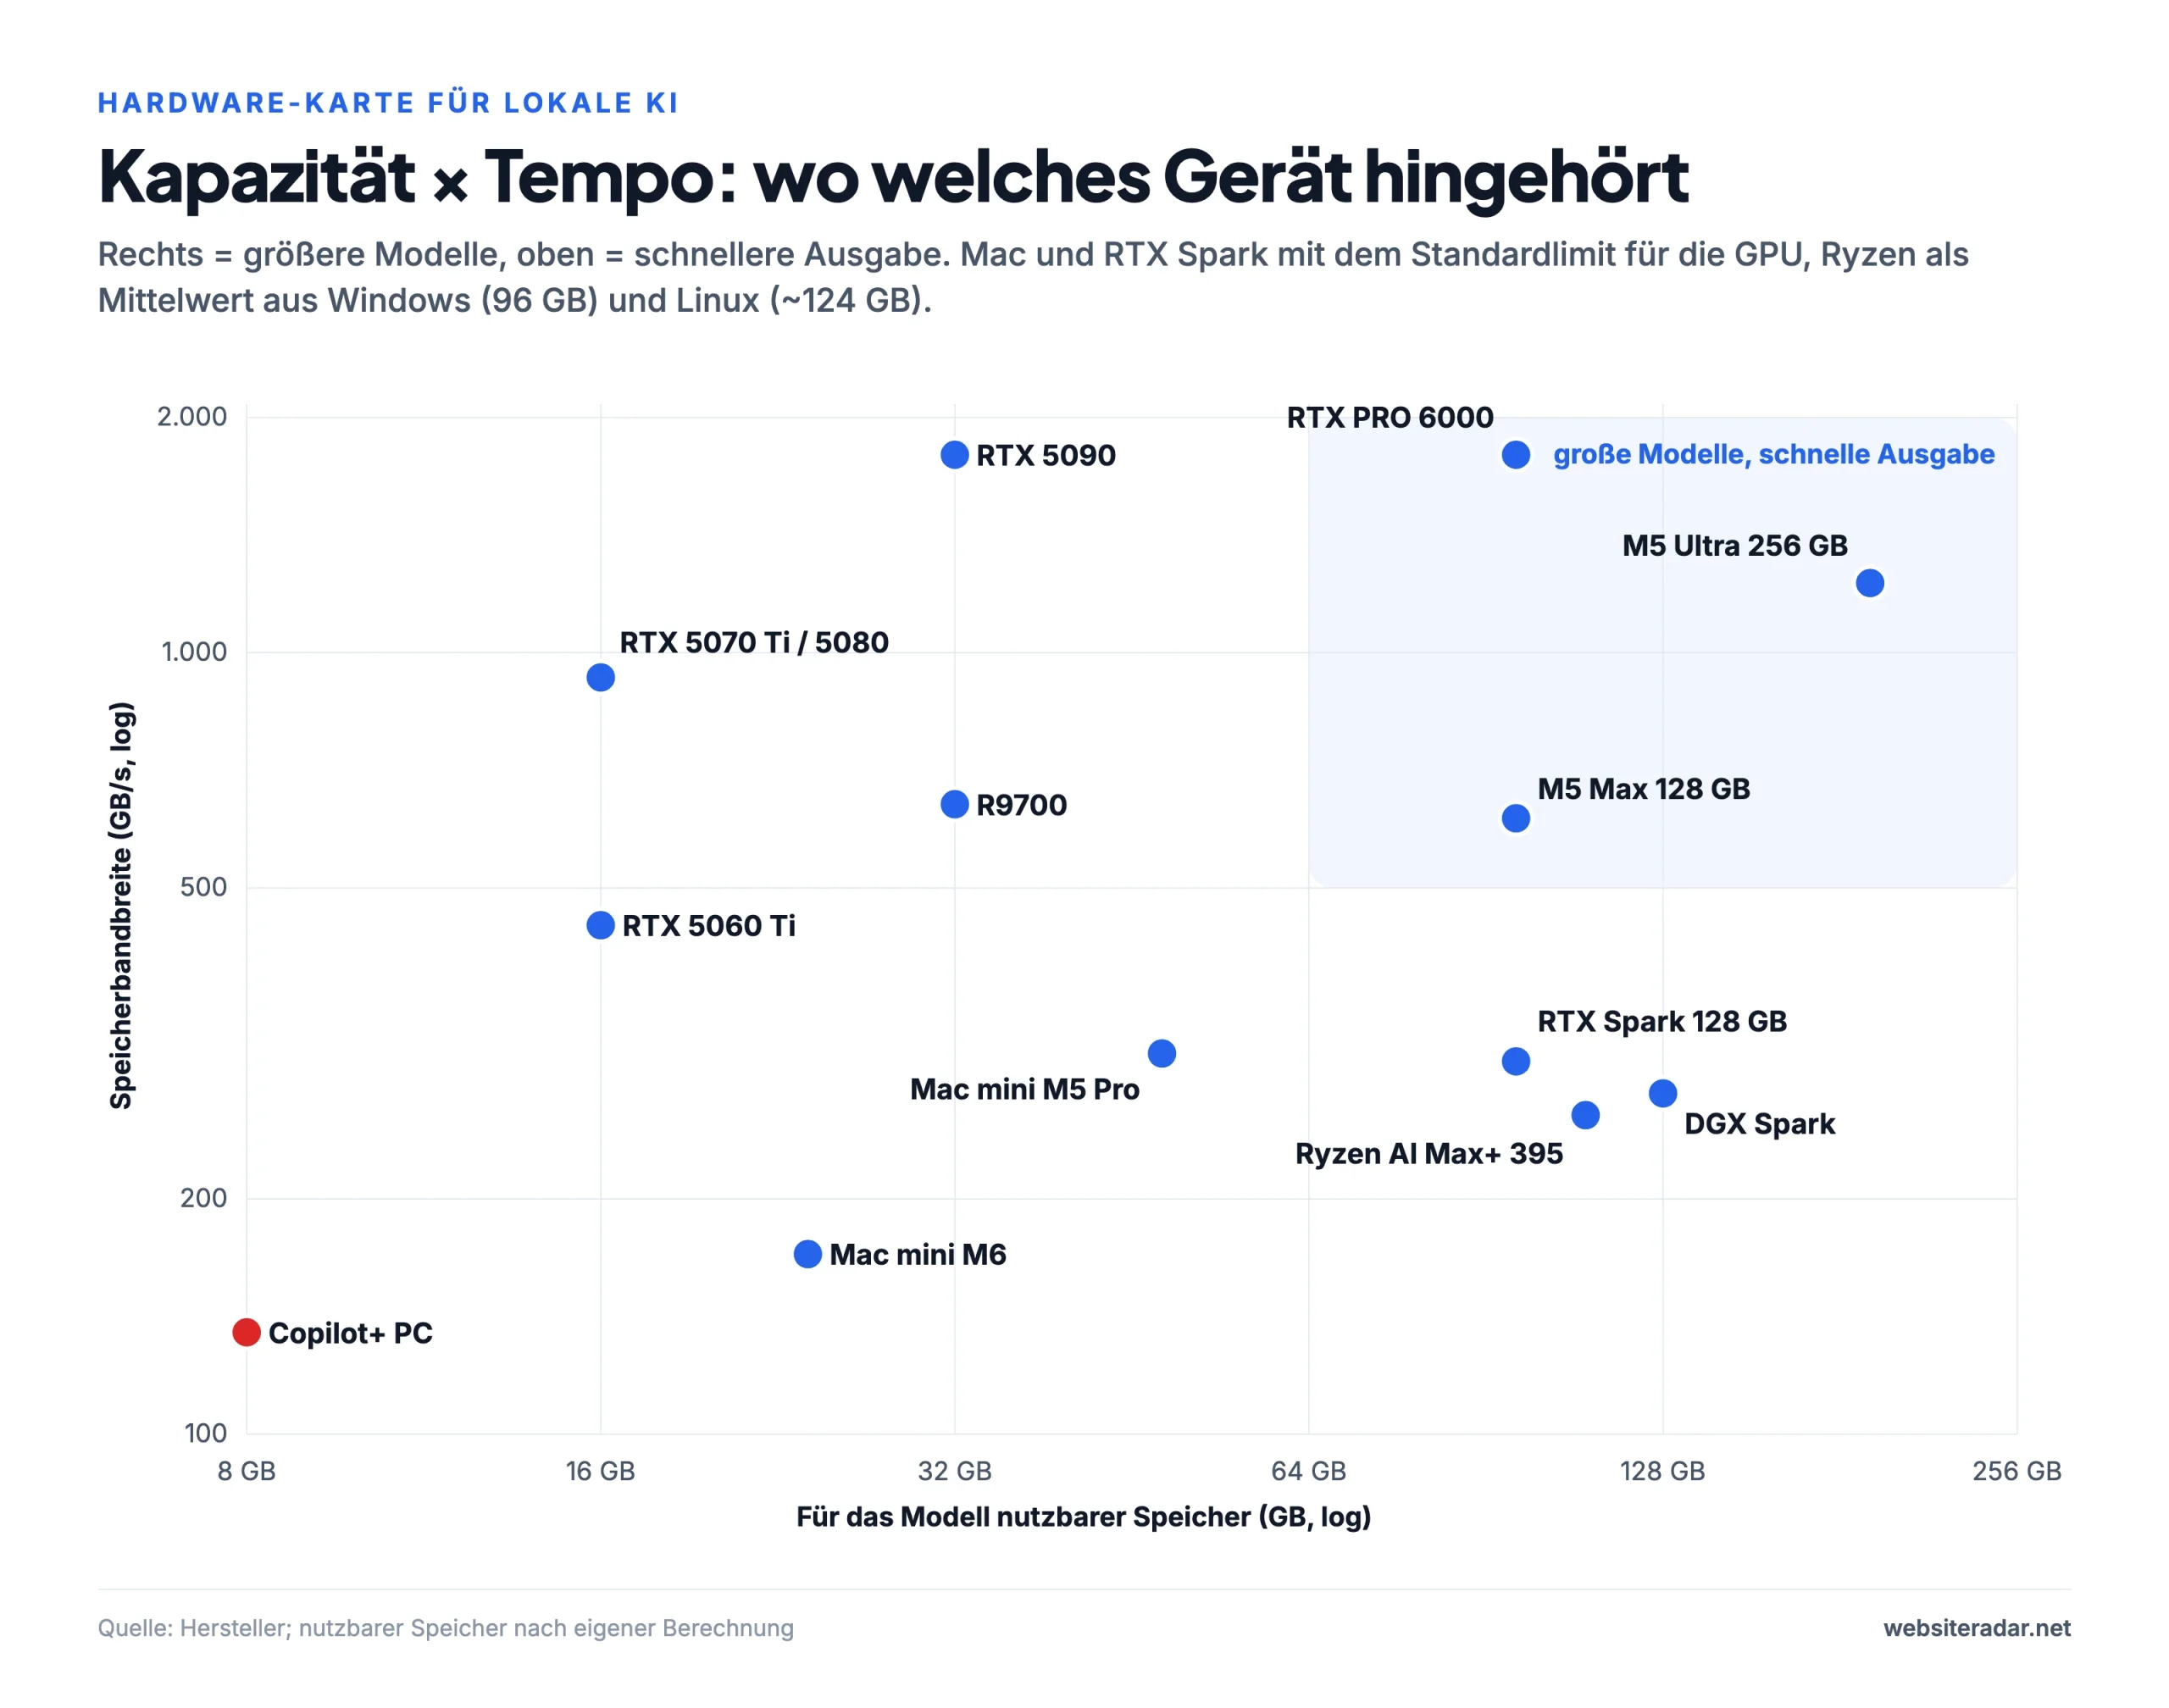
Die Karte zeigt deutlich, dass es kein perfektes Gerät gibt. NVIDIA-Grafikkarten haben den schnellsten Speicher, aber wenig Kapazität. DGX Spark, Ryzen AI Max und RTX Spark bieten viel Kapazität, aber langsameren Speicher. Der Mac Studio mit M5 Max – und vor allem mit M5 Ultra – vereint beides, um den Preis von fehlendem CUDA und langsamerem Prompt-Lesen als bei NVIDIA.
Gleiches Modell, unterschiedliche Hardware
Am fairsten ist der Vergleich mit demselben Modell im selben Programm. Wir haben OpenAIs gpt-oss-120b (63 GB) gewählt und Messungen aus llama.cpp, dem am weitesten verbreiteten Programm für lokale Modelle.

Alle Geräte im Vergleich
| Gerät | Speicher für KI | Bandbreite | gpt-oss-120b, Ausgabe |
|---|---|---|---|
| Mac Studio M5 Max | ~96 von 128 GB | 614 GB/s | 105 t/s¹ |
| NVIDIA DGX Spark | 128 GB | 273 GB/s | 58,7 t/s |
| RTX-Spark-Notebooks | bis 96 von 128 GB | bis 300 GB/s | – |
| Ryzen AI Max+ 395 | 96 GB (Windows) / ~124 GB (Linux) | 256 GB/s | 56,6 t/s |
| Mac Studio M5 Ultra | ~192 von 256 GB | 1.228 GB/s | – |
| Mac mini M5 Pro | ~48 von 64 GB | 307 GB/s | passt nicht |
| Mac mini M6 | ~24 von 32 GB | 170 GB/s | passt nicht |
| MacBook Pro M5 Max | ~96 von 128 GB | 614 GB/s | 105 t/s¹ |
| RTX 5090 | 32 GB | 1.792 GB/s | ~30 t/s² |
| RTX 5060 Ti 16 GB | 16 GB | 448 GB/s | passt nicht |
| RTX 5070 Ti / 5080 | 16 GB | 896 / 960 GB/s | passt nicht |
| RTX PRO 6000 Max-Q | 96 GB | 1.792 GB/s | 170,6 t/s |
| GB10 von ASUS, MSI, Lenovo … | 128 GB | 273 GB/s | ~ wie Spark |
| Radeon AI PRO R9700 | 32 GB | ~640 GB/s | passt nicht |
| Copilot+-Notebooks | ~8 von 16 GB | ~135 GB/s | passt nicht |
¹ Community-Messung auf einem MacBook Pro M5 Max mit 128 GB, llama.cpp. ² Teil des Modells in den Arbeitsspeicher ausgelagert.
1. Mac Studio M5 Max – die schnellste Ausgabe fürs Geld
Der Mac Studio mit M5-Max-Chip ist derzeit die vernünftigste Wahl für alle, die einen möglichst schnellen lokalen Chat oder Agenten wollen und kein CUDA brauchen. Mit 614 GB/s Speicherbandbreite bringt die 128-GB-Version gpt-oss-120b auf über 100 Token pro Sekunde – fast doppelt so schnell wie ein DGX Spark. Die neuen neuronalen Beschleuniger in jedem GPU-Kern haben auch das Prompt-Lesen beschleunigt, allerdings nur mit aktueller Software (siehe Software).
- Speicher: 36, 48, 64 oder 128 GB · Bandbreite 460 GB/s (36 GB) / 614 GB/s
- Leistungsaufnahme: 7 W im Leerlauf, maximal 200 W
- Anschlüsse: 4× Thunderbolt 5, 10GbE
- Achtung: Die 36-GB-Version hat eine schwächere GPU mit 32 Kernen und lässt dem Modell nur etwa 27 GB. Ab 48 GB erhalten Sie den vollen Chip.
- Listenpreis in den USA: ab 2.499 US-Dollar (Grundkonfiguration, August 2026)
Geeignet für: Chat und Agenten mit MoE-Modellen, einen leisen KI-Heimserver, alle, die auch Videos schneiden. Nicht geeignet für: alle, die CUDA, vLLM oder Training brauchen.
2. NVIDIA DGX Spark – eine Entwickler-Workstation, keine Chat-Box
Der GB10-Chip mit 128 GB gemeinsamem Speicher und dem kompletten Software-Stack von NVIDIA (CUDA, vLLM, TensorRT-LLM) in einem Gehäuse von 15 × 15 cm. Er liest Prompts schneller als jeder andere kleine Rechner – 2.444 Token pro Sekunde bei gpt-oss-120b –, schreibt mit 273 GB/s Bandbreite aber langsamer als ein Mac: 58,7 Token pro Sekunde und beim dichten Llama 70B nur 4,4. Während ein Modell läuft, zieht er 60–90 W, und zwei Geräte lassen sich per QSFP-Kabel für Modelle mit bis zu rund 400 Milliarden Parametern koppeln.
- Speicher: 128 GB LPDDR5x · Bandbreite 273 GB/s
- GPU: Blackwell, 6.144 CUDA-Kerne · KI-Leistung 1 PFLOP FP4 (mit Sparsity; in der Praxis etwa die Hälfte)
- Betriebssystem: DGX OS (Ubuntu auf Arm)
- Listenpreis in den USA: 3.999 US-Dollar zum Start (Oktober 2025), 4.699 US-Dollar ab Februar 2026; ServeTheHome berichtete im Oktober 2026 von einem Wechsel in eine Preisklasse um 6.950 US-Dollar
Geeignet für: CUDA-Entwicklung, Coding-Agenten mit großem Kontext, Fine-Tuning bis 70B. Nicht geeignet für: schnellen Chat mit dichten 70B-Modellen, Windows und Gaming, Einsteiger.
3. NVIDIA-RTX-Spark-Notebooks – 128 GB im Rucksack
Der N1X-Chip ist ein für Windows-Notebooks angepasster GB10 mit schnellerem Speicher (bis 300 GB/s) und einem Leistungsrahmen von 45–80 W. Im Test von The Register erreichte ein Notebook mit Qwen3.6 35B-A3B 67,6 Token pro Sekunde – mehr als der Desktop-DGX-Spark. Der Haken ist Windows: Die GPU erhält nur einen festen Teil des Speichers – höchstens 16 von 32 GB, 48 von 64 GB und 96 von 128 GB.
- Speicher: 32, 64 oder 128 GB · Bandbreite bis 300 GB/s
- GPU: Blackwell, 6.144 Kerne (Leistung etwa auf dem Niveau einer Notebook-RTX-5070)
- Betriebssystem: Windows 11 on Arm, CUDA ab Version 13.4
- Achtung: Die ersten Geräte (Surface, HP) stürzten in Tests nach Stunden unter Volllast ab; Linux wird offiziell nicht unterstützt
- Preis in den USA: von 2.599 US-Dollar (Surface Laptop Ultra mit 24 GB) bis 5.899,99 US-Dollar (Surface mit 128 GB), Oktober 2026
Geeignet für: große Modelle auf einem Windows-Notebook, Coding-Agenten, kreative Arbeit. Nicht geeignet für: die 32-GB-Version, lange Trainingsläufe, reine x86-Software.
4. Ryzen AI Max+ 395 – die günstigsten 128 GB
Mini-PCs mit dem 16-Kern-Ryzen und Radeon-8060S-Grafik teilen sich 128 GB Speicher. Die Ausgabegeschwindigkeit liegt auf dem Niveau des DGX Spark (gpt-oss-120b mit 56,6 Token pro Sekunde) zum etwa halben Preis, und die Geräte laufen mit Windows und Linux – und mit Spielen. Die Schwachstelle ist das Prompt-Lesen: Es ist zwei- bis dreimal langsamer als beim Spark und bricht bei langem Kontext ein – auf 146 Token pro Sekunde mit dem Vulkan-Treiber, 371 mit ROCm.
- Speicher: 128 GB LPDDR5x · Bandbreite 256 GB/s (~215 gemessen)
- Für die GPU: 96 GB unter Windows, ~124 GB unter Linux
- Software: Vulkan oder ROCm (gfx1151 wird seit 2026 offiziell unterstützt)
- HP Z2 Mini G1a ist teurer, aber eine zertifizierte Workstation mit ECC-Speicher und drei Jahren Garantie
- Preisbeispiel USA: Der Framework Desktop mit 128 GB startete bei 1.999 US-Dollar und kostet nach der Speicherpreiserhöhung 2026 nun 2.459 US-Dollar
Geeignet für: möglichst viel Speicher fürs Geld, große MoE-Modelle, Chat und Zusammenfassungen. Nicht geeignet für: Agenten mit riesigem Kontext, CUDA; für große Modelle auch nicht das Tablet ROG Flow Z13 mit 32–64 GB.
5. Mac Studio M5 Ultra – der Speicherkönig
Bis zu 512 GB Speicher und 1,2 TB/s Bandbreite. Im Test von MacStories las der M5 Ultra Prompts viermal so schnell wie der Vorgänger M3 Ultra und schrieb 50 % schneller. In die 256-GB-Version passt sogar Qwen3 235B. Mehrere Geräte lassen sich über Thunderbolt 5 und RDMA koppeln: Laut Apple betreiben vier M5 Ultra ein Modell mit 816 Milliarden Parametern mit 36,7 Token pro Sekunde.
- Speicher: 96, 256 oder 512 GB (512 GB kommt Ende Oktober) · Bandbreite 1.228 GB/s
- Leistungsaufnahme: 9 W im Leerlauf, rund 300 W, während ein Modell läuft
- Anschlüsse: 6× Thunderbolt 5
- Achtung: Der Speicher lässt sich nicht nachrüsten; im September betrug die Lieferzeit bis zu 18 Wochen
- Listenpreis in den USA: ab 5.499 US-Dollar (August 2026); der Schritt von 96 auf 256 GB kostet 4.000 US-Dollar mehr
Geeignet für: 100–250B-Modelle, Agenten mit langem Kontext, kleine Teams. Nicht geeignet für: Modelle bis 30B, CUDA, knappe Budgets.
6. Mac mini M5 Pro – der vernünftige Einstieg
Der günstigste Mac, auf dem wirklich brauchbare Modelle laufen. 307 GB/s Bandbreite, bis zu 64 GB Speicher und Thunderbolt 5. Dank der neuronalen Beschleuniger liest er Prompts etwa dreimal so schnell wie der Vorgänger M4 Pro. Die 64-GB-Version bewältigt Modelle bis 32 Milliarden Parameter mühelos; das dichte Llama 70B passt zwar hinein, schafft aber nur etwa 7 Token pro Sekunde, und gpt-oss-120b passt nicht.
- Speicher: 24, 48 oder 64 GB · Bandbreite 307 GB/s
- Leistungsaufnahme: 6 W im Leerlauf, maximal 145 W · im Leerlauf praktisch lautlos
- Listenpreis in den USA: ab 1.699 US-Dollar (Grundkonfiguration, August 2026)
Geeignet für: 20–35B-Modelle, einen leisen KI-Heimserver. Nicht geeignet für: gpt-oss-120b, dichte 70B-Modelle, die 24-GB-Version.
7. Mac mini M6 – günstig, aber nicht mit 16 GB
Der günstigste Mac mit neuronalen Beschleunigern. Bei 32 GB und 170 GB/s ist Schluss – die 16-GB-Version hat nur 153 GB/s und lässt dem Modell etwa 12 GB. Verglichen mit dem bisherigen Mac mini mit M4 liest er Prompts 4,5-mal so schnell und schreibt 50 % schneller, und das praktisch zum gleichen Preis – kaufen Sie das alte Modell also auch im Angebot nicht.
- Speicher: 16, 24 oder 32 GB (Maximum) · Bandbreite 153 / 170 GB/s
- Leistungsaufnahme: 4 W im Leerlauf, maximal 70 W
- Achtung: nur Thunderbolt 4, daher keine Kopplung mehrerer Geräte
- Listenpreis in den USA: ab 899 US-Dollar (Grundkonfiguration, August 2026)
Geeignet für: 7–14B-Modelle, gpt-oss-20b, Qwen3 30B-A3B. Nicht geeignet für: die 16-GB-Version, Modelle ab 70B.
8. MacBook Pro M5 Max – KI für unterwegs
Derselbe Chip wie im Mac Studio und damit dieselbe Geschwindigkeit: das schnellste Notebook für lokale Modelle. Mit dem mittelgroßen Qwen3.6 35B-A3B erzeugt es über 90 Token pro Sekunde. Die 14-Zoll-Version drosselt allerdings unter Dauerlast (von 96 auf 42 W), und die Ladeleistung ist auf 97 W begrenzt. Ein Mac Studio mit demselben Chip und 128 GB ist deutlich günstiger.
- Speicher: 36, 48, 64 oder 128 GB · Bandbreite 460 / 614 GB/s
- Akku: 72,4 Wh (14″) / 100 Wh (16″)
- Listenpreis in den USA: ab 3.599 US-Dollar (14″) und 3.899 US-Dollar (16″), März 2026; der Schritt von 64 auf 128 GB kostet 1.000 US-Dollar mehr
Geeignet für: alle, die unterwegs große Modelle brauchen, idealerweise das 16-Zoll-Modell mit 64–128 GB. Nicht geeignet für: die 36-GB-Version, Dauerlast rund um die Uhr, alle, die ohnehin am Schreibtisch arbeiten.
9. RTX 5090 – die schnellste, aber nur 32 GB
Mit 1.792 GB/s Bandbreite schreibt gpt-oss-20b fast 300 Token pro Sekunde, und die Karte liest einen langen Prompt etwa doppelt so schnell wie ein Mac Studio mit M5 Ultra. In 32 GB passen Modelle bis etwa 32 Milliarden Parameter bei 4 Bit, auch mit langem Kontext; ein Modell mit 70 Milliarden Parametern passt nicht. Große MoE-Modelle lassen sich teilweise in den Arbeitsspeicher auslagern – gpt-oss-120b läuft dann mit etwa 30 Token pro Sekunde.
- Speicher: 32 GB GDDR7 · Bandbreite 1.792 GB/s
- Leistungsaufnahme: 575 W, empfohlen ist ein 1.000-W-Netzteil
- Listenpreis in den USA: 1.999 US-Dollar zum Start (Januar 2025); die Straßenpreise liegen 2026 wegen der Speicherknappheit weit darüber
Geeignet für: Coding-Agenten und RAG mit Modellen bis 32B, CUDA-Entwicklung, Gaming. Nicht geeignet für: Modelle ab 70B, einen leisen, sparsamen Server.
10. RTX 5060 Ti 16 GB – der günstigste sinnvolle Einstieg
Die günstigste neue Grafikkarte mit 16 GB. Sie bringt gpt-oss-20b auf etwa 92 Token pro Sekunde, Qwen3 8B auf 69 und Qwen3 14B auf 41 – schneller, als Sie lesen können. Ihre Speicherbandbreite ist allerdings nur halb so hoch wie die der RTX 5070 Ti, sie schreibt also etwa halb so schnell, und Modelle um 30 Milliarden Parameter passen nicht in 16 GB.
- Speicher: 16 GB GDDR7 · Bandbreite 448 GB/s
- Leistungsaufnahme: 180 W, ein 600-W-Netzteil genügt
- Listenpreis in den USA: 429 US-Dollar für die 16-GB-Version zum Start (April 2025)
Geeignet für: erste ernsthafte Experimente, 8–20B-Modelle, einen günstigen KI-PC. Nicht geeignet für: Modelle ab 27B.
11. RTX 5070 Ti vs. RTX 5080 – für KI nahezu identisch
Beide Karten haben 16 GB und fast dieselbe Bandbreite (896 vs. 960 GB/s) und schreiben daher nahezu gleich schnell: 182,4 vs. 184,7 Token pro Sekunde im Standardtest von llama.cpp und 74 vs. 81 bei Qwen3 14B. In beide passen exakt dieselben Modelle. Die 5080 ist vor allem in Spielen schneller – und ihr Startpreis lag 250 US-Dollar höher (999 vs. 749 US-Dollar).
Unser Rat: Nehmen Sie für KI die RTX 5070 Ti und stecken Sie das gesparte Geld in eine größere SSD oder mehr RAM. Zur RTX 5080 greifen Sie nur, wenn Gaming im Vordergrund steht.
12. RTX PRO 6000 – 96 GB auf einer Karte
Die einzige Karte, in die Llama 3.3 70B (32 Token pro Sekunde), gpt-oss-120b (170,6 Token pro Sekunde in der Max-Q-Version) und Qwen3.5 122B (etwa 98 Token pro Sekunde) komplett passen. Dank CUDA und vLLM kann sie mehrere Nutzer gleichzeitig bedienen. Sie ist als einzelne Karte oder in einer fertig konfigurierten Workstation erhältlich.
- Speicher: 96 GB GDDR7 mit ECC · Bandbreite 1.792 GB/s
- Leistungsaufnahme: 300 W (Max-Q); die volle 600-W-Version schreibt etwa 13 % schneller
- Listenpreis in den USA: 8.565 US-Dollar zum Start; NVIDIA hob ihn später auf 13.250 US-Dollar an
Geeignet für: Unternehmen und Teams, die große Modelle im eigenen Haus betreiben oder trainieren wollen. Nicht geeignet für: Privatanwender und Hobbyisten.
13. DGX Spark von ASUS, MSI, Lenovo, Dell und Gigabyte – welcher soll es sein?
Fünf weitere Hersteller verkaufen denselben GB10-Chip wie der DGX Spark. Die KI-Leistung unterscheidet sich nur um wenige Prozent; die Unterschiede liegen bei Massenspeicher, Netzteil, Kühlung und Support – und beim Preis.
| Modell | Massenspeicher | Netzteil | Besonderheit |
|---|---|---|---|
| NVIDIA / PNY DGX Spark | 4 TB, selbstverschlüsselnd | 240 W | das Original |
| GIGABYTE AI TOP ATOM | 4 TB PCIe 5.0 | 240 W | schnellste SSD |
| ASUS Ascent GX10 | 1 TB PCIe 4.0 / 4 TB PCIe 5.0 | 240 W | Einschalter vorn |
| Lenovo ThinkStation PGX | 1 / 2 / 4 TB, selbstverschlüsselnd | 240 W | ein Jahr Vor-Ort-Service |
| Dell Pro Max with GB10 | PCIe 4.0 (2 TB ist QLC) | 280 W | stärkeres Netzteil, heißeste SSD |
| MSI EdgeXpert | 4 TB | – | neu, noch keine unabhängigen Tests |
Unser Rat: Die beste Ausstattung für vernünftiges Geld bietet der Gigabyte AI TOP ATOM mit 4 TB schnellem Massenspeicher; der günstigste bewährte Einstieg ist der ASUS Ascent GX10 mit 1 TB, der in den USA für etwa 3.000 US-Dollar startete. Wer zwei Geräte koppeln will, braucht ein QSFP-Kabel. Neu seit dem 23. Oktober 2026: eine 64-GB-Version des GB10, die nur die Partnermarken verkaufen, ab 4.999 US-Dollar.
14. Radeon AI PRO R9700 – 32 GB zum Bruchteil einer RTX 5090
Die günstigste neue Karte mit 32 GB. Im selben Vulkan-Test schreibt sie etwa 40 % langsamer als die RTX 5090, fasst aber dieselben Modelle – rund 30 Milliarden Parameter, auch mit längerem Kontext. gpt-oss-20b und Qwen3 30B-A3B laufen darauf mit über 150 Token pro Sekunde. Vorsicht beim Marketing: „Bis zu fünfmal schneller als die RTX 5080“ gilt nur für ein Modell, das nicht in 16 GB passt.
- Speicher: 32 GB GDDR6 · Bandbreite ~640 GB/s · Leistungsaufnahme 300 W
- Software: Vulkan (meist schnellere Ausgabe) oder ROCm (schnelleres Prompt-Lesen); kein CUDA
- Listenpreis in den USA: 1.299 US-Dollar (Oktober 2025)
Geeignet für: 27–32B-Modelle mit langem Kontext, mehrere Karten in einem PC. Nicht geeignet für: reine CUDA-Werkzeuge, maximale Geschwindigkeit.
15. „KI-PCs“ und Copilot+-Notebooks – ein Mythos
Copilot+ ist Microsofts Zertifizierung für Windows-Funktionen – Kameraeffekte, Live-Untertitel, Recall oder das kleine integrierte Modell Phi Silica. Über die Fähigkeit, große Sprachmodelle auszuführen, sagt sie nichts aus. Weder Ollama noch LM Studio nutzen die Neural Processing Unit (NPU), llama.cpp nur experimentell; die NPU nutzen lediglich Herstellerwerkzeuge wie Microsoft Foundry Local oder AMD Lemonade mit ausgewählten Modellen.

Hinzu kommt, dass diese Notebooks Speicher mit rund 135 GB/s Bandbreite und 16 GB RAM haben, was etwa 8 GB für das Modell übrig lässt. Sie taugen für Modelle bis 4 Milliarden Parameter und Windows-Funktionen – nicht für das „eigene ChatGPT zu Hause“.
Geeignet für: Büroarbeit, lange Akkulaufzeit, kleine 1–4B-Modelle. Nicht geeignet für: alle, die Modelle ab 14B betreiben wollen.
Stromverbrauch und Betriebskosten
Soll der Rechner rund um die Uhr als KI-Heimserver laufen, zählen auch Stromverbrauch und Lautstärke.
| Gerät | Leerlauf | Modell läuft / Maximum | Hinweis |
|---|---|---|---|
| Mac mini M6 | 4 W | max. 70 W | praktisch lautlos |
| Mac mini M5 Pro | 6 W | max. 145 W | 5 dBA im Leerlauf (Apple) |
| Mac Studio M5 Max | 7 W | max. 200 W | leise |
| Mac Studio M5 Ultra | 9 W | ~300 W mit KI-Last | laut Tests leise |
| DGX Spark | 25–45 W | 60–90 W mit KI-Last, Spitzen bis 200 W | abhängig von der Firmware-Version |
| Mini-PC mit Ryzen AI Max+ 395 | ~13 W | 120–160 W | HP Z2 Mini unter Last laut |
| RTX 5090 (nur Karte) | – | bis 575 W | plus restlicher PC |
| RTX 5060 Ti (nur Karte) | – | bis 180 W |
Die Werte stammen von Herstellern und aus Tests (ServeTheHome, Tom’s Hardware, Notebookcheck) und wurden nicht mit derselben Methode ermittelt – verstehen Sie sie als Richtwerte.
Software: Womit Sie das Modell betreiben
- Ollama – der einfachste Einstieg auf jeder Plattform; ein Modell laden Sie mit einem einzigen Befehl herunter. Auf dem Mac nutzt es ab Version 0.19 (noch als Vorschau, für ausgewählte Modelle) MLX und die neuronalen Beschleuniger des M5.
- LM Studio – eine übersichtliche App mit grafischer Oberfläche. Tipp für Macs mit M5: Mit GGUF-Modellen nutzt es die neuronalen Beschleuniger noch nicht und liest Prompts nur etwa halb so schnell; verwenden Sie stattdessen Modelle im MLX-Format.
- llama.cpp – die Grundlage der meisten anderen Werkzeuge, mit den meisten Einstellungen und der schnellsten Unterstützung neuer Hardware. Auf dem Ryzen AI Max lohnt es sich, beide Backends auszuprobieren: Vulkan schreibt meist schneller, ROCm liest lange Prompts schneller.
- MLX – Apples Bibliothek mit der besten Leistung auf dem Mac, einschließlich der Kopplung mehrerer Macs über Thunderbolt 5.
- vLLM, SGLang, TensorRT-LLM – Server-Werkzeuge für NVIDIA, wenn ein Modell mehrere Nutzer gleichzeitig bedient.
Die häufigsten Fehler beim Kauf
- Ein Mac mit 36 GB „für KI“. Er hat einen schwächeren Chip und lässt dem Modell nur etwa 27 GB.
- Ein RTX-Spark-Notebook mit 32 GB. Windows gibt der GPU höchstens 16 GB.
- Ein Mac mini M6 mit 16 GB. Langsamerer Speicher und nur etwa 12 GB für das Modell.
- Ein Copilot+-Notebook für lokale KI. Gängige Werkzeuge nutzen die NPU nicht.
- Eine RTX 5080 statt einer 5070 Ti nur für KI. Dieselben 16 GB, fast dieselbe Geschwindigkeit.
- Die Speicherbandbreite ignorieren. Großer, aber langsamer Speicher bedeutet langsame Ausgabe bei dichten Modellen.
- Am Speicher sparen. Bei Macs, Ryzen AI Max und RTX Spark ist der Speicher verlötet und lässt sich nicht nachrüsten.
Häufige Fragen
Reichen 16 GB für lokale KI? Für Modelle bis 14–20 Milliarden Parameter ja – etwa gpt-oss-20b oder Qwen3 14B. Modelle um 30 Milliarden brauchen 24–32 GB, für 70 Milliarden sind mindestens 48 GB nötig.
Mac oder NVIDIA? Ein Mac schreibt schneller und bietet mehr Speicher fürs Geld; NVIDIA liest Prompts schneller und hat CUDA. Bei Chat und Agenten mit MoE-Modellen liegt der Mac vorn, bei Entwicklung, Training und dem Betrieb für mehrere Nutzer NVIDIA.
Was bedeutet „MoE“? Mixture of Experts: Das Modell hat viele Parameter, nutzt für jedes Wort aber nur einen kleinen Teil davon. Es braucht viel Speicher, schreibt aber so schnell wie ein kleineres Modell.
Wie schnell muss ein Modell schreiben? Etwa 15 Token pro Sekunde entsprechen der Lesegeschwindigkeit. Für flüssigen Chat sind 30 oder mehr angenehm, für Coding-Agenten, die viel Text erzeugen, sind 50 oder mehr besser.
Ist lokale KI günstiger als ein Abo? Meist nicht – Modelle, die mit den besten Cloud-Diensten vergleichbar sind, brauchen Rechner für viele Tausend Dollar. Die Hauptgründe sind Datenschutz, Kontrolle über die eigenen Daten und Unabhängigkeit.
Kann ich mehrere Rechner koppeln? Ja. Zwei DGX Spark verbinden Sie per QSFP-Kabel, Macs über Thunderbolt 5 mit RDMA (mit MLX oder exo). Der Mac mini M6 kann das nicht, weil er nur Thunderbolt 4 hat.
So haben wir verglichen – und die Quellen
Wir haben die Geräte nicht selbst getestet. Die Zahlen stammen aus geprüften Quellen, die wir in den Grafiken stets angeben. Die Geschwindigkeit vergleichen wir in einem einzigen Programm (llama.cpp), weil ein anderes Programm oder eine andere Quantisierung die Ergebnisse leicht um 20–50 % verschieben kann. Community-Messungen (GitHub, Foren) sind gekennzeichnet. Die Preise sind US-Listenpreise aus Herstellerankündigungen und Tests, jeweils mit Datum.
- Modell läuft in den Arbeitsspeicher über, RTX 5060 Ti: inventivehq.com/blog/vram-offload-cliff-gpu-layers-benchmark
- DGX-Spark-Benchmark: github.com/ggml-org/llama.cpp/blob/master/benches/dgx-spark/dgx-spark.md
- gpt-oss-Leitfaden und GPU-Messungen: github.com/ggml-org/llama.cpp/discussions/15396
- M5 Max und LM Studio: github.com/lmstudio-ai/lmstudio-bug-tracker/issues/2040
- Ryzen AI Max (Strix Halo): strix-halo-toolboxes.com, llm-tracker.info/_TOORG/Strix-Halo
- Apple: apple.com/mac-studio/specs, apple.com/mac-mini/specs, machinelearning.apple.com/research/mlx-distributed-inference
- M5 Ultra: macstories.net/stories/m5-ultra-mac-studio-review-the-dream-mac-for-local-ai-agents
- RTX Spark: theregister.com (16. Oktober 2026), servethehome.com, storagereview.com
- GeForce-Grafikkarten: nvidia.com/en-us/geforce/graphics-cards/compare, hardware-corner.net/gpu-llm-benchmarks
- llama.cpp-Bestenlisten: github.com/ggml-org/llama.cpp/discussions/15013 und /10879
- Copilot+ PC: microsoft.com/windows/windows-11-specifications, docs.ollama.com/gpu, fastflowlm.com
- Modellgrößen: huggingface.co (Repositories von ggml-org, unsloth und bartowski)
- Preise: Apple Newsroom, NVIDIA Newsroom und Entwicklerforen, servethehome.com, storagereview.com, notebookcheck.net, tomshardware.com