На наших веб-страницах размещены ссылки на партнёрские сайты. Если вы перейдёте на сайт партнёров с нашей страницы и приобретёте их услуги, мы получим комиссию за посредничество (Узнать больше). Такая форма сотрудничества не влияет на объективность наших отзывов. Каждая покупка, произведённая через клики, поддерживает нашу редакцию и помогает нам создавать качественный и полезный контент. Благодарим вас!

Компьютер для локального ИИ в 2026 году: как выбрать железо для запуска LLM дома

Содержание
Хотите запускать языковые модели на своём компьютере — без подписки, без отправки данных куда-либо и даже без подключения к интернету? Тогда процессор и наклейка с «TOPS» на коробке значат куда меньше, чем две другие вещи: сколько памяти может использовать модель и как быстро компьютер эту память читает. В этом руководстве мы разберём, как на самом деле работает локальный ИИ, сколько памяти нужно популярным моделям и как современное железо проявляет себя на практике — от видеокарты, которую можно поставить в уже имеющийся ПК, до рабочей станции для целой команды. Для каждого устройства приведены проверенные цифры, источники и чёткий вердикт, кому оно подойдёт; к некоторым разделам прилагается короткое видео.
Коротко, за 30 секунд
- Всё решает память. Модель должна целиком поместиться в быструю память, доступную GPU. При 4-битном квантовании закладывайте примерно 0,6 ГБ на миллиард параметров.
- Пропускная способность памяти определяет, как быстро модель пишет, а вычислительная мощность — как быстро она читает длинный промпт. Поэтому Mac пишет быстрее, чем DGX Spark, зато Spark быстрее читает длинные документы.
- Самые выгодные варианты сейчас: Mac Studio M5 Max со 128 ГБ (быстрый вывод), Ryzen AI Max+ 395 со 128 ГБ (самый дешёвый большой объём памяти), RTX 5060 Ti 16 ГБ (самый дешёвый разумный старт).
- «ИИ-ПК» с NPU — это не компьютер для локального ИИ. Ни Ollama, ни LM Studio NPU не используют.
Мы не тестировали эти устройства сами — цифры взяты из источников, перечисленных в конце статьи, а замеры сообщества отмечены отдельно. Цены указаны как рекомендованные розничные цены в США с датой; из-за дефицита памяти многие из них в течение 2026 года выросли.
Что купить: краткие рекомендации
Если не хотите читать всё руководство, вот короткий путь. Каждая рекомендация подробно разобрана ниже, к некоторым есть видео.
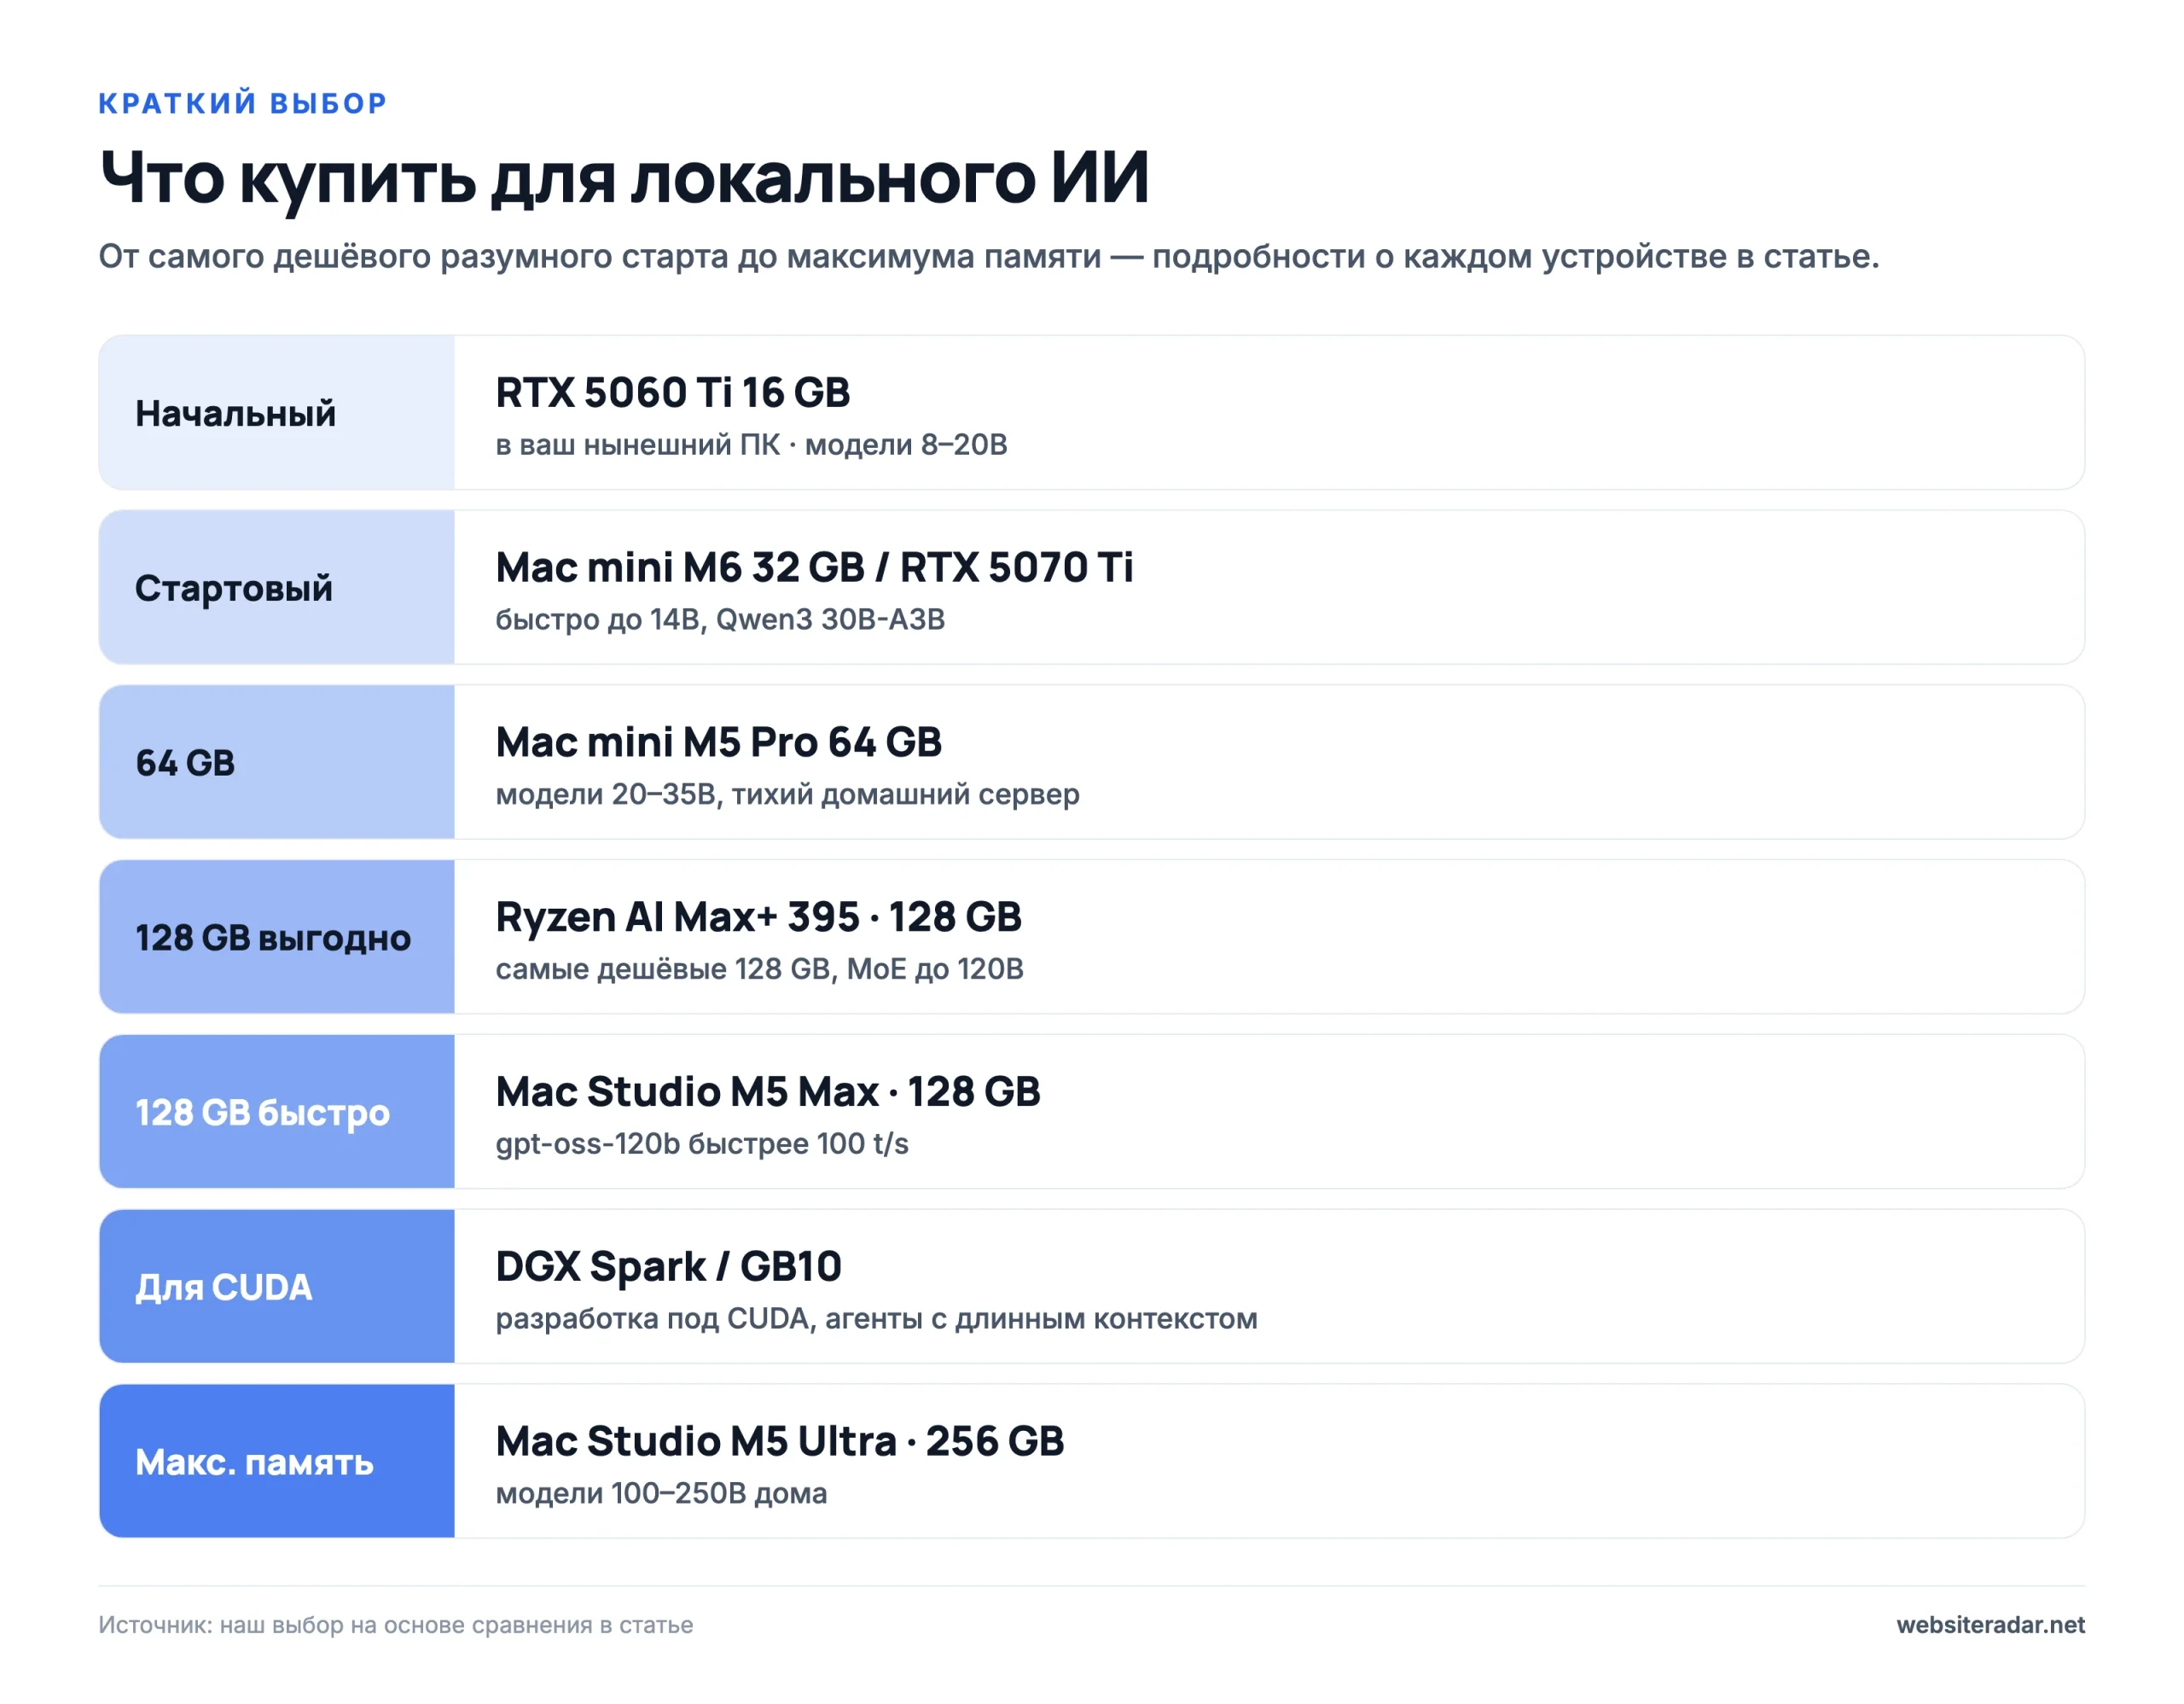
| Класс | Выбор | Какие модели потянет |
|---|---|---|
| Начальный | RTX 5060 Ti 16 ГБ в ваш нынешний ПК | 8–20B (Qwen3 14B, gpt-oss-20b) |
| Стартовый | Mac mini M6 с 32 ГБ или RTX 5070 Ti | до 14B на высокой скорости, Qwen3 30B-A3B |
| 64 ГБ | Mac mini M5 Pro с 64 ГБ | 20–35B, тихий домашний сервер |
| 128 ГБ, выгодно | Ryzen AI Max+ 395 со 128 ГБ | большие MoE-модели до 120B |
| 128 ГБ, быстро | Mac Studio M5 Max со 128 ГБ | gpt-oss-120b быстрее 100 т/с |
| Для CUDA | DGX Spark или другая машина на GB10 | разработка под CUDA, агенты для программирования |
| Максимум памяти | Mac Studio M5 Ultra с 256 ГБ | модели на 100–250B дома |
| Для команды | RTX PRO 6000 | 70–120B для всей команды |
Зачем запускать ИИ локально — и чего не стоит ожидать
Локальная модель работает на вашем собственном компьютере. Данные никуда не уходят, вы не платите ни ежемесячную подписку, ни за токены, модель работает без интернета, и никто не сможет в одночасье изменить её или снять с поддержки. Поэтому локальный ИИ хорошо подходит для конфиденциальных документов, ассистентов, работающих с кодом компании, автоматизаций, которые отправляют тысячи запросов в день, — или просто для экспериментов ради удовольствия.
Подвоха здесь два. Во-первых, открытые модели, которые помещаются в домашнее железо, умны, но до уровня лучших облачных сервисов не дотягивают. Во-вторых, железо недешёвое, а в 2026 году дефицит памяти ещё и толкает цены вверх. Главные причины перейти на локальный ИИ — приватность, контроль и независимость, а не экономия.
Как модель работает на вашем компьютере
Когда вы задаёте модели вопрос, проходят две фазы, и каждую ограничивает что-то своё:
- Чтение промпта (prefill). Модель обрабатывает весь ваш ввод разом — вопрос, вставленный документ, код вашего проекта. Эта фаза зависит от вычислительной мощности GPU и определяет, сколько вы ждёте первого слова ответа. На короткий вопрос уходят доли секунды, а документ длиной в десятки тысяч слов может обрабатываться минутами.
- Написание ответа (decode). Модель генерирует текст по одному слову (строго говоря, по одному токену). Для каждого токена ей нужно прочитать из памяти всю модель — а у моделей со смесью экспертов только её активную часть. Эта фаза зависит от пропускной способности памяти: сколько гигабайт в секунду способен прочитать чип.

Практическая разница такова: в чате вы ощущаете прежде всего скорость вывода (и здесь Mac блистает). Для агентов-программистов и работы с документами, которые постоянно скармливают модели огромные объёмы контекста, не менее важно быстрое чтение промпта (а здесь лидирует NVIDIA). Скорость измеряют в токенах в секунду — один токен примерно равен трём четвертям слова. Около 15 токенов в секунду соответствует скорости чтения; выше 50 модель ощущается шустрой.
Сколько нужно памяти
Модель должна целиком находиться в быстрой памяти, к которой есть доступ у GPU: либо в видеопамяти (VRAM) видеокарты, либо в общей (унифицированной) памяти, как у Mac, DGX Spark или Ryzen AI Max. Если модель не помещается, часть её вытесняется в обычную системную оперативную память, и скорость обваливается. В одном тесте на RTX 5060 Ti перенос с GPU всего шестой части слоёв Qwen 14B снизил скорость вывода с 43 до 12,5 токена в секунду; на одном лишь CPU вышло 2,9.
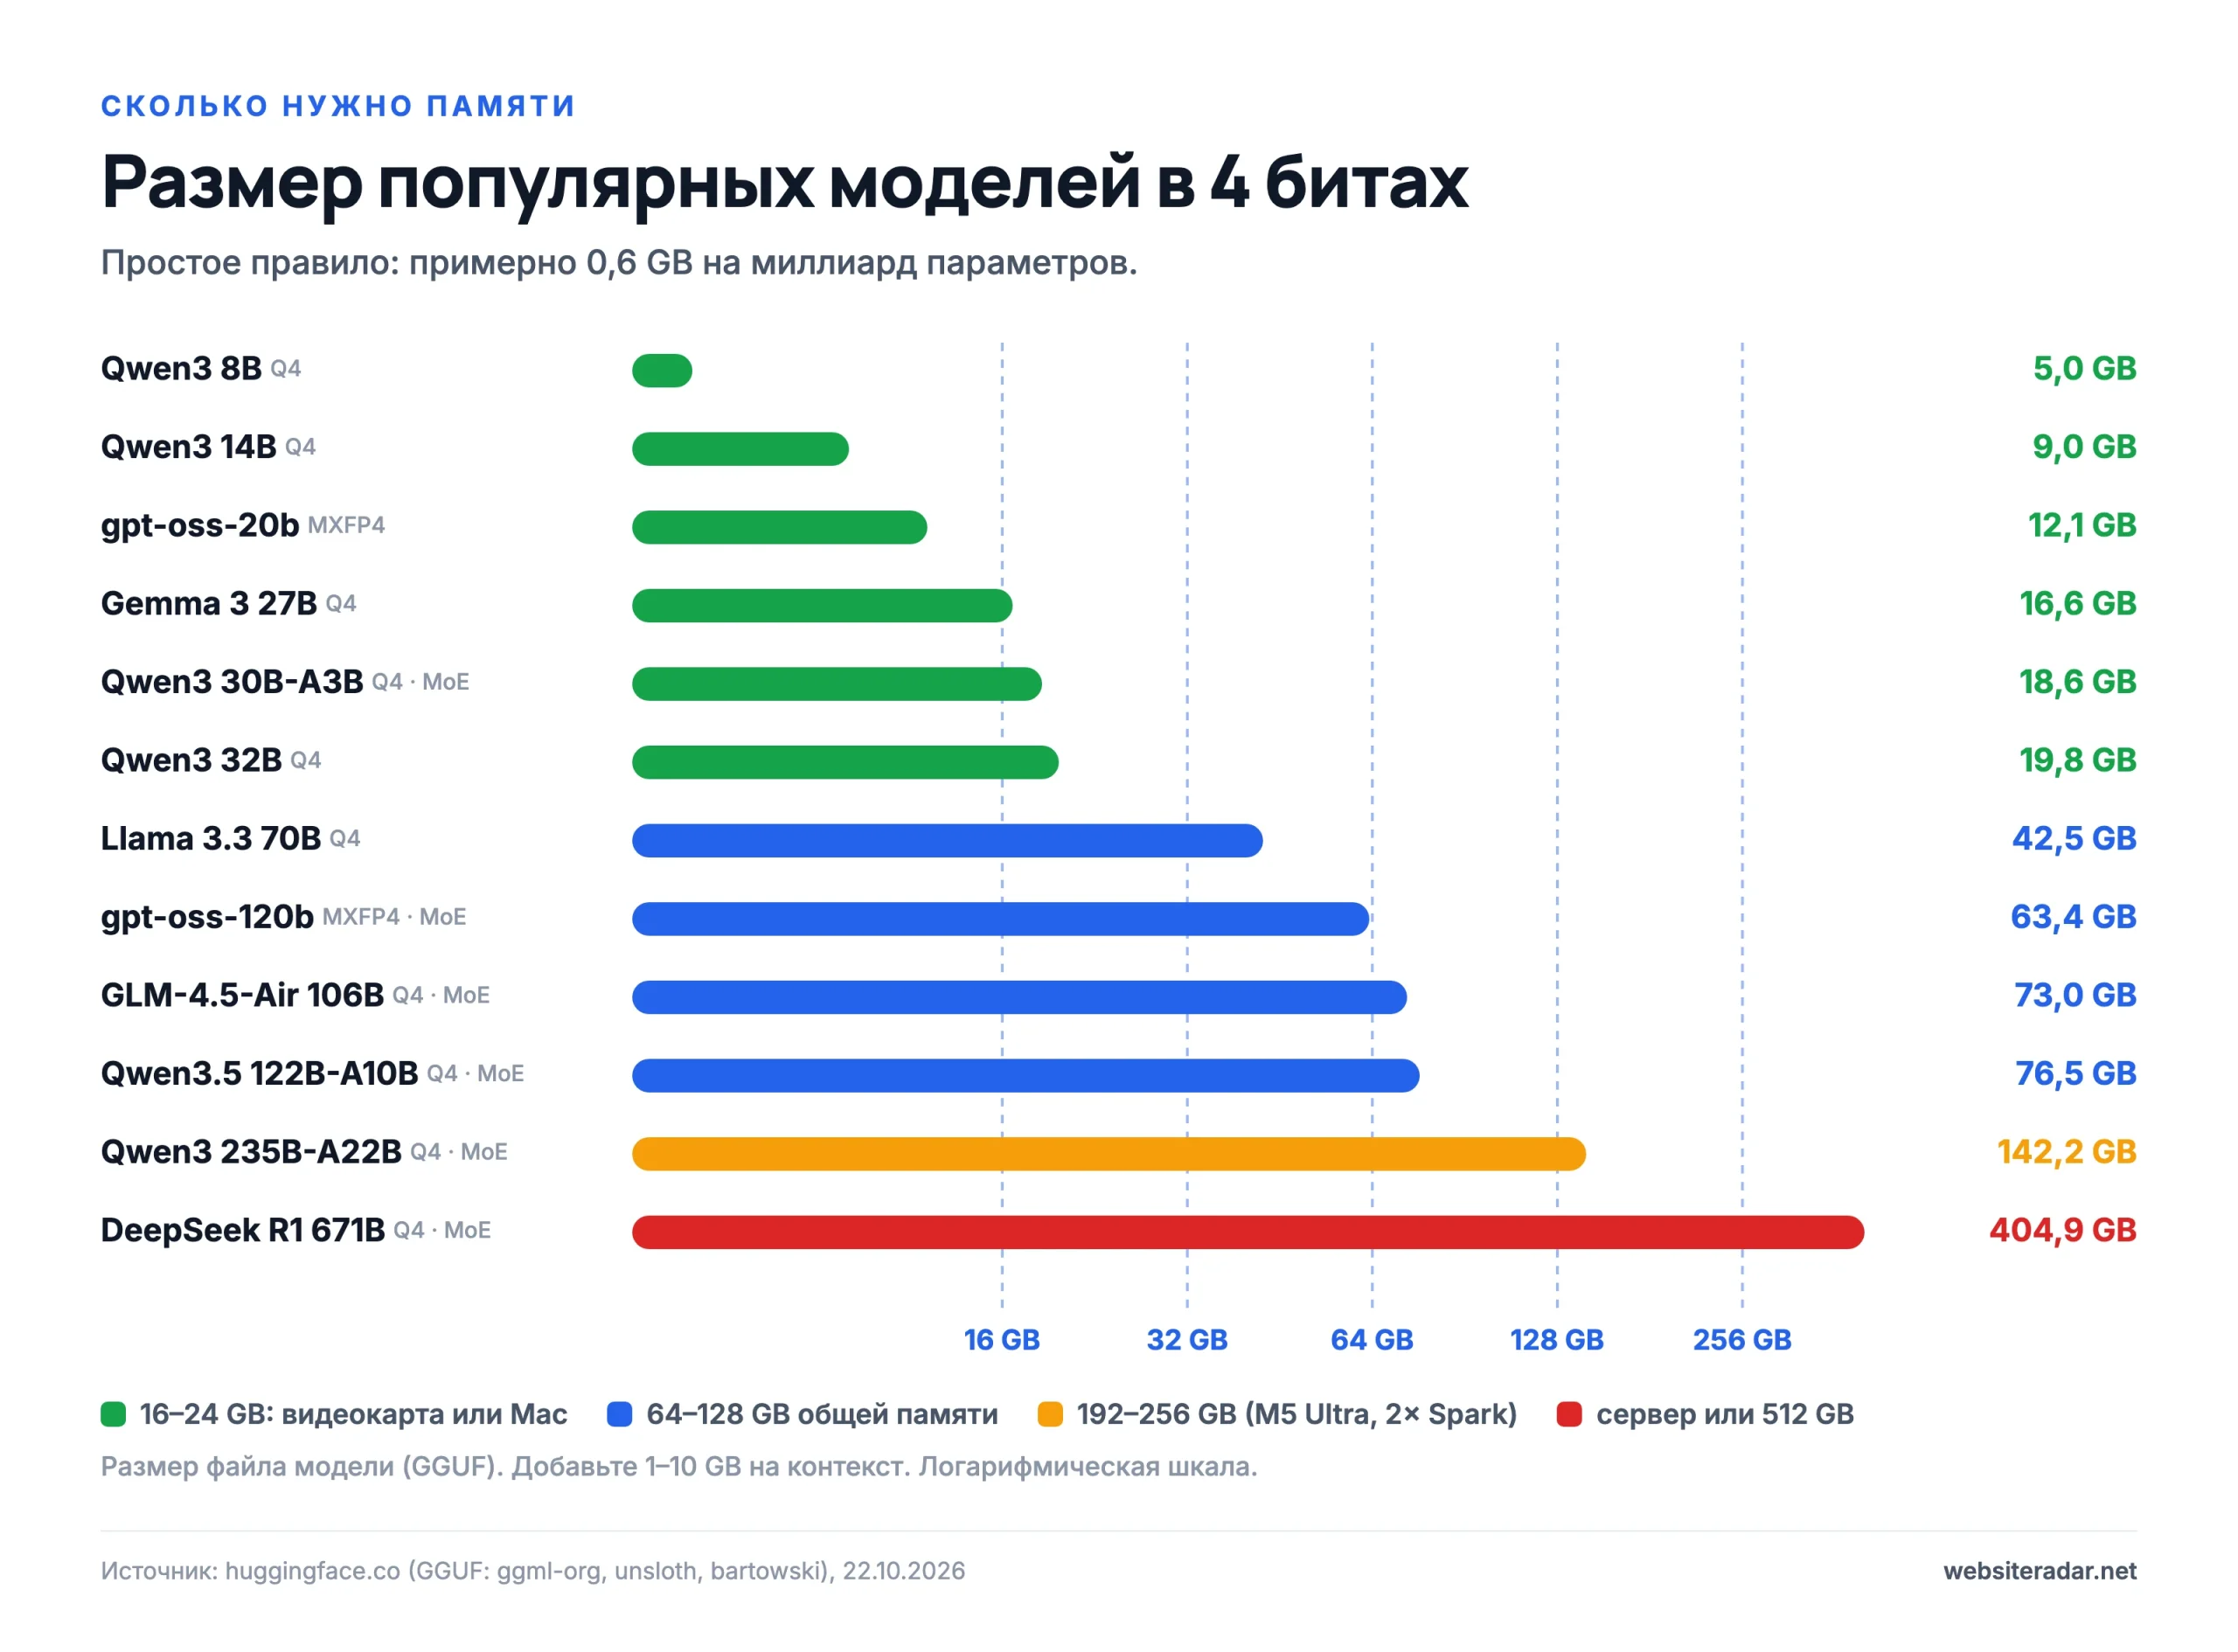
| Модель | Тип | Размер (4 бита) | Куда поместится |
|---|---|---|---|
| Llama 3.1 8B / Qwen3 8B | плотная | 4,9–5,0 ГБ | везде, где есть 8 ГБ |
| Qwen3 14B | плотная | 9,0 ГБ | 12–16 ГБ |
| gpt-oss-20b | MoE | 12,1 ГБ (MXFP4) | 16 ГБ |
| Gemma 3 27B | плотная | 16,6 ГБ | 24 ГБ |
| Qwen3 30B-A3B | MoE, 3B активных | 18,6 ГБ | 24 ГБ |
| Qwen3 32B | плотная | 19,8 ГБ | 24–32 ГБ |
| Llama 3.3 70B | плотная | 42,5 ГБ | от 48 ГБ |
| gpt-oss-120b | MoE | 63,4 ГБ (MXFP4) | 96–128 ГБ |
| GLM-4.5-Air 106B | MoE | 73,0 ГБ | от 96 ГБ |
| Qwen3.5 122B-A10B | MoE | 76,5 ГБ | 96–128 ГБ |
| Qwen3 235B-A22B | MoE | 142,2 ГБ | 192–256 ГБ |
| DeepSeek R1 671B | MoE | 404,9 ГБ | 512 ГБ |
Контексту тоже нужна память
Помимо самой модели нужна память под контекст (KV-кэш) — всё, что модель «помнит» из разговора или документа. Для Llama 3.3 70B это примерно 10 ГБ сверху при контексте в 32 000 токенов и около 40 ГБ при 128 000 токенов. Модели gpt-oss гораздо экономнее благодаря скользящему окну: gpt-oss-120b даже на 128 000 токенов нужно максимум около 9 ГБ. С ростом контекста падает и скорость вывода: gpt-oss-120b на M5 Max пишет около 80 токенов в секунду при коротком контексте, но лишь 14 — при 128 000 токенов.
Не вся память достаётся GPU
- macOS по умолчанию разрешает GPU использовать примерно 75% оперативной памяти (точную цифру Apple не публикует). Поэтому Mac с 64 ГБ отдаёт модели около 48 ГБ, а Mac со 128 ГБ — около 96 ГБ. Лимит можно поднять командой
sudo sysctl iogpu.wired_limit_mb=…, но после перезагрузки он сбрасывается. - Windows на Ryzen AI Max делит память в BIOS в фиксированной пропорции — GPU получает максимум 96 ГБ из 128 ГБ. В Linux можно выделить примерно до 124 ГБ.
- Ноутбуки NVIDIA RTX Spark в Windows по умолчанию делят память примерно поровну, вручную можно выставить максимум 96 ГБ из 128 ГБ. Версия с 32 ГБ отдаёт GPU всего 16 ГБ.
- DGX Spark под Linux распределяет память динамически, поэтому модель может занять большую часть из 128 ГБ.
Квантование и MoE простыми словами
Квантование — это сжатие моделей: вместо 16 бит на параметр используется 8 или 4. В 4 битах (обозначения Q4, Q4_K_M или MXFP4) модель занимает примерно четверть исходного объёма, а качество падает лишь незначительно — разумный выбор по умолчанию для домашнего использования. Восемь бит (Q8) — почти без потерь, но и места вдвое больше.
Смесь экспертов (MoE) — архитектура, при которой у модели много параметров, но для каждого слова задействуется лишь небольшая их часть. У gpt-oss-120b 117 млрд параметров, но на каждом шаге активируется лишь около пяти миллиардов; у Qwen3 30B-A3B — всего три миллиарда. Такой модели нужно много памяти, но пишет она со скоростью гораздо меньшей модели. Поэтому MoE-модели идеальны для машин с большой, но более медленной общей памятью — DGX Spark, Ryzen AI Max или Mac. Плотные (dense) модели (Llama 70B, Qwen3 32B), напротив, для каждого слова читают всю модель целиком и на медленной памяти еле ползут.
Пропускная способность памяти: почему Mac пишет быстрее Spark
Скорость вывода можно оценить довольно точно: пропускная способность памяти, делённая на объём данных, который модель должна прочитать на каждый токен. Поэтому плотная 70B-модель в 4 битах (~42 ГБ) на DGX Spark с 273 ГБ/с не может писать быстрее примерно 6–7 токенов в секунду — и замеры показывают около 4,4.

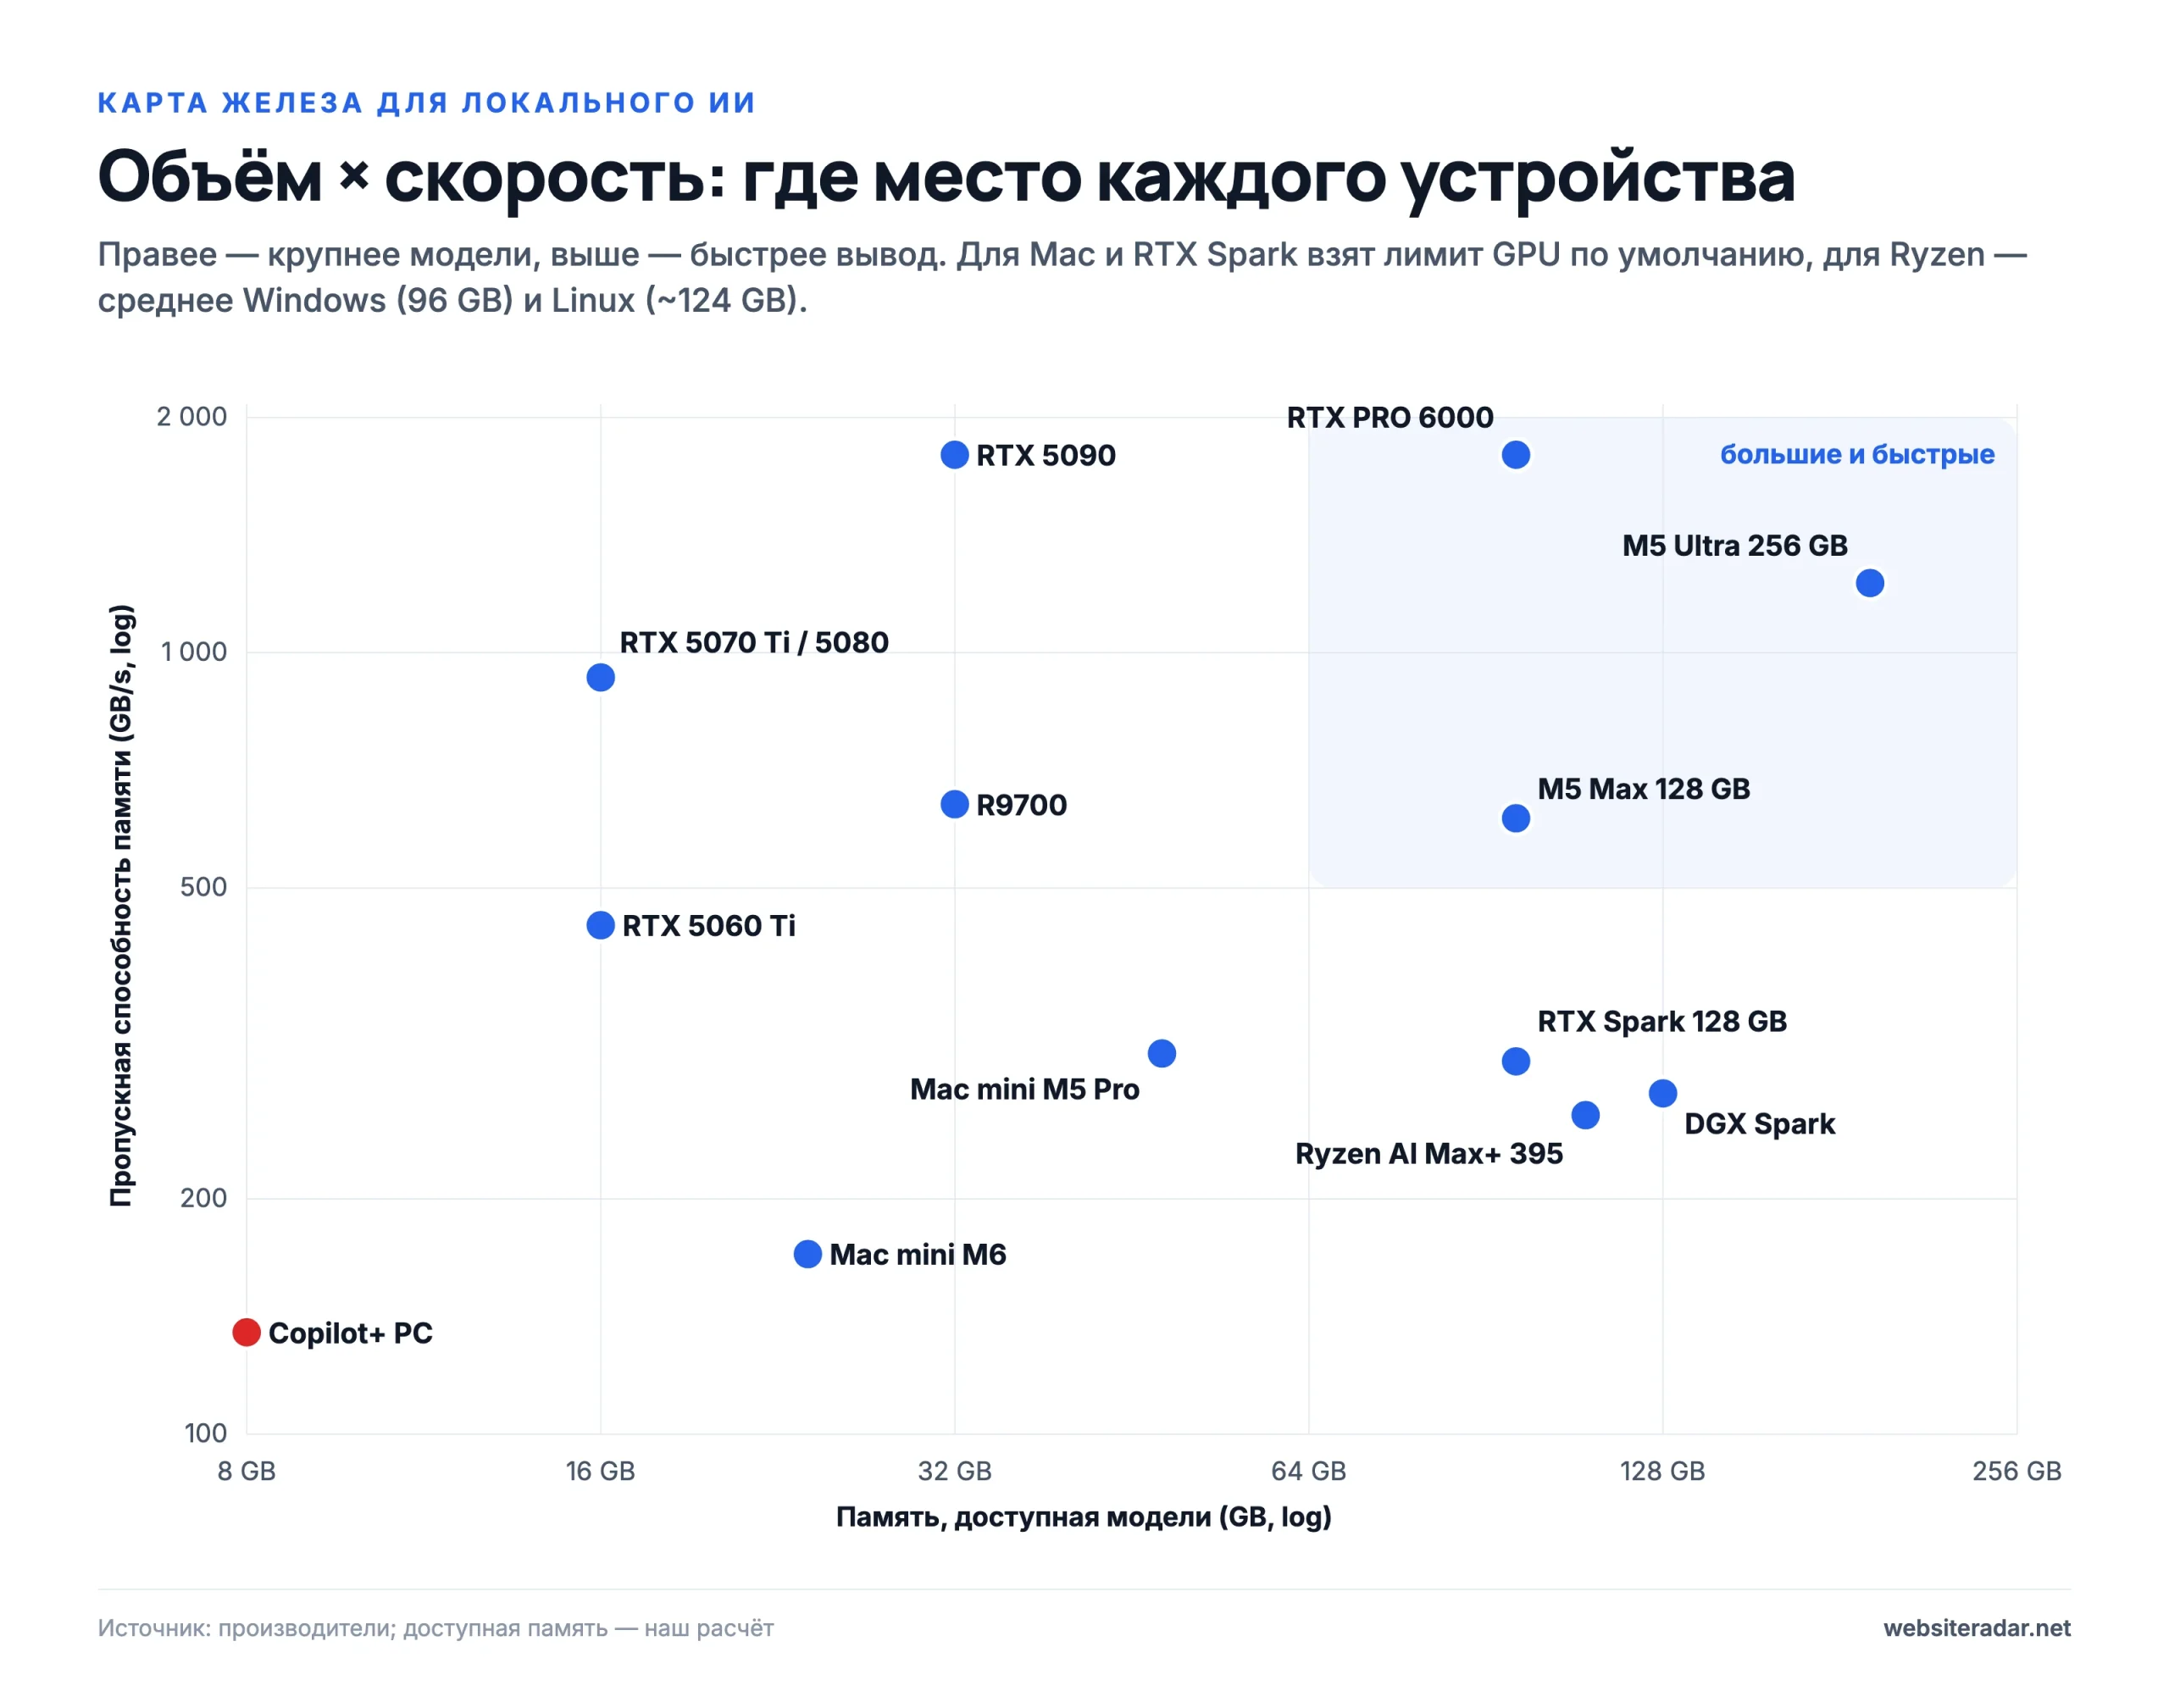
Карта наглядно показывает, что идеального устройства не существует. У видеокарт NVIDIA самая быстрая память, но её мало. У DGX Spark, Ryzen AI Max и RTX Spark памяти много, но она медленнее. Mac Studio с M5 Max — а особенно с M5 Ultra — сочетает и то и другое, но ценой отсутствия CUDA и более медленного, чем у NVIDIA, чтения промпта.
Одна модель, разное железо
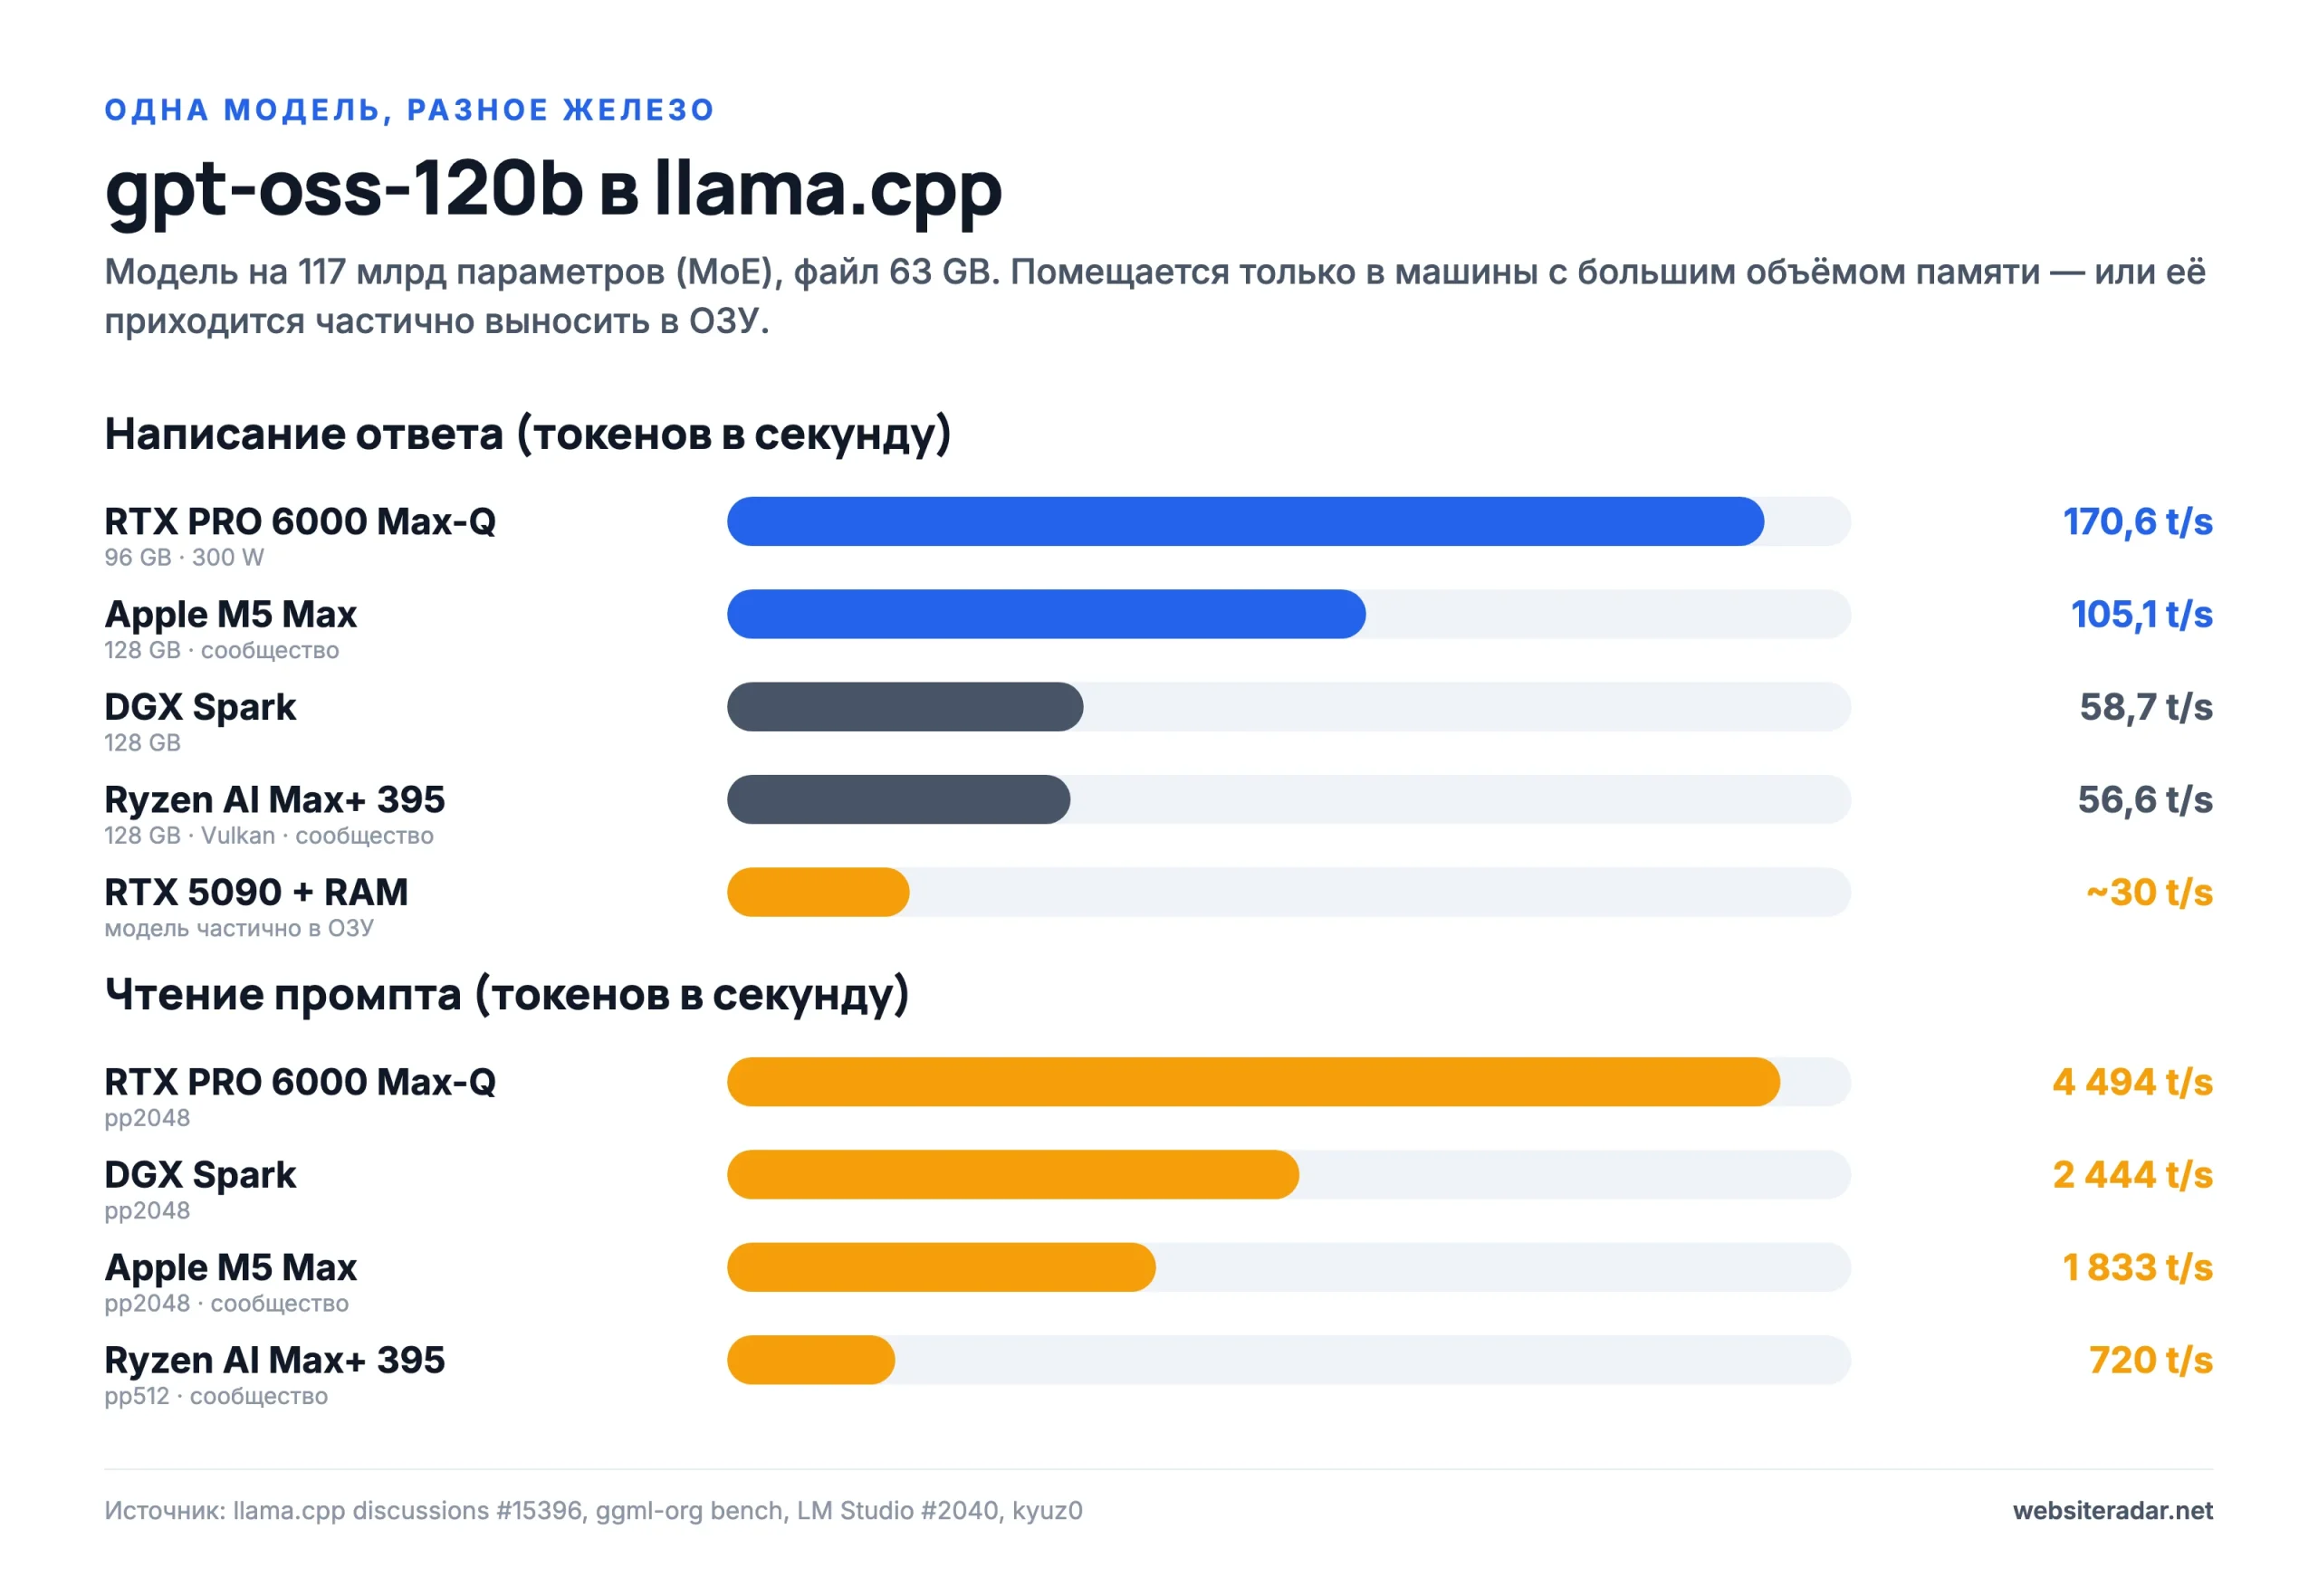
Честнее всего сравнивать одну и ту же модель в одной и той же программе. Мы выбрали gpt-oss-120b от OpenAI (63 ГБ) и замеры из llama.cpp — самой популярной программы для запуска локальных моделей.
Сравнение всех устройств
| Устройство | Память для ИИ | Скорость памяти | gpt-oss-120b, вывод |
|---|---|---|---|
| Mac Studio M5 Max | ~96 ГБ из 128 ГБ | 614 ГБ/с | 105 т/с¹ |
| NVIDIA DGX Spark | 128 ГБ | 273 ГБ/с | 58,7 т/с |
| Ноутбуки RTX Spark | до 96 ГБ из 128 ГБ | до 300 ГБ/с | — |
| Ryzen AI Max+ 395 | 96 ГБ (Windows) / ~124 ГБ (Linux) | 256 ГБ/с | 56,6 т/с |
| Mac Studio M5 Ultra | ~192 ГБ из 256 ГБ | 1 228 ГБ/с | — |
| Mac mini M5 Pro | ~48 ГБ из 64 ГБ | 307 ГБ/с | не помещается |
| Mac mini M6 | ~24 ГБ из 32 ГБ | 170 ГБ/с | не помещается |
| MacBook Pro M5 Max | ~96 ГБ из 128 ГБ | 614 ГБ/с | 105 т/с¹ |
| RTX 5090 | 32 ГБ | 1 792 ГБ/с | ~30 т/с² |
| RTX 5060 Ti 16 ГБ | 16 ГБ | 448 ГБ/с | не помещается |
| RTX 5070 Ti / 5080 | 16 ГБ | 896 / 960 ГБ/с | не помещается |
| RTX PRO 6000 Max-Q | 96 ГБ | 1 792 ГБ/с | 170,6 т/с |
| GB10 от ASUS, MSI, Lenovo… | 128 ГБ | 273 ГБ/с | ~ как у Spark |
| Radeon AI PRO R9700 | 32 ГБ | ~640 ГБ/с | не помещается |
| Ноутбуки Copilot+ | ~8 ГБ из 16 ГБ | ~135 ГБ/с | не помещается |
¹ Замер сообщества на MacBook Pro M5 Max со 128 ГБ, llama.cpp. ² Часть модели вынесена в системную память.
1. Mac Studio M5 Max — самый быстрый вывод за свои деньги
Mac Studio на чипе M5 Max — сегодня самый разумный выбор для тех, кому нужен максимально быстрый локальный чат или агент и не нужна CUDA. Благодаря пропускной способности памяти 614 ГБ/с версия со 128 ГБ запускает gpt-oss-120b со скоростью более 100 токенов в секунду — почти вдвое быстрее, чем DGX Spark. Новые нейроускорители в каждом ядре GPU ускорили и чтение промпта, но только в актуальном ПО (см. настройку софта).
- Память: 36, 48, 64 или 128 ГБ · пропускная способность 460 ГБ/с (36 ГБ) / 614 ГБ/с
- Энергопотребление: 7 Вт в простое, максимум 200 Вт
- Порты: 4× Thunderbolt 5, 10GbE
- Обратите внимание: у версии с 36 ГБ более слабый 32-ядерный GPU, и для модели остаётся лишь около 27 ГБ. Начиная с 48 ГБ вы получаете полноценный чип.
- Рекомендованная цена в США: от $2 499 (базовая конфигурация, август 2026 года)
Подойдёт для: чата и агентов на MoE-моделях, тихого домашнего ИИ-сервера, тех, кто ещё и монтирует видео. Не подойдёт для: тех, кому нужны CUDA, vLLM или обучение моделей.
2. NVIDIA DGX Spark — рабочая станция разработчика, а не машина для чата
Чип GB10 со 128 ГБ общей памяти и полным программным стеком NVIDIA (CUDA, vLLM, TensorRT-LLM) в корпусе 15 × 15 см. Промпты он читает быстрее любой другой компактной машины — 2 444 токена в секунду на gpt-oss-120b, — но при пропускной способности 273 ГБ/с пишет медленнее Mac: 58,7 токена в секунду, а на плотной Llama 70B — лишь 4,4. Во время работы модели он потребляет 60–90 Вт, а два устройства можно соединить кабелем QSFP для моделей примерно до 400 млрд параметров.
- Память: 128 ГБ LPDDR5x · пропускная способность 273 ГБ/с
- GPU: Blackwell, 6 144 ядра CUDA · ИИ-производительность 1 PFLOP FP4 (с учётом разреженности; на практике примерно вдвое меньше)
- ОС: DGX OS (Ubuntu на Arm)
- Рекомендованная цена в США: $3 999 на старте (октябрь 2025 года), $4 699 с февраля 2026 года; в октябре 2026 года ServeTheHome сообщил о переходе в ценовую категорию «в районе $6 950»
Подойдёт для: разработки под CUDA, агентов для программирования с большим контекстом, дообучения моделей до 70B. Не подойдёт для: быстрого чата с плотными 70B-моделями, Windows и игр, новичков.
3. Ноутбуки NVIDIA RTX Spark — 128 ГБ в рюкзаке
Чип N1X — это GB10, адаптированный для ноутбуков на Windows, с более быстрой памятью (до 300 ГБ/с) и энергопотреблением 45–80 Вт. В тесте The Register ноутбук запустил Qwen3.6 35B-A3B со скоростью 67,6 токена в секунду — быстрее настольного DGX Spark. Подвох — в Windows: GPU получает лишь фиксированную часть памяти — максимум 16 ГБ из 32 ГБ, 48 ГБ из 64 ГБ и 96 ГБ из 128 ГБ.
- Память: 32, 64 или 128 ГБ · пропускная способность до 300 ГБ/с
- GPU: Blackwell, 6 144 ядра (по производительности примерно как мобильная RTX 5070)
- ОС: Windows 11 on Arm, CUDA начиная с версии 13.4
- Обратите внимание: первые устройства (Surface, HP) в обзорах падали после нескольких часов полной нагрузки; Linux официально не поддерживается
- Цена в США: от $2 599 (Surface Laptop Ultra с 24 ГБ) до $5 899,99 (Surface со 128 ГБ), октябрь 2026 года
Подойдёт для: больших моделей на ноутбуке с Windows, агентов для программирования, творческой работы. Не подойдёт для: длительного обучения и ПО только под x86; версию с 32 ГБ не берите.
4. Ryzen AI Max+ 395 — самые дешёвые 128 ГБ
Мини-ПК с 16-ядерным Ryzen и графикой Radeon 8060S делят между процессором и графикой 128 ГБ памяти. Скорость вывода сопоставима с DGX Spark (gpt-oss-120b — 56,6 токена в секунду) примерно за половину цены, к тому же на них работают Windows и Linux — и игры. Слабое место — чтение промпта: оно в два-три раза медленнее, чем на Spark, и проседает на длинных контекстах — до 146 токенов в секунду с драйвером Vulkan и до 371 с ROCm.
- Память: 128 ГБ LPDDR5x · пропускная способность 256 ГБ/с (~215 по замерам)
- Для GPU: 96 ГБ в Windows, ~124 ГБ в Linux
- ПО: Vulkan или ROCm (gfx1151 официально поддерживается с 2026 года)
- HP Z2 Mini G1a стоит дороже, но это сертифицированная рабочая станция с памятью ECC и трёхлетней гарантией
- Пример цены в США: Framework Desktop со 128 ГБ вышел по цене $1 999, а после подорожания памяти в 2026 году стоит $2 459
Подойдёт для: максимума памяти за свои деньги, больших MoE-моделей, чата и суммаризации. Не подойдёт для: агентов с огромным контекстом и CUDA; планшет ROG Flow Z13 с 32–64 ГБ для больших моделей тоже не годится.
5. Mac Studio M5 Ultra — король памяти
До 512 ГБ памяти и 1,2 ТБ/с пропускной способности. В обзоре MacStories M5 Ultra читал промпты в четыре раза быстрее предыдущего M3 Ultra и писал на 50% быстрее. В версию с 256 ГБ помещается даже Qwen3 235B. Несколько устройств можно объединить через Thunderbolt 5 и RDMA: по данным Apple, четыре M5 Ultra запускают модель на 816 млрд параметров со скоростью 36,7 токена в секунду.
- Память: 96, 256 или 512 ГБ (512 ГБ появится в конце октября) · пропускная способность 1 228 ГБ/с
- Энергопотребление: 9 Вт в простое, около 300 Вт при работе модели
- Порты: 6× Thunderbolt 5
- Обратите внимание: память нельзя нарастить позже; в сентябре срок ожидания доходил до 18 недель
- Рекомендованная цена в США: от $5 499 (август 2026 года); переход с 96 на 256 ГБ добавляет $4 000
Подойдёт для: моделей на 100–250B, агентов с длинным контекстом, небольших команд. Не подойдёт для: моделей до 30B, CUDA, ограниченного бюджета.
6. Mac mini M5 Pro — разумная точка входа
Самый дешёвый Mac, на котором работают по-настоящему полезные модели. Пропускная способность 307 ГБ/с, до 64 ГБ памяти и Thunderbolt 5. Благодаря нейроускорителям промпты он читает примерно в три раза быстрее предыдущего M4 Pro. Версия с 64 ГБ уверенно тянет модели до 32 млрд параметров; плотная Llama 70B помещается, но выдаёт лишь около 7 токенов в секунду, а gpt-oss-120b не помещается вовсе.
- Память: 24, 48 или 64 ГБ · пропускная способность 307 ГБ/с
- Энергопотребление: 6 Вт в простое, максимум 145 Вт · в простое практически бесшумен
- Рекомендованная цена в США: от $1 699 (базовая конфигурация, август 2026 года)
Подойдёт для: моделей на 20–35B, тихого домашнего ИИ-сервера. Не подойдёт для: gpt-oss-120b и плотных 70B-моделей; версию с 24 ГБ не берите.
7. Mac mini M6 — дёшево, но не с 16 ГБ
Самый дешёвый Mac с нейроускорителями. Его потолок — 32 ГБ и 170 ГБ/с, а у версии с 16 ГБ всего 153 ГБ/с, и для модели остаётся около 12 ГБ. По сравнению с предыдущим Mac mini на M4 он читает промпты в 4,5 раза быстрее и пишет на 50% быстрее практически за те же деньги, так что старую модель не берите даже со скидкой.
- Память: 16, 24 или 32 ГБ (максимум) · пропускная способность 153 / 170 ГБ/с
- Энергопотребление: 4 Вт в простое, максимум 70 Вт
- Обратите внимание: только Thunderbolt 4, поэтому объединить несколько устройств не получится
- Рекомендованная цена в США: от $899 (базовая конфигурация, август 2026 года)
Подойдёт для: моделей на 7–14B, gpt-oss-20b, Qwen3 30B-A3B. Не подойдёт для: моделей на 70B и больше; версию с 16 ГБ не берите.
8. MacBook Pro M5 Max — ИИ в дороге
Тот же чип, что и в Mac Studio, а значит, и та же скорость: это самый быстрый ноутбук для локальных моделей. С моделью среднего размера Qwen3.6 35B-A3B он генерирует более 90 токенов в секунду. Однако 14-дюймовая версия под длительной нагрузкой троттлит (с 96 до 42 Вт), а мощность зарядки ограничена 97 Вт. Mac Studio с тем же чипом и 128 ГБ заметно дешевле.
- Память: 36, 48, 64 или 128 ГБ · пропускная способность 460 / 614 ГБ/с
- Аккумулятор: 72,4 Вт·ч (14″) / 100 Вт·ч (16″)
- Рекомендованная цена в США: от $3 599 (14″) и $3 899 (16″), март 2026 года; переход с 64 на 128 ГБ добавляет $1 000
Подойдёт для: тех, кому нужны большие модели в поездках, — в идеале 16-дюймовая версия с 64–128 ГБ. Не подойдёт для: круглосуточной нагрузки и тех, кто работает за столом; версию с 36 ГБ не берите.
9. RTX 5090 — самая быстрая, но всего 32 ГБ
Пропускная способность 1 792 ГБ/с: gpt-oss-20b пишет со скоростью почти 300 токенов в секунду, а длинный промпт карта читает примерно вдвое быстрее, чем Mac Studio с M5 Ultra. В 32 ГБ помещаются модели примерно до 32 млрд параметров в 4 битах — даже с длинным контекстом; модель на 70 млрд параметров не влезает. Большие MoE-модели можно частично вынести в системную память — тогда gpt-oss-120b работает со скоростью около 30 токенов в секунду.
- Память: 32 ГБ GDDR7 · пропускная способность 1 792 ГБ/с
- Энергопотребление: 575 Вт, рекомендуется блок питания на 1 000 Вт
- Рекомендованная цена в США: $1 999 на старте (январь 2025 года); реальные цены в магазинах в 2026 году гораздо выше из-за дефицита памяти
Подойдёт для: агентов для программирования и RAG с моделями до 32B, разработки под CUDA, игр. Не подойдёт для: моделей на 70B и больше, тихого экономичного сервера.
10. RTX 5060 Ti 16 ГБ — самый дешёвый разумный старт
Самая дешёвая новая видеокарта с 16 ГБ. Она запускает gpt-oss-20b со скоростью около 92 токенов в секунду, Qwen3 8B — 69, а Qwen3 14B — 41: быстрее, чем вы успеваете читать. Однако пропускная способность её памяти вдвое ниже, чем у RTX 5070 Ti, поэтому пишет она примерно вдвое медленнее, а модели около 30 млрд параметров в 16 ГБ не помещаются.
- Память: 16 ГБ GDDR7 · пропускная способность 448 ГБ/с
- Энергопотребление: 180 Вт, достаточно блока питания на 600 Вт
- Рекомендованная цена в США: $429 за версию с 16 ГБ на старте (апрель 2025 года)
Подойдёт для: первых серьёзных экспериментов, моделей на 8–20B, бюджетного ИИ-ПК. Не подойдёт для: моделей на 27B и больше.
11. RTX 5070 Ti против RTX 5080 — для ИИ почти одинаковы
У обеих карт по 16 ГБ и почти одинаковая пропускная способность (896 против 960 ГБ/с), поэтому пишут они практически с одной скоростью: 182,4 против 184,7 токена в секунду в стандартном тесте llama.cpp и 74 против 81 на Qwen3 14B. Помещаются в них одни и те же модели. 5080 быстрее в основном в играх — а её стартовая цена была на $250 выше ($999 против $749).
Наш совет: для ИИ берите RTX 5070 Ti, а сэкономленные деньги вложите в SSD побольше или в дополнительную оперативную память. RTX 5080 стоит покупать, только если вы в основном играете.
12. RTX PRO 6000 — 96 ГБ на одной карте
Единственная карта, в которую целиком помещаются Llama 3.3 70B (32 токена в секунду), gpt-oss-120b (170,6 токена в секунду в версии Max-Q) и Qwen3.5 122B (около 98 токенов в секунду). Благодаря CUDA и vLLM она может обслуживать нескольких пользователей одновременно. Её можно купить отдельно или в составе готовой рабочей станции.
- Память: 96 ГБ GDDR7 с ECC · пропускная способность 1 792 ГБ/с
- Энергопотребление: 300 Вт (Max-Q); полная версия на 600 Вт пишет примерно на 13% быстрее
- Рекомендованная цена в США: $8 565 на старте; позже NVIDIA подняла её до $13 250
Подойдёт для: компаний и команд, которые хотят запускать или обучать большие модели у себя. Не подойдёт для: частных пользователей и энтузиастов.
13. DGX Spark от ASUS, MSI, Lenovo, Dell и Gigabyte — какой выбрать
Ещё пять производителей продают тот же чип GB10, что стоит в DGX Spark. ИИ-производительность различается лишь на несколько процентов; разница — в накопителе, блоке питания, охлаждении и поддержке, а также в цене.
| Модель | Накопитель | Блок питания | Особенность |
|---|---|---|---|
| NVIDIA / PNY DGX Spark | 4 ТБ, самошифрующийся | 240 Вт | оригинал |
| GIGABYTE AI TOP ATOM | 4 ТБ PCIe 5.0 | 240 Вт | самый быстрый SSD |
| ASUS Ascent GX10 | 1 ТБ PCIe 4.0 / 4 ТБ PCIe 5.0 | 240 Вт | кнопка питания спереди |
| Lenovo ThinkStation PGX | 1 / 2 / 4 ТБ, самошифрующийся | 240 Вт | год выездного обслуживания |
| Dell Pro Max with GB10 | PCIe 4.0 (2 ТБ — QLC) | 280 Вт | мощнее БП, самый горячий SSD |
| MSI EdgeXpert | 4 ТБ | — | новинка, независимых тестов пока нет |
Наш совет: лучший комплект за разумные деньги — Gigabyte AI TOP ATOM с 4 ТБ быстрого накопителя; самый дешёвый проверенный вариант для старта — ASUS Ascent GX10 с 1 ТБ, который в США вышел примерно за $3 000. Если планируете объединить два устройства, понадобится кабель QSFP. Новинка с 23 октября 2026 года: версия GB10 с 64 ГБ, которую продают только партнёрские бренды, — от $4 999.
14. Radeon AI PRO R9700 — 32 ГБ за долю цены RTX 5090
Самая дешёвая новая карта с 32 ГБ. В том же тесте на Vulkan она пишет примерно на 40% медленнее RTX 5090, но в неё помещаются те же модели — около 30 млрд параметров, даже с более длинным контекстом. gpt-oss-20b и Qwen3 30B-A3B работают на ней со скоростью более 150 токенов в секунду. Не верьте маркетингу: «до пяти раз быстрее RTX 5080» относится только к модели, которая не помещается в 16 ГБ.
- Память: 32 ГБ GDDR6 · пропускная способность ~640 ГБ/с · энергопотребление 300 Вт
- ПО: Vulkan (обычно быстрее вывод) или ROCm (быстрее чтение промпта); CUDA нет
- Рекомендованная цена в США: $1 299 (октябрь 2025 года)
Подойдёт для: моделей на 27–32B с длинным контекстом, нескольких карт в одном ПК. Не подойдёт для: инструментов, работающих только с CUDA, и максимальной скорости.
15. «ИИ-ПК» и ноутбуки Copilot+ — миф
Copilot+ — это сертификация Microsoft для функций Windows: эффектов камеры, живых субтитров, Recall или небольшой встроенной модели Phi Silica. О способности запускать большие языковые модели она ничего не говорит. Ни Ollama, ни LM Studio нейропроцессор (NPU) не используют, llama.cpp — лишь экспериментально; NPU задействуют только фирменные инструменты вроде Microsoft Foundry Local или AMD Lemonade с отдельными моделями.

Вдобавок у этих ноутбуков память с пропускной способностью около 135 ГБ/с и 16 ГБ ОЗУ, из которых модели остаётся около 8 ГБ. Они годятся для моделей до 4 млрд параметров и функций Windows — но не для «своего ChatGPT дома».
Подойдёт для: офисной работы, долгой автономности, небольших моделей на 1–4B. Не подойдёт для: тех, кто хочет запускать модели на 14B и больше.
Энергопотребление и расходы на эксплуатацию
Если компьютер будет круглосуточно работать домашним ИИ-сервером, важны также энергопотребление и шум.
| Устройство | Простой | Работа модели / максимум | Примечание |
|---|---|---|---|
| Mac mini M6 | 4 Вт | макс. 70 Вт | практически бесшумный |
| Mac mini M5 Pro | 6 Вт | макс. 145 Вт | 5 дБА в простое (Apple) |
| Mac Studio M5 Max | 7 Вт | макс. 200 Вт | тихий |
| Mac Studio M5 Ultra | 9 Вт | ~300 Вт при работе ИИ | тихий, по данным обзоров |
| DGX Spark | 25–45 Вт | 60–90 Вт при работе ИИ, пики до 200 Вт | зависит от версии прошивки |
| Мини-ПК на Ryzen AI Max+ 395 | ~13 Вт | 120–160 Вт | HP Z2 Mini под нагрузкой шумный |
| RTX 5090 (только карта) | — | до 575 Вт | плюс остальной ПК |
| RTX 5060 Ti (только карта) | — | до 180 Вт |
Данные взяты у производителей и из обзоров (ServeTheHome, Tom’s Hardware, Notebookcheck) и получены разными методами — воспринимайте их как ориентир.
Софт: чем запускать модель
- Ollama — самый простой старт на любой платформе; модель скачивается одной командой. На Mac начиная с версии 0.19 (пока в стадии предварительной версии и для отдельных моделей) использует MLX и нейроускорители M5.
- LM Studio — понятное приложение с графическим интерфейсом. Совет для Mac на M5: с моделями GGUF оно пока не задействует нейроускорители и читает промпты примерно вдвое медленнее; вместо них берите модели в формате MLX.
- llama.cpp — основа большинства других инструментов, с наибольшим числом настроек и самой быстрой поддержкой нового железа. На Ryzen AI Max попробуйте оба бэкенда: Vulkan обычно быстрее пишет, ROCm быстрее читает длинные промпты.
- MLX — библиотека Apple с лучшей производительностью на Mac, включая объединение нескольких Mac через Thunderbolt 5.
- vLLM, SGLang, TensorRT-LLM — серверные инструменты для NVIDIA на случай, когда одна модель обслуживает нескольких пользователей одновременно.
Самые частые ошибки при покупке
- Mac с 36 ГБ «для ИИ». У него более слабый чип, и для модели остаётся лишь около 27 ГБ.
- Ноутбук RTX Spark с 32 ГБ. Windows отдаёт GPU максимум 16 ГБ.
- Mac mini M6 с 16 ГБ. Более медленная память и лишь около 12 ГБ для модели.
- Ноутбук Copilot+ для локального ИИ. Повседневные инструменты NPU не используют.
- RTX 5080 вместо 5070 Ti только ради ИИ. Те же 16 ГБ, почти та же скорость.
- Игнорировать пропускную способность памяти. Большая, но медленная память означает медленный вывод у плотных моделей.
- Экономить на памяти. У Mac, Ryzen AI Max и RTX Spark память распаяна на плате, и добавить её позже нельзя.
Часто задаваемые вопросы
Хватит ли 16 ГБ для локального ИИ? Для моделей до 14–20 млрд параметров — да, например для gpt-oss-20b или Qwen3 14B. Моделям около 30 млрд нужно 24–32 ГБ, а моделям на 70 млрд — минимум 48 ГБ.
Mac или NVIDIA? Mac пишет быстрее и даёт больше памяти за те же деньги; NVIDIA быстрее читает промпты и поддерживает CUDA. В чате и агентах на MoE-моделях выигрывает Mac, в разработке, обучении и обслуживании нескольких пользователей — NVIDIA.
Что значит «MoE»? Mixture of experts, или смесь экспертов: у модели много параметров, но для каждого слова она использует лишь небольшую их часть. Ей нужно много памяти, но пишет она со скоростью модели поменьше.
Насколько быстро должна писать модель? Около 15 токенов в секунду соответствует скорости чтения. Для комфортного чата хватает 30 и больше, для агентов-программистов, которые генерируют много текста, лучше 50 и больше.
Локальный ИИ дешевле подписки? Обычно нет: моделям, сопоставимым с лучшими облачными сервисами, нужны машины стоимостью во многие тысячи долларов. Главные причины — приватность, контроль над своими данными и независимость.
Можно ли объединить несколько компьютеров? Да. Два DGX Spark соединяются кабелем QSFP, Mac — через Thunderbolt 5 по RDMA (с помощью MLX или exo). Mac mini M6 так не умеет, поскольку у него только Thunderbolt 4.
Как мы сравнивали и откуда данные
Мы не тестировали устройства сами. Цифры взяты из проверенных источников, и мы всегда указываем их на графиках. Скорость мы сравниваем в одной программе (llama.cpp), потому что другая программа или другое квантование легко сдвигают результаты на 20–50%. Замеры сообщества (GitHub, форумы) отмечены. Цены — рекомендованные розничные цены в США из анонсов производителей и обзоров, с указанием даты.
- Вытеснение модели в ОЗУ, RTX 5060 Ti: inventivehq.com/blog/vram-offload-cliff-gpu-layers-benchmark
- Бенчмарк DGX Spark: github.com/ggml-org/llama.cpp/blob/master/benches/dgx-spark/dgx-spark.md
- Руководство по gpt-oss и замеры на GPU: github.com/ggml-org/llama.cpp/discussions/15396
- M5 Max и LM Studio: github.com/lmstudio-ai/lmstudio-bug-tracker/issues/2040
- Ryzen AI Max (Strix Halo): strix-halo-toolboxes.com, llm-tracker.info/_TOORG/Strix-Halo
- Apple: apple.com/mac-studio/specs, apple.com/mac-mini/specs, machinelearning.apple.com/research/mlx-distributed-inference
- M5 Ultra: macstories.net/stories/m5-ultra-mac-studio-review-the-dream-mac-for-local-ai-agents
- RTX Spark: theregister.com (16 октября 2026 года), servethehome.com, storagereview.com
- Видеокарты GeForce: nvidia.com/en-us/geforce/graphics-cards/compare, hardware-corner.net/gpu-llm-benchmarks
- Рейтинги llama.cpp: github.com/ggml-org/llama.cpp/discussions/15013 и /10879
- Copilot+ PC: microsoft.com/windows/windows-11-specifications, docs.ollama.com/gpu, fastflowlm.com
- Размеры моделей: huggingface.co (репозитории ggml-org, unsloth и bartowski)
- Цены: Apple Newsroom, NVIDIA Newsroom и форумы разработчиков, servethehome.com, storagereview.com, notebookcheck.net, tomshardware.com