Our website contains links to partner sites. If you click from our site to the partner's site and purchase their services there, we will receive a commission for mediation (Find out more information). This form of cooperation does not affect the objectivity of our reviews. With each purchase made through links from our site, you support our editorial office so that we can create quality and useful content in the future. Thank you.

Hardware para IA local en 2026: cómo elegir un ordenador para ejecutar LLM en casa
Contents
¿Quieres ejecutar modelos de lenguaje en tu propio equipo, sin suscripciones, sin que tus datos salgan de tu mesa y sin depender de una conexión a internet? Entonces el procesador y la pegatina de «TOPS» de la caja importan mucho menos que otras dos cosas: cuánta memoria puede usar el modelo y a qué velocidad puede leer el ordenador esa memoria. Esta guía explica cómo funciona de verdad la IA local en un ordenador, cuánta memoria necesitan los modelos más populares y qué rendimiento ofrece en la práctica el hardware actual: desde una tarjeta gráfica que añades al PC que ya tienes hasta una estación de trabajo para todo un equipo. Cada dispositivo viene con cifras verificadas, fuentes y un veredicto claro sobre a quién le conviene; algunas secciones incluyen además un vídeo corto.
Lo esencial en 30 segundos
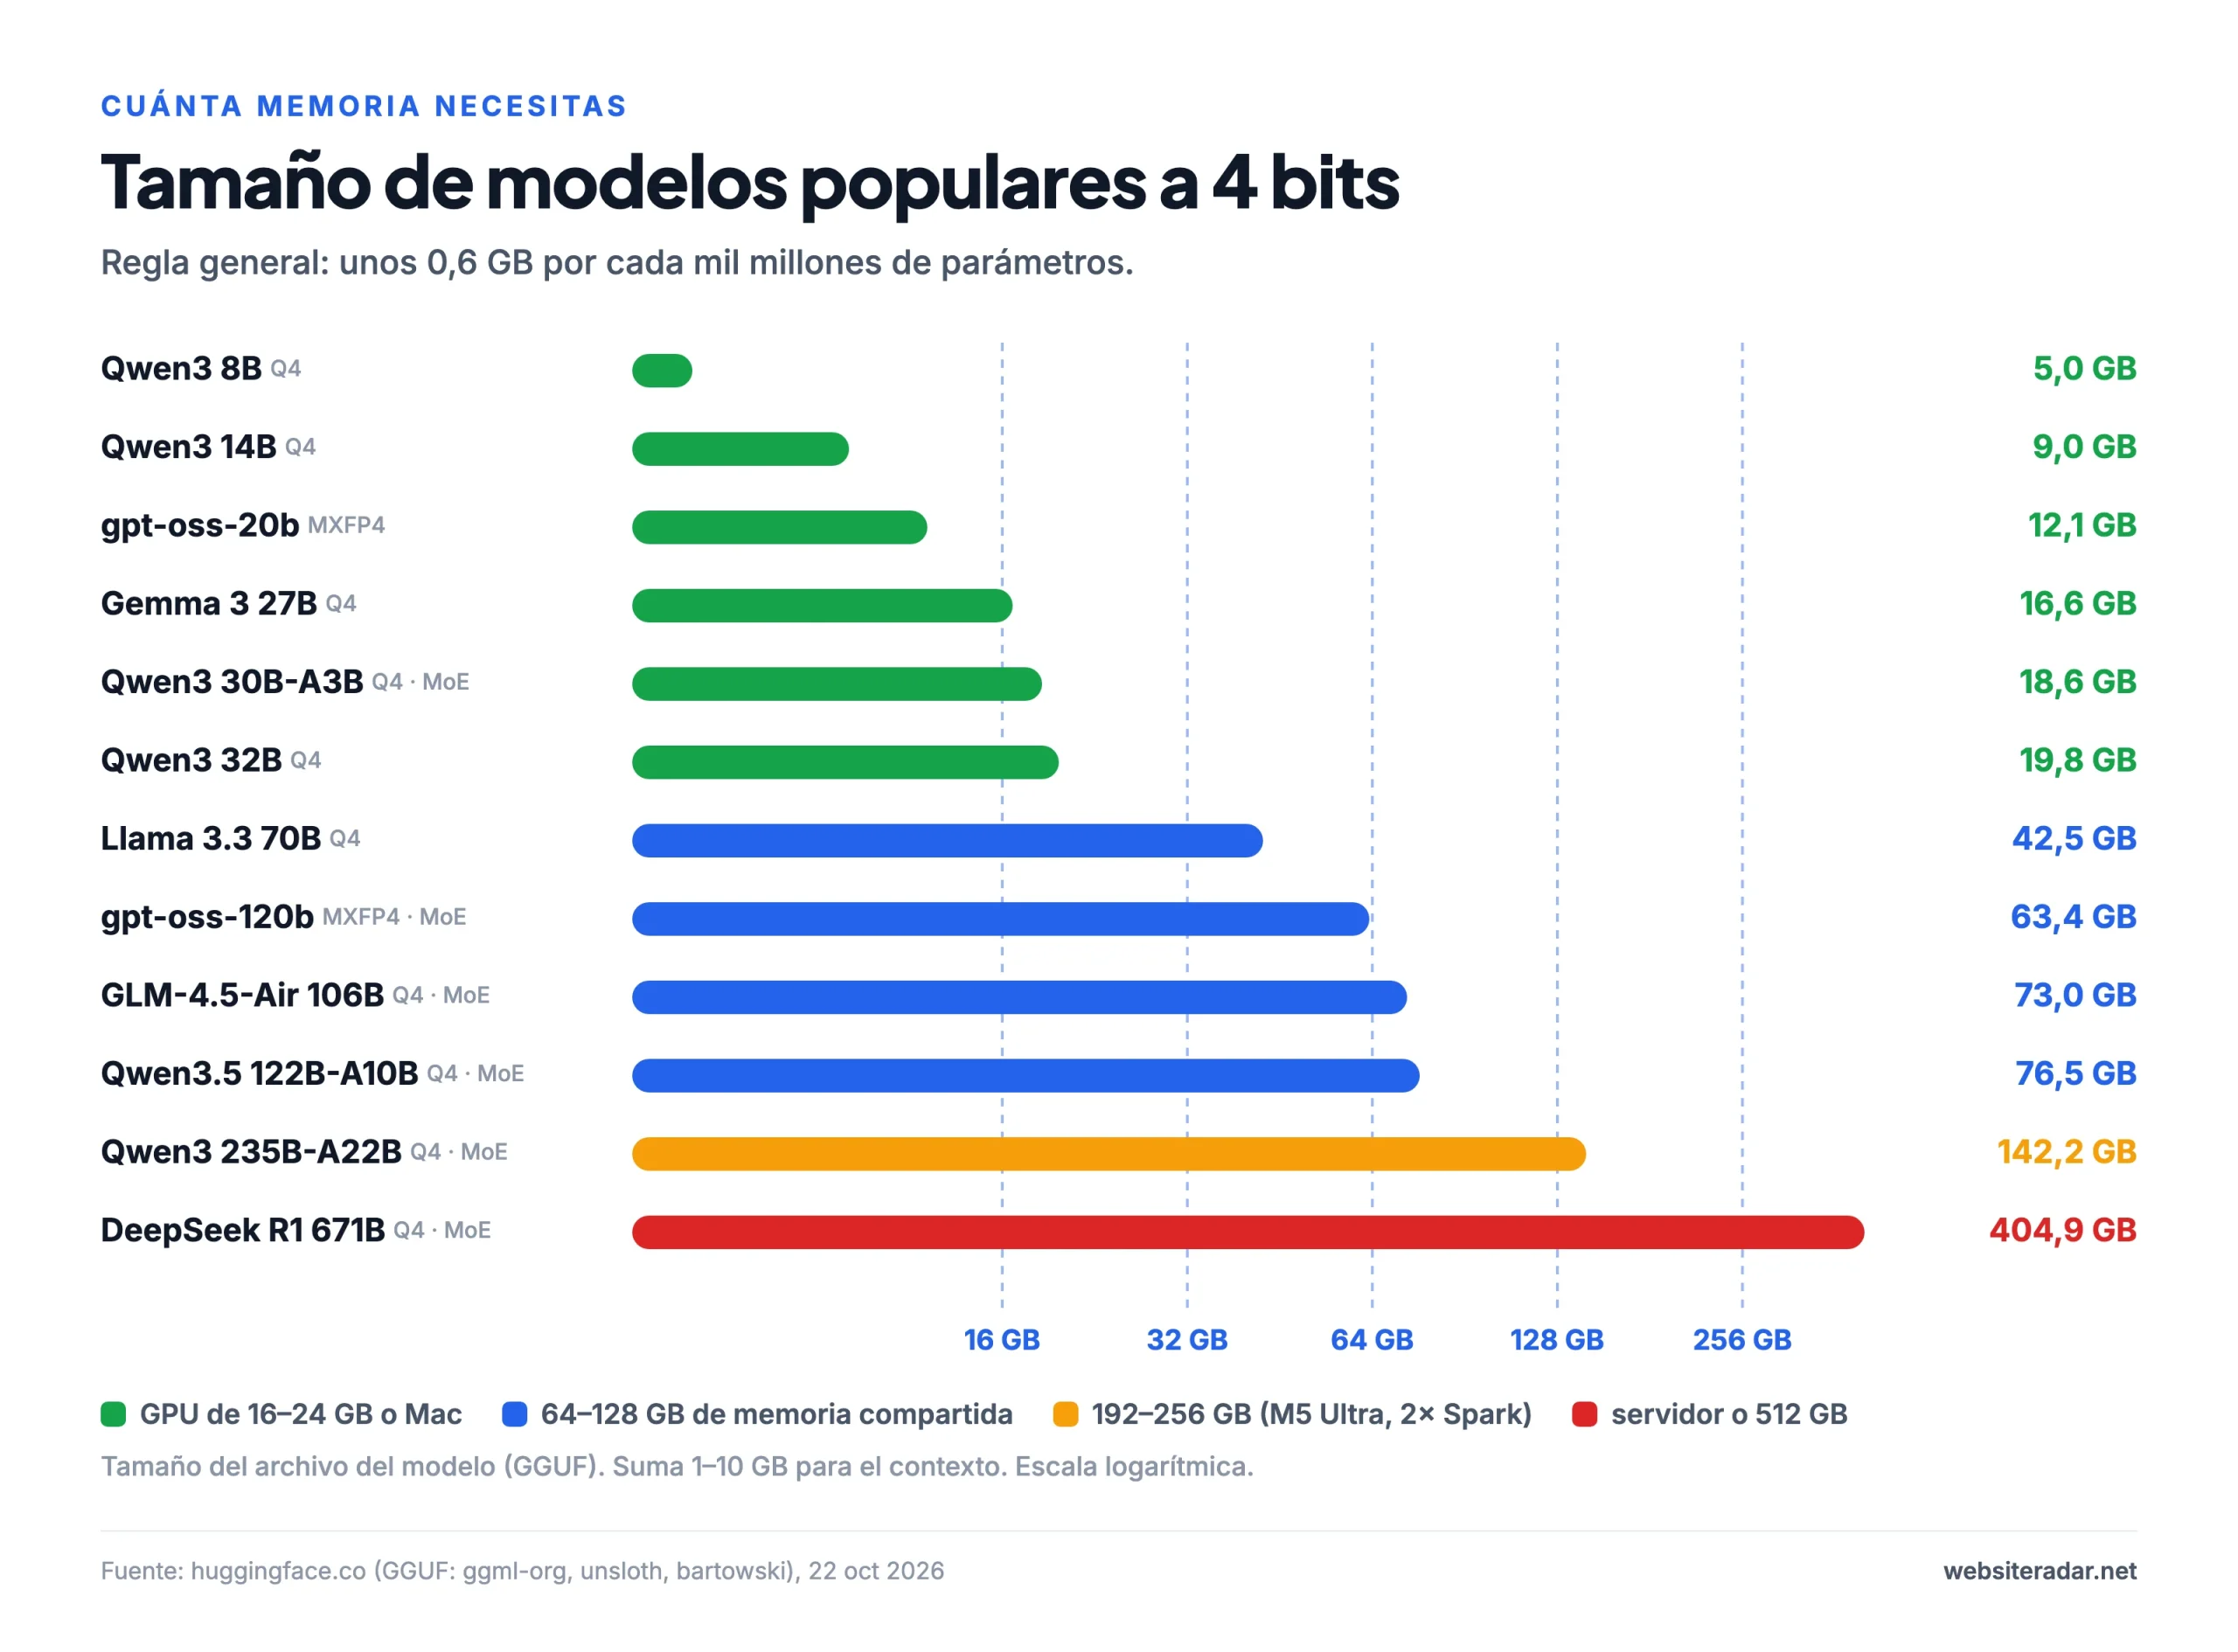
- La memoria lo decide todo. El modelo completo tiene que caber en una memoria rápida a la que llegue la GPU. A 4 bits, calcula aproximadamente 0,6 GB por cada mil millones de parámetros.
- El ancho de banda de memoria marca lo rápido que escribe el modelo; la potencia de cálculo, lo rápido que lee un prompt largo. Por eso un Mac escribe más rápido que un DGX Spark, mientras que el Spark lee los documentos largos más deprisa.
- La mejor compra ahora mismo: Mac Studio M5 Max con 128 GB (respuestas rápidas), Ryzen AI Max+ 395 con 128 GB (la memoria grande más barata) y RTX 5060 Ti 16 GB (la puerta de entrada sensata más barata).
- Un «PC con IA» con NPU no es un ordenador para IA local. Ni Ollama ni LM Studio usan la NPU.
No hemos probado estos equipos nosotros mismos: las cifras proceden de las fuentes que citamos al final, y las mediciones de la comunidad están señaladas como tales. Los precios son precios oficiales en EE. UU. con su fecha; la escasez de memoria hizo subir muchos de ellos a lo largo de 2026.
Qué comprar: recomendaciones rápidas
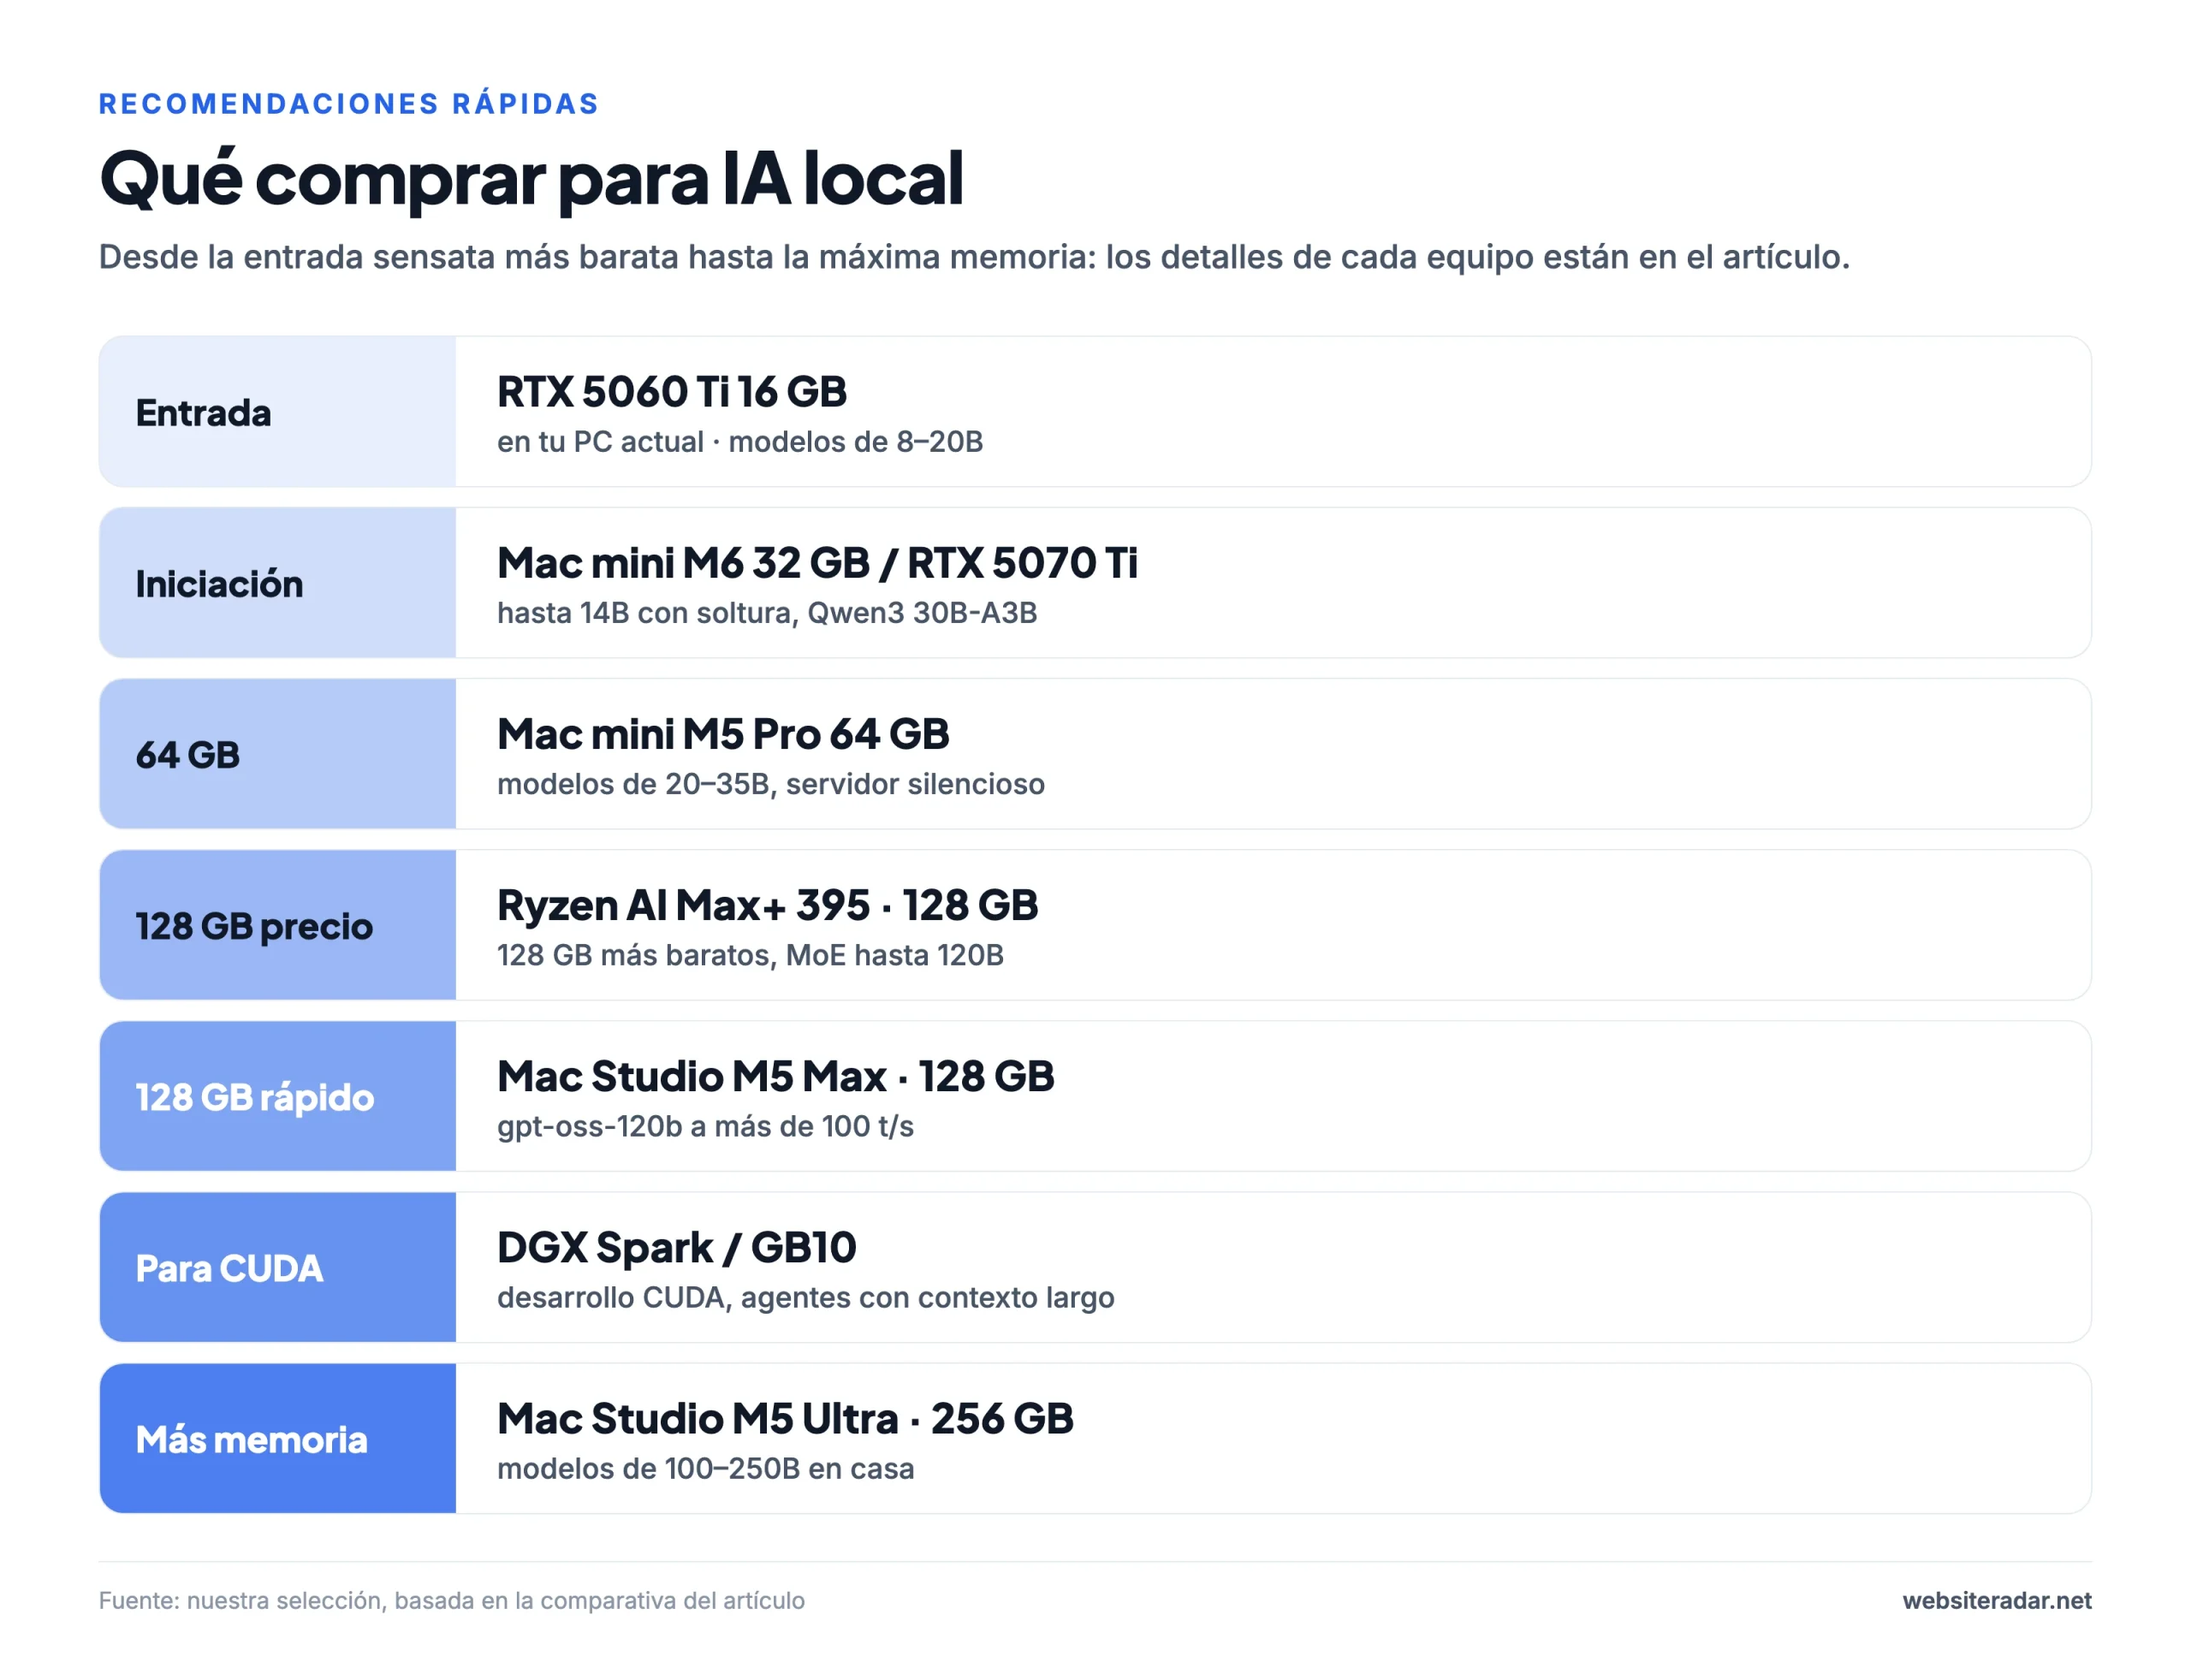
Si no quieres leerte toda la guía, aquí tienes el atajo. Cada recomendación se analiza en detalle más abajo, algunas con vídeo.
| Categoría | Recomendación | Modelos que mueve |
|---|---|---|
| Entrada | RTX 5060 Ti 16 GB en tu PC actual | 8–20B (Qwen3 14B, gpt-oss-20b) |
| Iniciación | Mac mini M6 con 32 GB o RTX 5070 Ti | hasta 14B con soltura, Qwen3 30B-A3B |
| 64 GB | Mac mini M5 Pro con 64 GB | 20–35B, un servidor doméstico silencioso |
| 128 GB, mejor precio | Ryzen AI Max+ 395 con 128 GB | modelos MoE grandes de hasta 120B |
| 128 GB, más rápido | Mac Studio M5 Max con 128 GB | gpt-oss-120b a más de 100 tokens/s |
| Desarrollo CUDA | DGX Spark u otro equipo con GB10 | desarrollo CUDA, agentes de programación |
| Máxima memoria | Mac Studio M5 Ultra con 256 GB | modelos de 100–250B en casa |
| Para equipos | RTX PRO 6000 | 70–120B para todo un equipo |
Por qué ejecutar la IA en local y qué no esperar
Un modelo local se ejecuta en tu propio ordenador. Tus datos no salen de tu mesa, no pagas suscripción mensual ni tarifas por token, el modelo funciona sin conexión y nadie puede cambiarlo o retirarlo de la noche a la mañana. Eso lo convierte en una buena opción para documentos sensibles, asistentes de programación que trabajan con el código de la empresa, automatizaciones que envían miles de peticiones al día o, simplemente, para experimentar por diversión.
Hay dos pegas. La primera: los modelos abiertos que caben en hardware doméstico son listos, pero no están al nivel de los mejores servicios en la nube. La segunda: el hardware no es barato y, en 2026, la escasez de memoria ha ido empujando los precios al alza. Las razones principales para apostar por lo local son la privacidad, el control y la independencia, no el ahorro.
Cómo funciona un modelo en tu ordenador
Cuando le haces una pregunta a un modelo, ocurren dos fases, y cada una está limitada por algo distinto:
- Lectura del prompt (prefill). El modelo procesa toda tu entrada de una vez: la pregunta, un documento pegado, el código de tu proyecto. Esta fase depende de la potencia de cálculo de la GPU y determina cuánto esperas hasta la primera palabra de la respuesta. Con una pregunta corta tarda una fracción de segundo; con un documento de decenas de miles de palabras puede llevar minutos.
- Escritura de la respuesta (decode). El modelo genera el texto palabra a palabra (en rigor, token a token). Por cada token tiene que leer el modelo entero de la memoria o, en los modelos mixture of experts, solo la parte activa. Esta fase depende del ancho de banda de memoria: cuántos gigabytes por segundo es capaz de leer el chip.
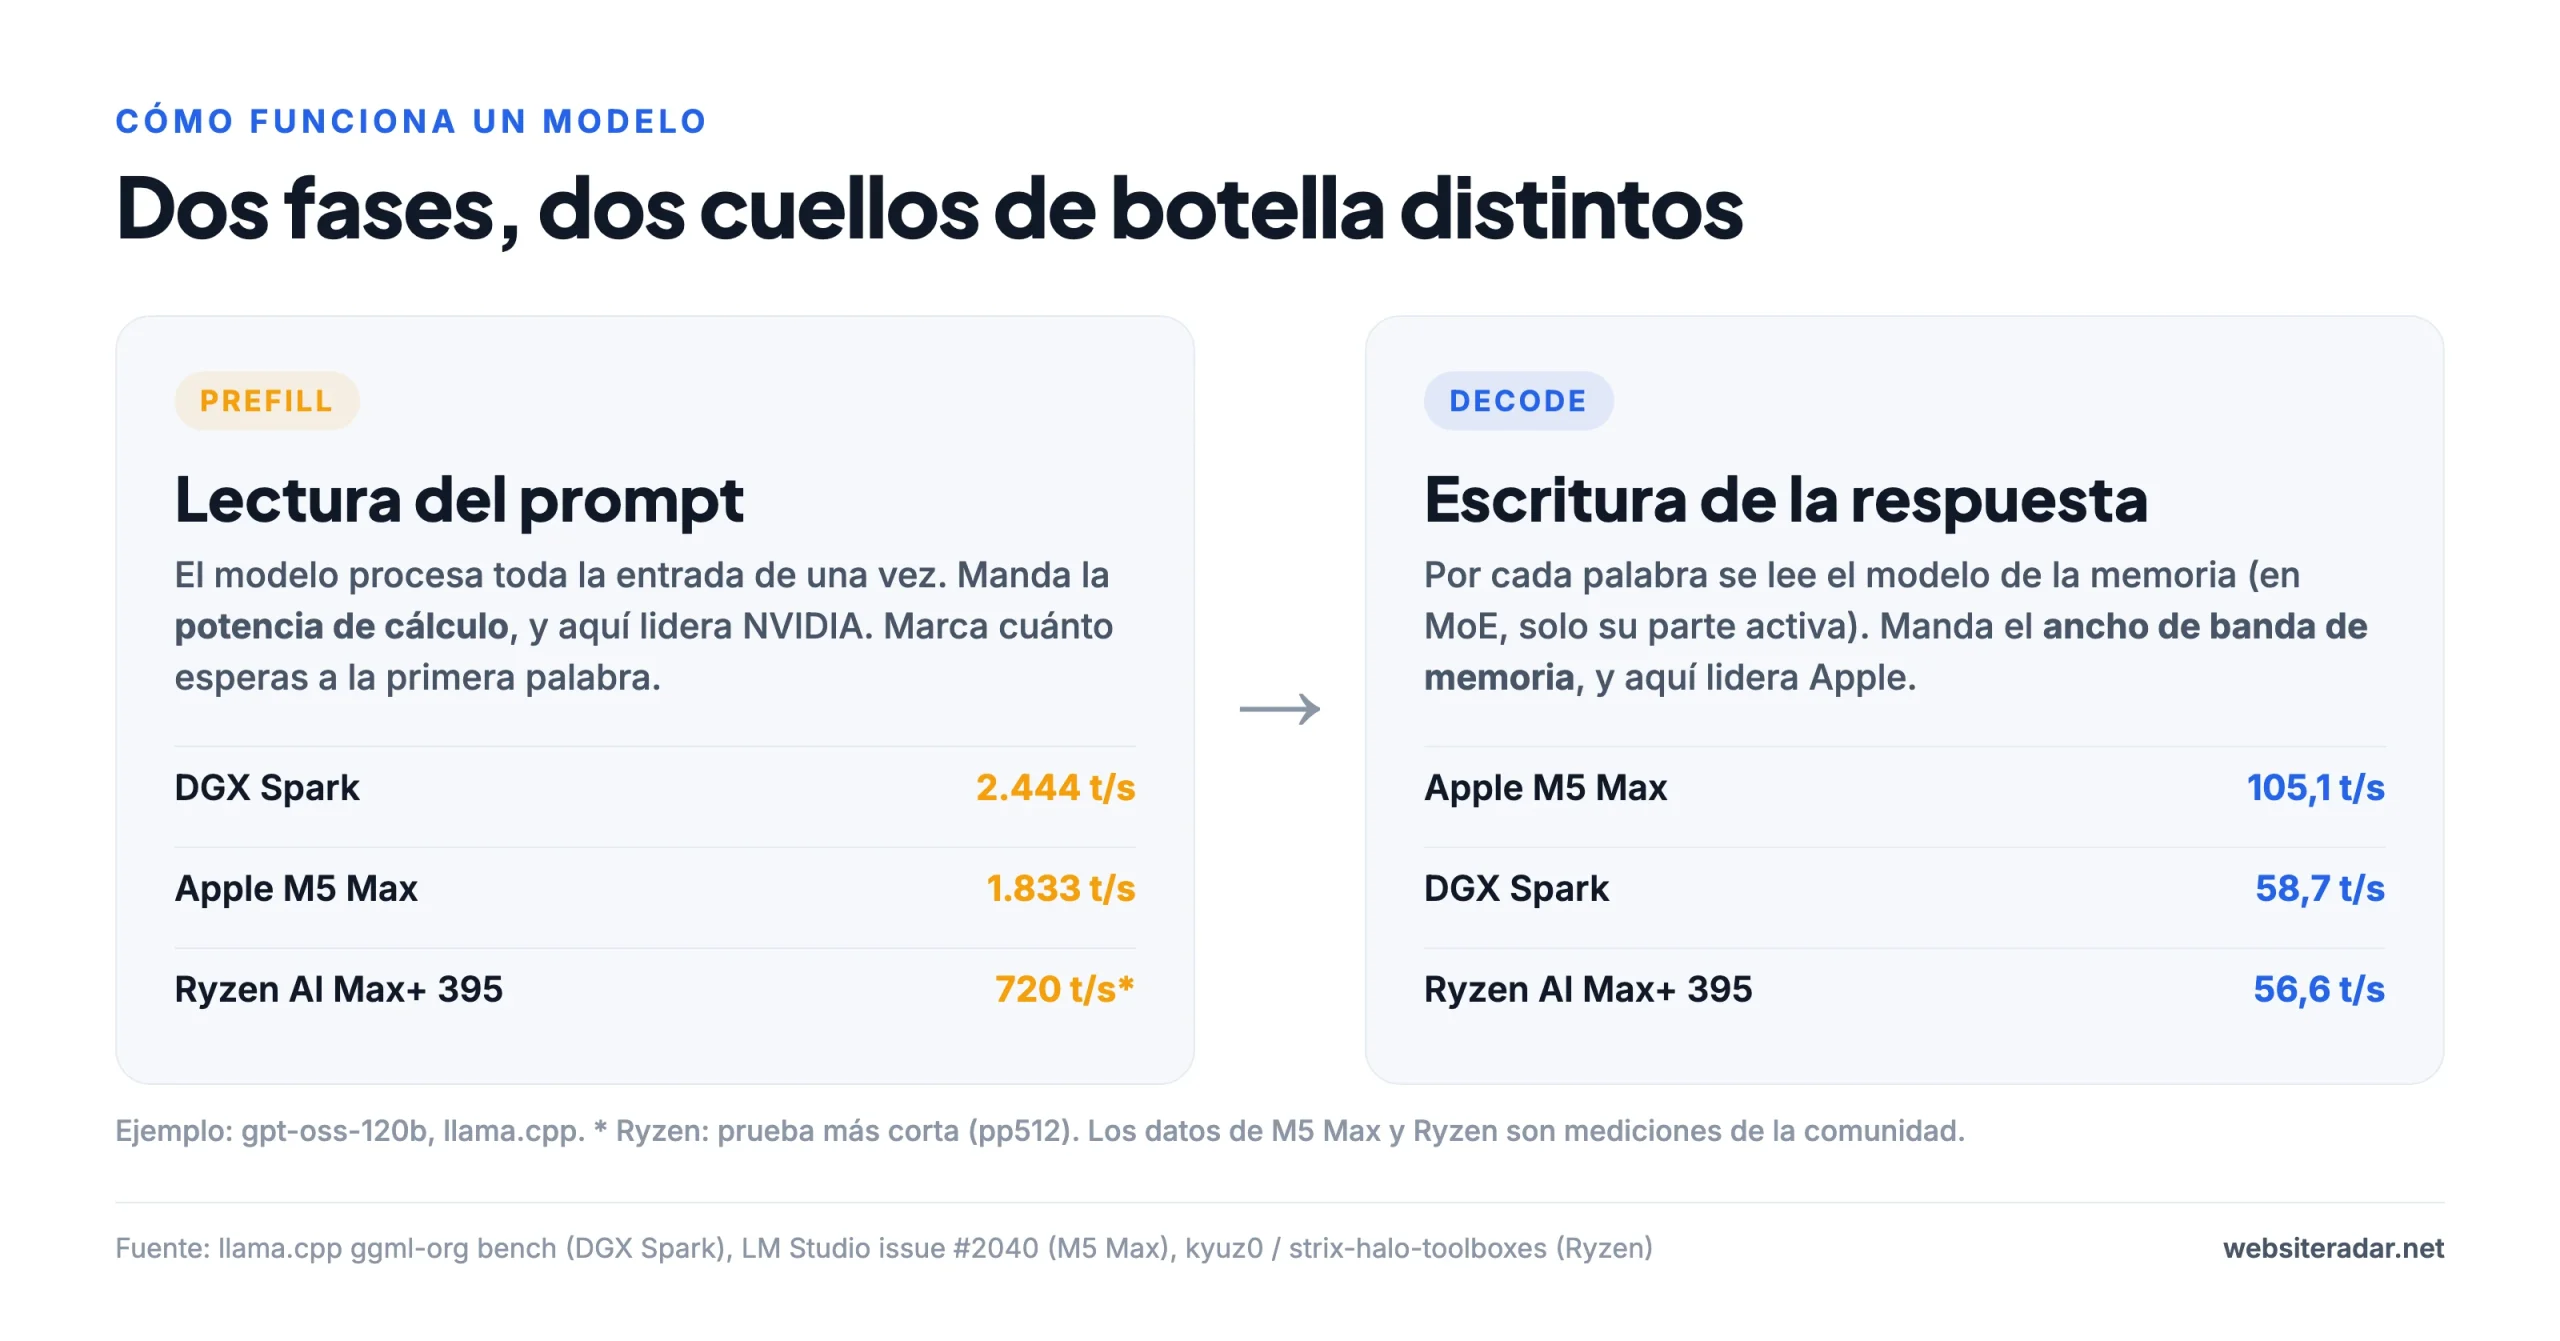
La diferencia en la práctica: en un chat, lo que notas es la rapidez al escribir (y ahí brilla el Mac). Con agentes de programación y trabajo con documentos, que envían al modelo cantidades enormes de contexto una y otra vez, leer rápido el prompt importa igual (y ahí manda NVIDIA). La velocidad se mide en tokens por segundo; un token equivale aproximadamente a tres cuartos de palabra. Unos 15 tokens por segundo equivalen a la velocidad de lectura; por encima de 50, el modelo se siente ágil.
Cuánta memoria necesitas
El modelo completo tiene que estar en una memoria rápida a la que pueda acceder la GPU: o bien la VRAM de la tarjeta gráfica, o bien la memoria compartida (unificada) de los Mac, el DGX Spark o el Ryzen AI Max. Si no cabe, una parte se desborda a la RAM normal del sistema y la velocidad se desploma. En una prueba con una RTX 5060 Ti, sacar de la GPU solo una sexta parte de las capas de Qwen 14B redujo la velocidad de escritura de 43 a 12,5 tokens por segundo; solo con la CPU se quedó en 2,9.
| Modelo | Tipo | Tamaño (4 bits) | Dónde cabe |
|---|---|---|---|
| Llama 3.1 8B / Qwen3 8B | denso | 4,9–5,0 GB | cualquier equipo con 8 GB |
| Qwen3 14B | denso | 9,0 GB | 12–16 GB |
| gpt-oss-20b | MoE | 12,1 GB (MXFP4) | 16 GB |
| Gemma 3 27B | denso | 16,6 GB | 24 GB |
| Qwen3 30B-A3B | MoE, 3B activos | 18,6 GB | 24 GB |
| Qwen3 32B | denso | 19,8 GB | 24–32 GB |
| Llama 3.3 70B | denso | 42,5 GB | 48 GB o más |
| gpt-oss-120b | MoE | 63,4 GB (MXFP4) | 96–128 GB |
| GLM-4.5-Air 106B | MoE | 73,0 GB | 96 GB o más |
| Qwen3.5 122B-A10B | MoE | 76,5 GB | 96–128 GB |
| Qwen3 235B-A22B | MoE | 142,2 GB | 192–256 GB |
| DeepSeek R1 671B | MoE | 404,9 GB | 512 GB |
El contexto también ocupa memoria
Además del propio modelo, necesitas memoria para el contexto (la caché KV): todo lo que el modelo «recuerda» de la conversación o del documento. En Llama 3.3 70B son unos 10 GB extra con un contexto de 32.000 tokens y alrededor de 40 GB con 128.000 tokens. Los modelos gpt-oss son mucho más austeros gracias a una ventana deslizante: gpt-oss-120b necesita como mucho unos 9 GB incluso con 128.000 tokens. La velocidad de escritura también cae a medida que crece el contexto: gpt-oss-120b en un M5 Max escribe unos 80 tokens por segundo con un contexto corto, pero solo 14 con 128.000 tokens.
No toda la memoria es para la GPU
- macOS deja que la GPU use por defecto aproximadamente el 75% de la RAM (Apple no publica la cifra exacta). Un Mac de 64 GB ofrece, por tanto, unos 48 GB para el modelo, y uno de 128 GB, unos 96 GB. Puedes subir el límite con
sudo sysctl iogpu.wired_limit_mb=…, pero se restablece al reiniciar. - Windows en Ryzen AI Max reparte la memoria en la BIOS con una proporción fija: la GPU recibe como máximo 96 GB de 128 GB. En Linux puede llegar a unos 124 GB.
- Los portátiles NVIDIA RTX Spark vienen en Windows con un reparto aproximado de 50:50, y como máximo se pueden asignar manualmente 96 GB de 128 GB. La versión de 32 GB solo le da 16 GB a la GPU.
- DGX Spark asigna la memoria de forma dinámica en Linux, así que el modelo puede usar la mayor parte de los 128 GB.
Cuantización y MoE, explicados de forma sencilla
La cuantización es una forma de comprimir modelos: en lugar de 16 bits por parámetro se usan 8 o 4. A 4 bits (con etiquetas como Q4, Q4_K_M o MXFP4), un modelo ocupa más o menos una cuarta parte de su tamaño original y la calidad baja solo ligeramente; es una opción por defecto razonable para uso doméstico. Ocho bits (Q8) es casi sin pérdidas, pero ocupa el doble.
Mixture of experts (MoE), o mezcla de expertos, es una arquitectura en la que el modelo tiene muchísimos parámetros, pero solo usa una pequeña parte de ellos para cada palabra. gpt-oss-120b tiene 117.000 millones de parámetros, pero solo activa unos 5.000 millones en cada paso; Qwen3 30B-A3B, apenas 3.000 millones. Un modelo así necesita mucha memoria, pero escribe a la velocidad de uno mucho más pequeño. Eso hace que los modelos MoE sean ideales para máquinas con una memoria compartida grande pero más lenta: DGX Spark, Ryzen AI Max o los Mac. Los modelos densos (Llama 70B, Qwen3 32B), en cambio, leen el modelo entero por cada palabra y van a paso de tortuga con una memoria lenta.
Ancho de banda de memoria: por qué un Mac escribe más rápido que un Spark
La velocidad de escritura se puede estimar bastante bien: el ancho de banda de memoria dividido entre la cantidad de datos que el modelo tiene que leer por token. Un modelo denso de 70B a 4 bits (~42 GB) no puede escribir, por tanto, a más de unos 6–7 tokens por segundo en un DGX Spark con 273 GB/s, y las mediciones lo sitúan en torno a 4,4.
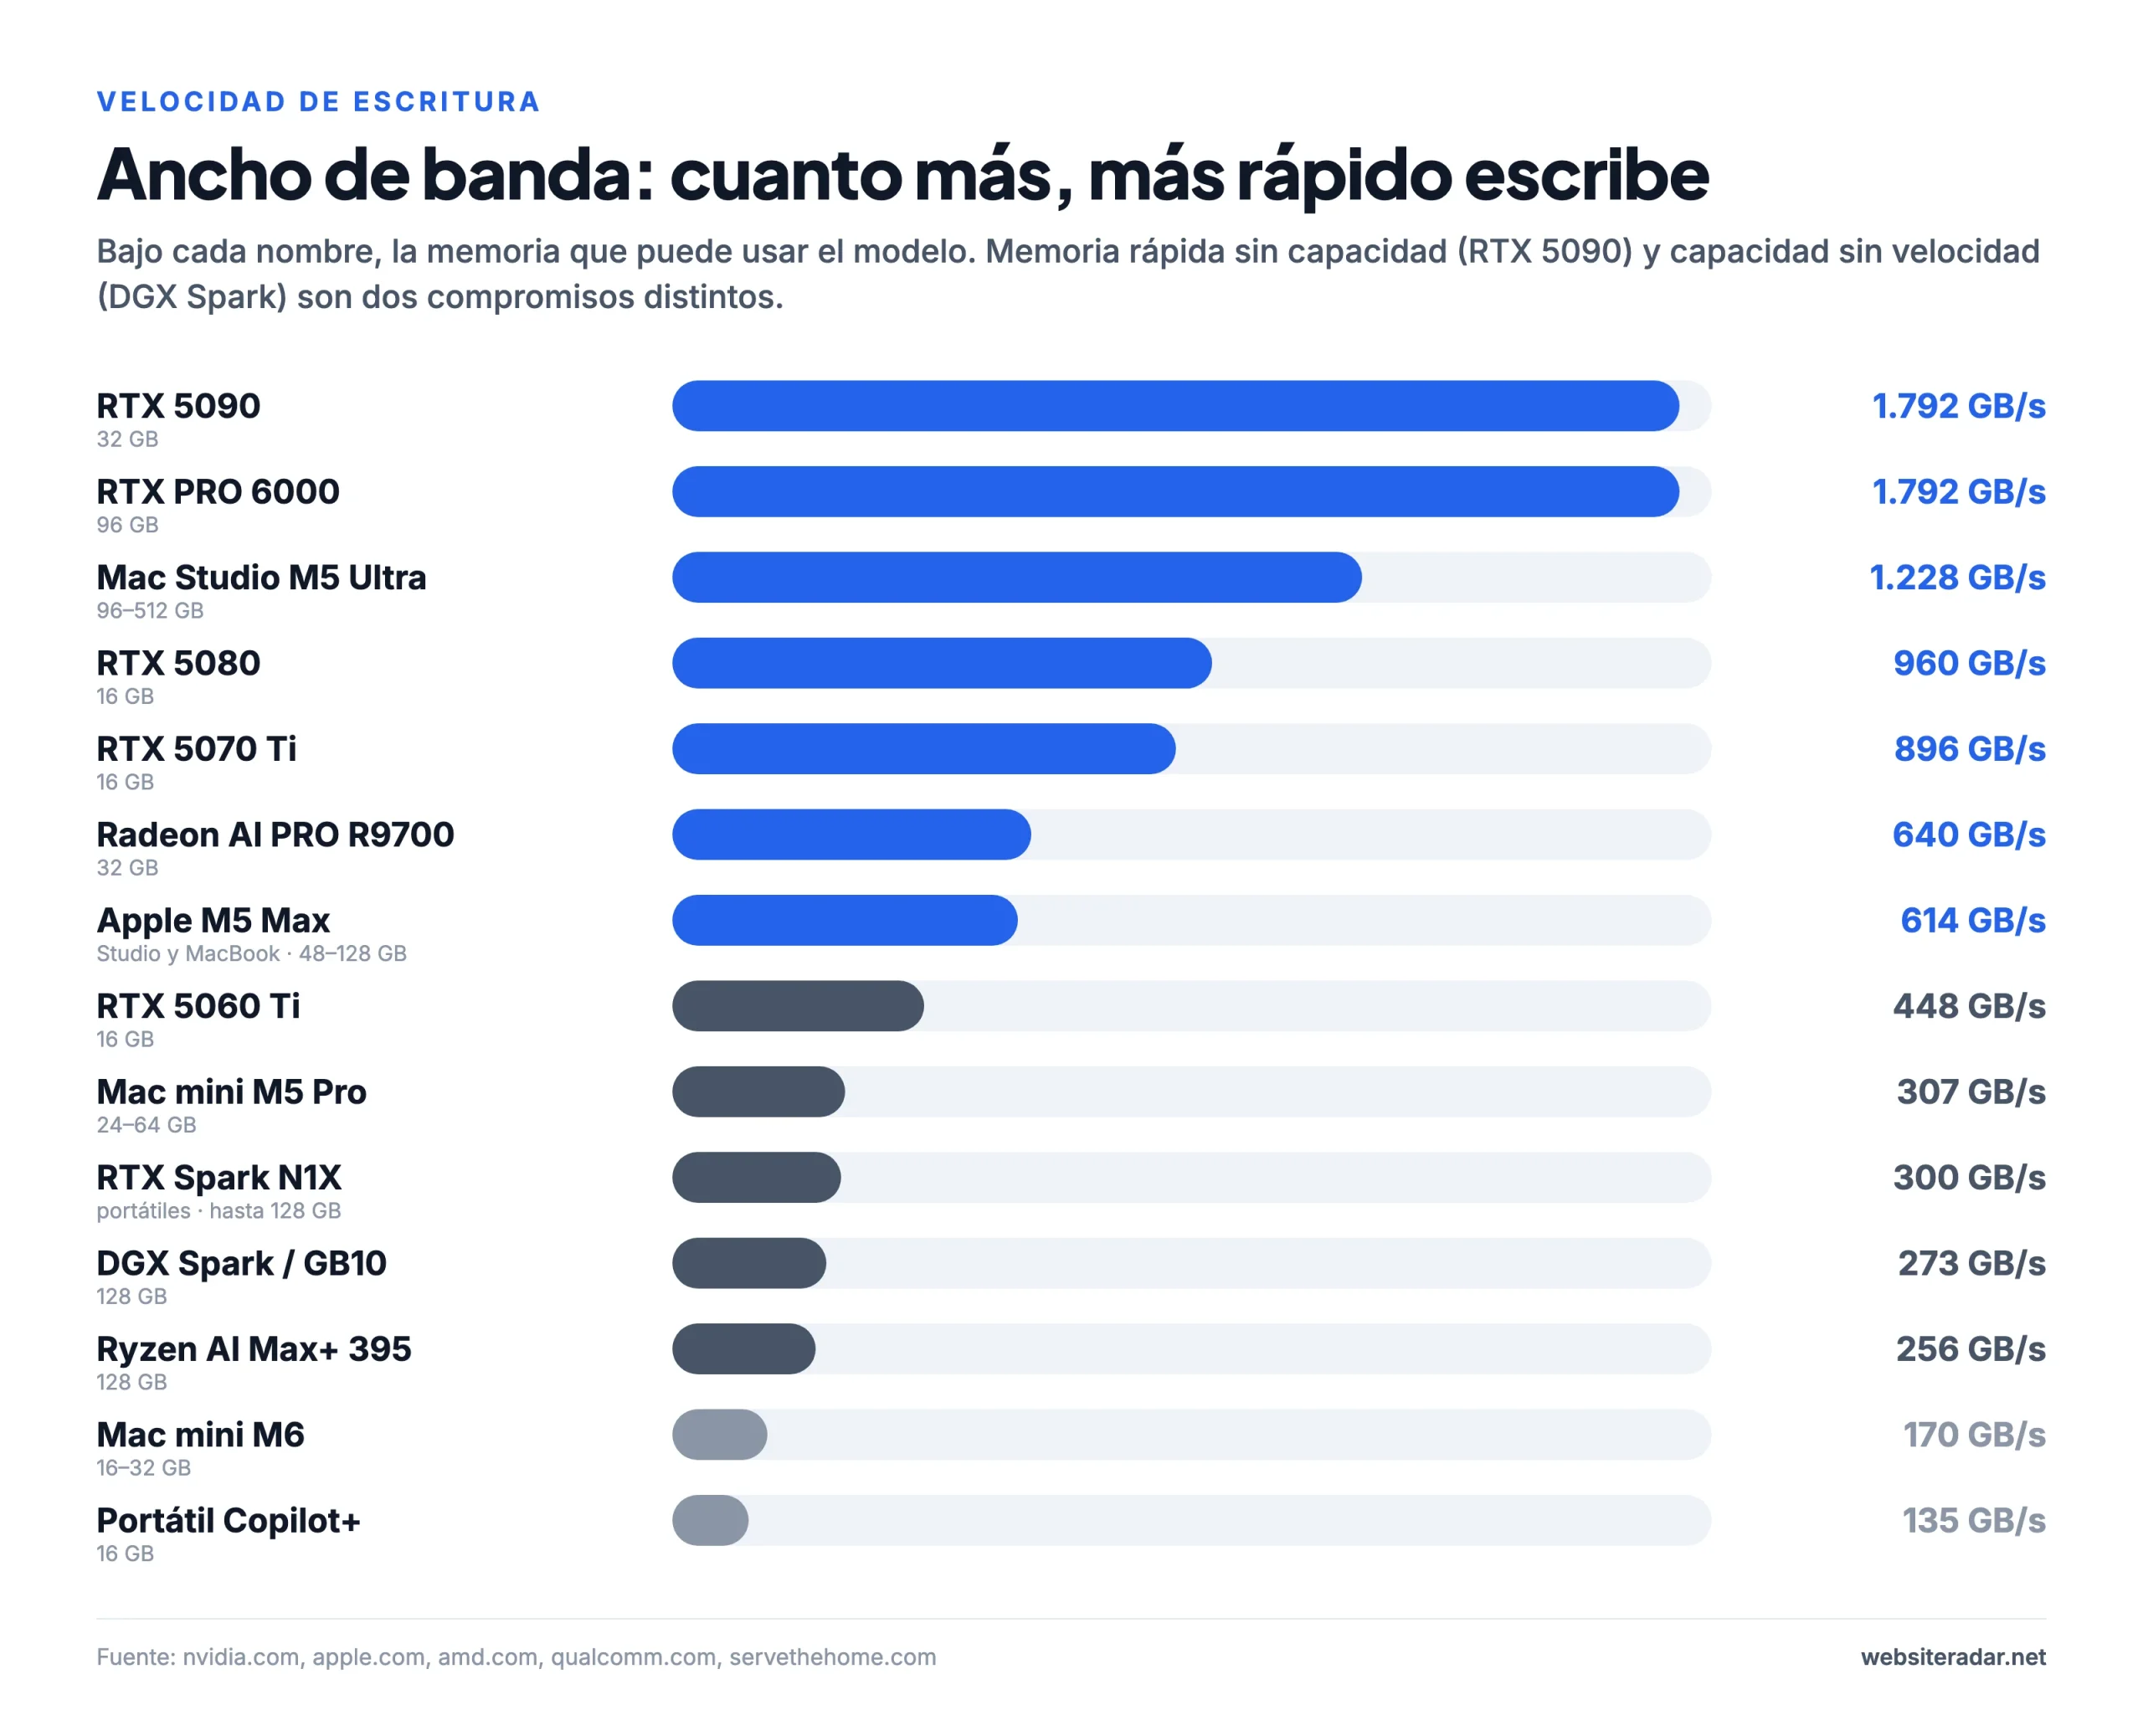
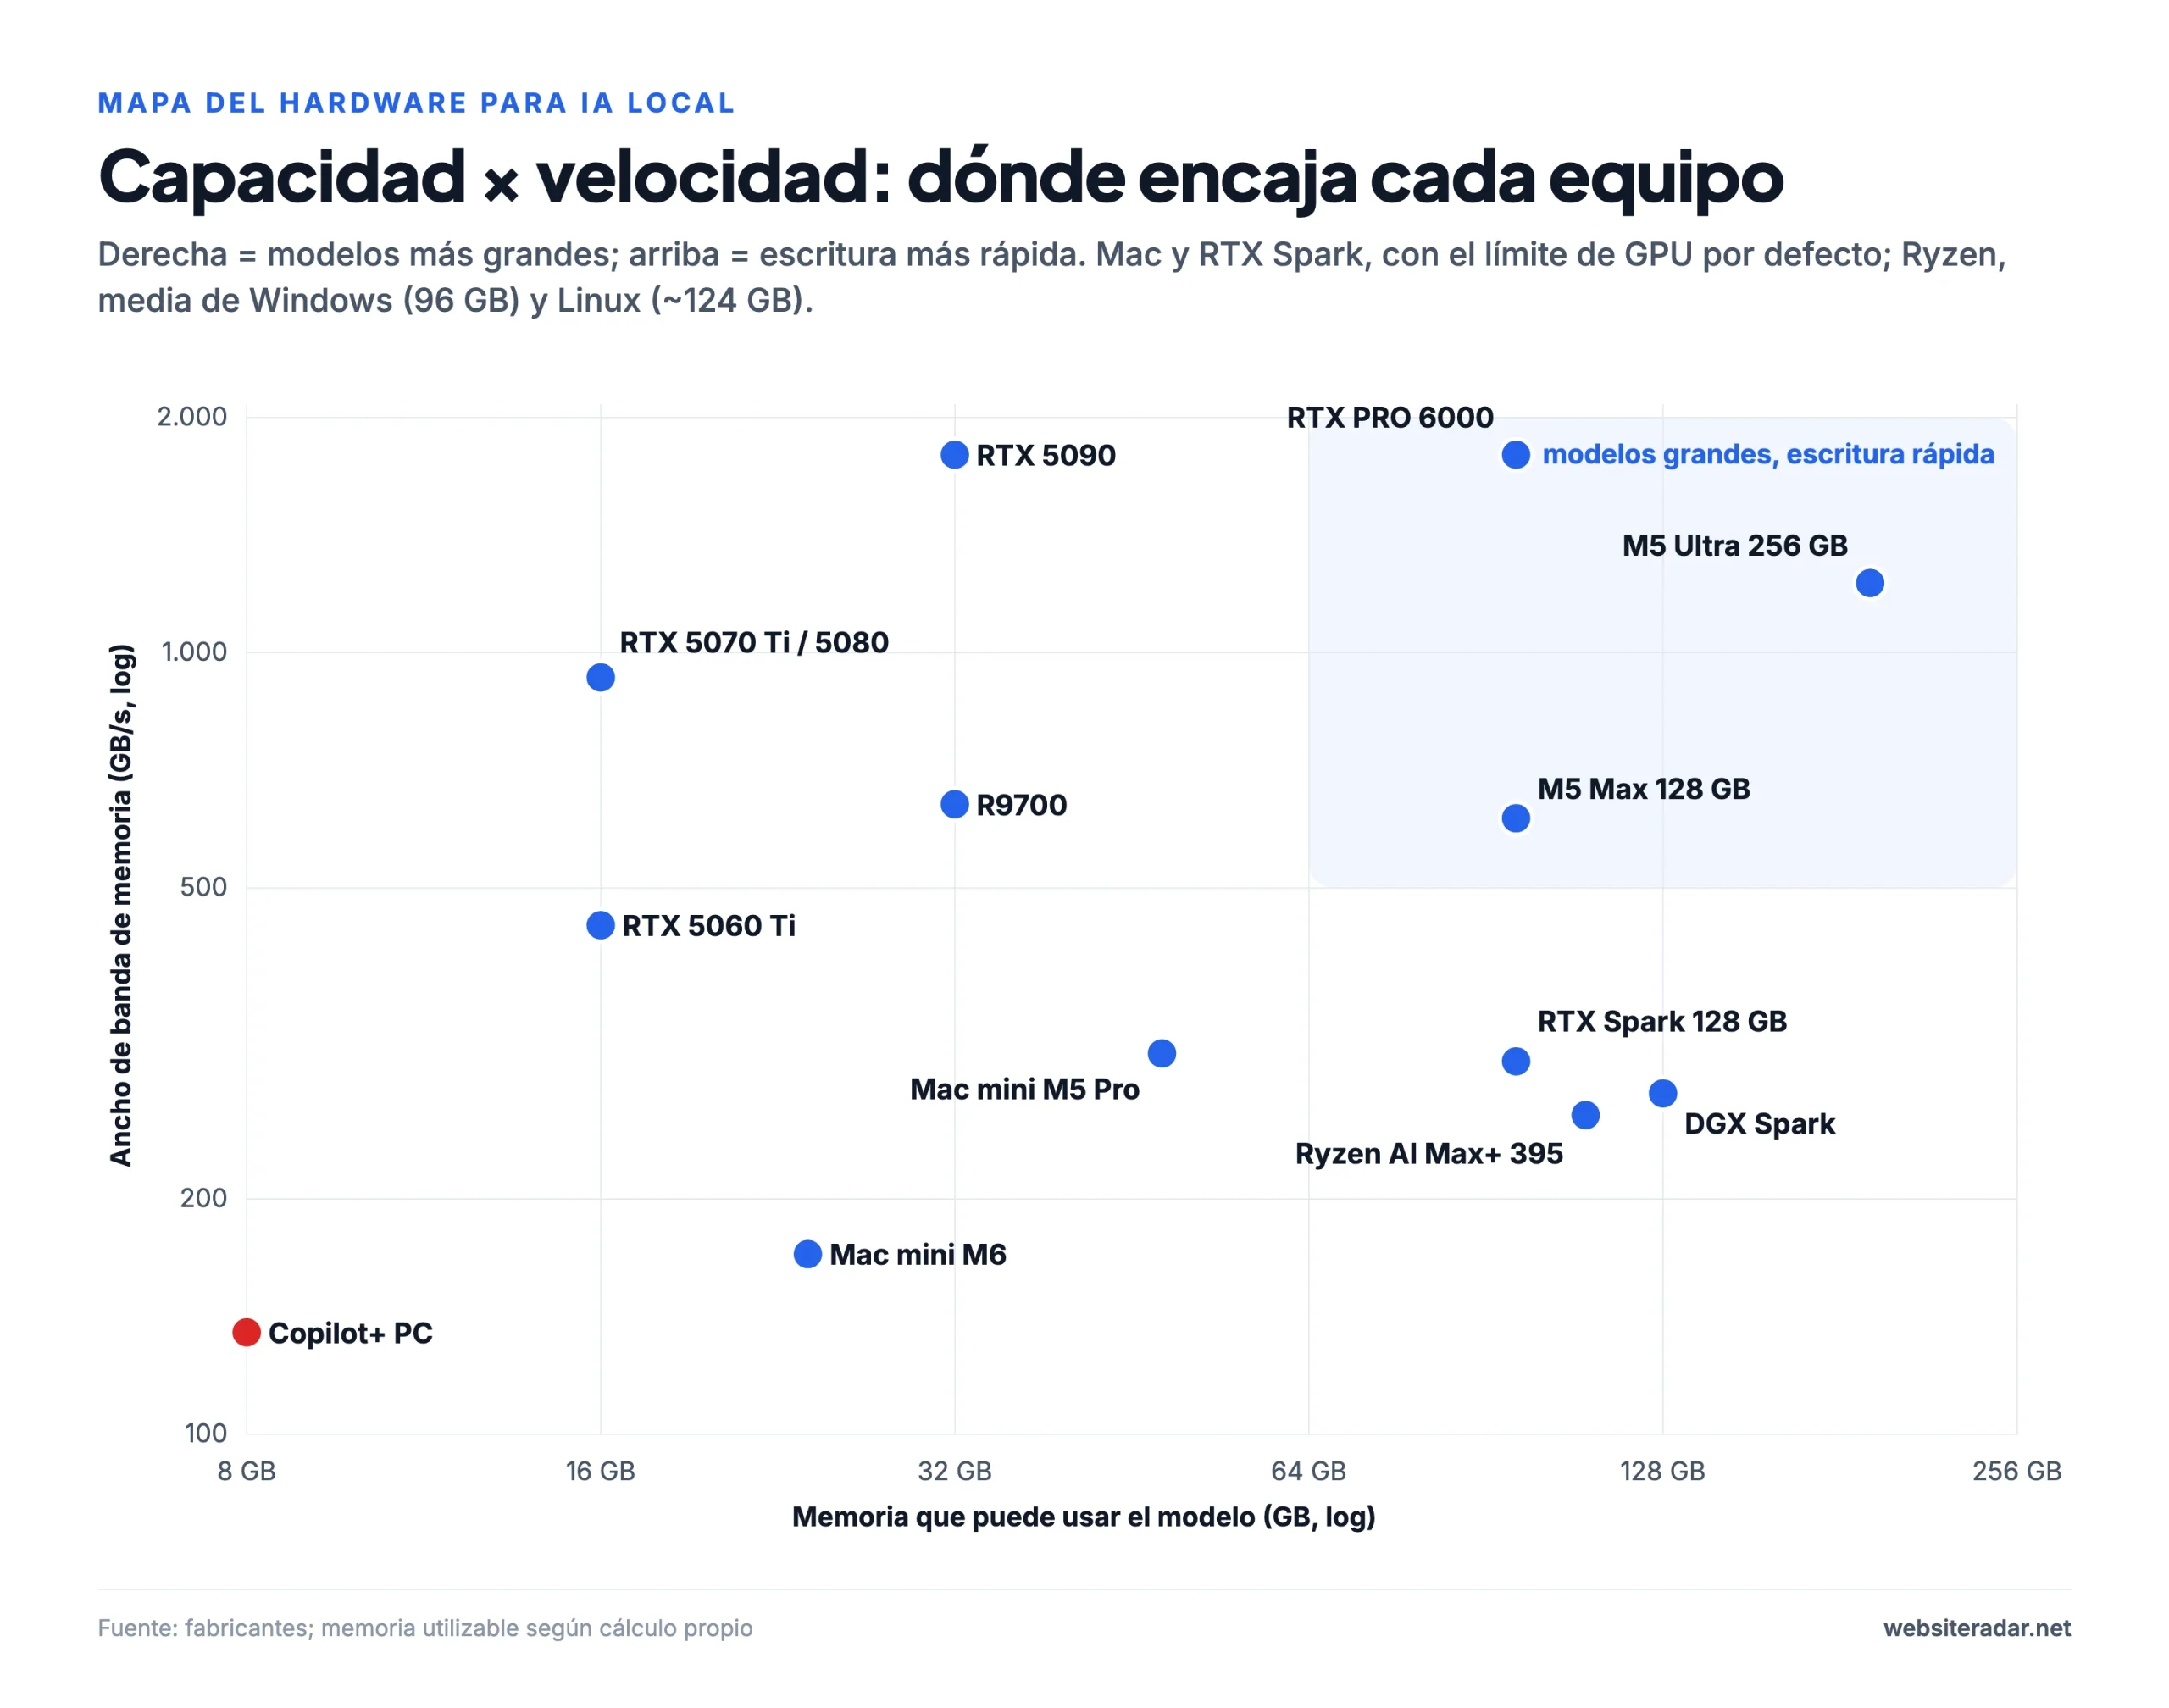
El mapa deja claro que no existe el dispositivo perfecto. Las tarjetas gráficas de NVIDIA tienen la memoria más rápida, pero poca capacidad. DGX Spark, Ryzen AI Max y RTX Spark tienen capacidad de sobra, pero una memoria más lenta. El Mac Studio con M5 Max, y sobre todo con M5 Ultra, combina ambas cosas, a cambio de renunciar a CUDA y de leer el prompt más despacio que NVIDIA.
El mismo modelo en distinto hardware
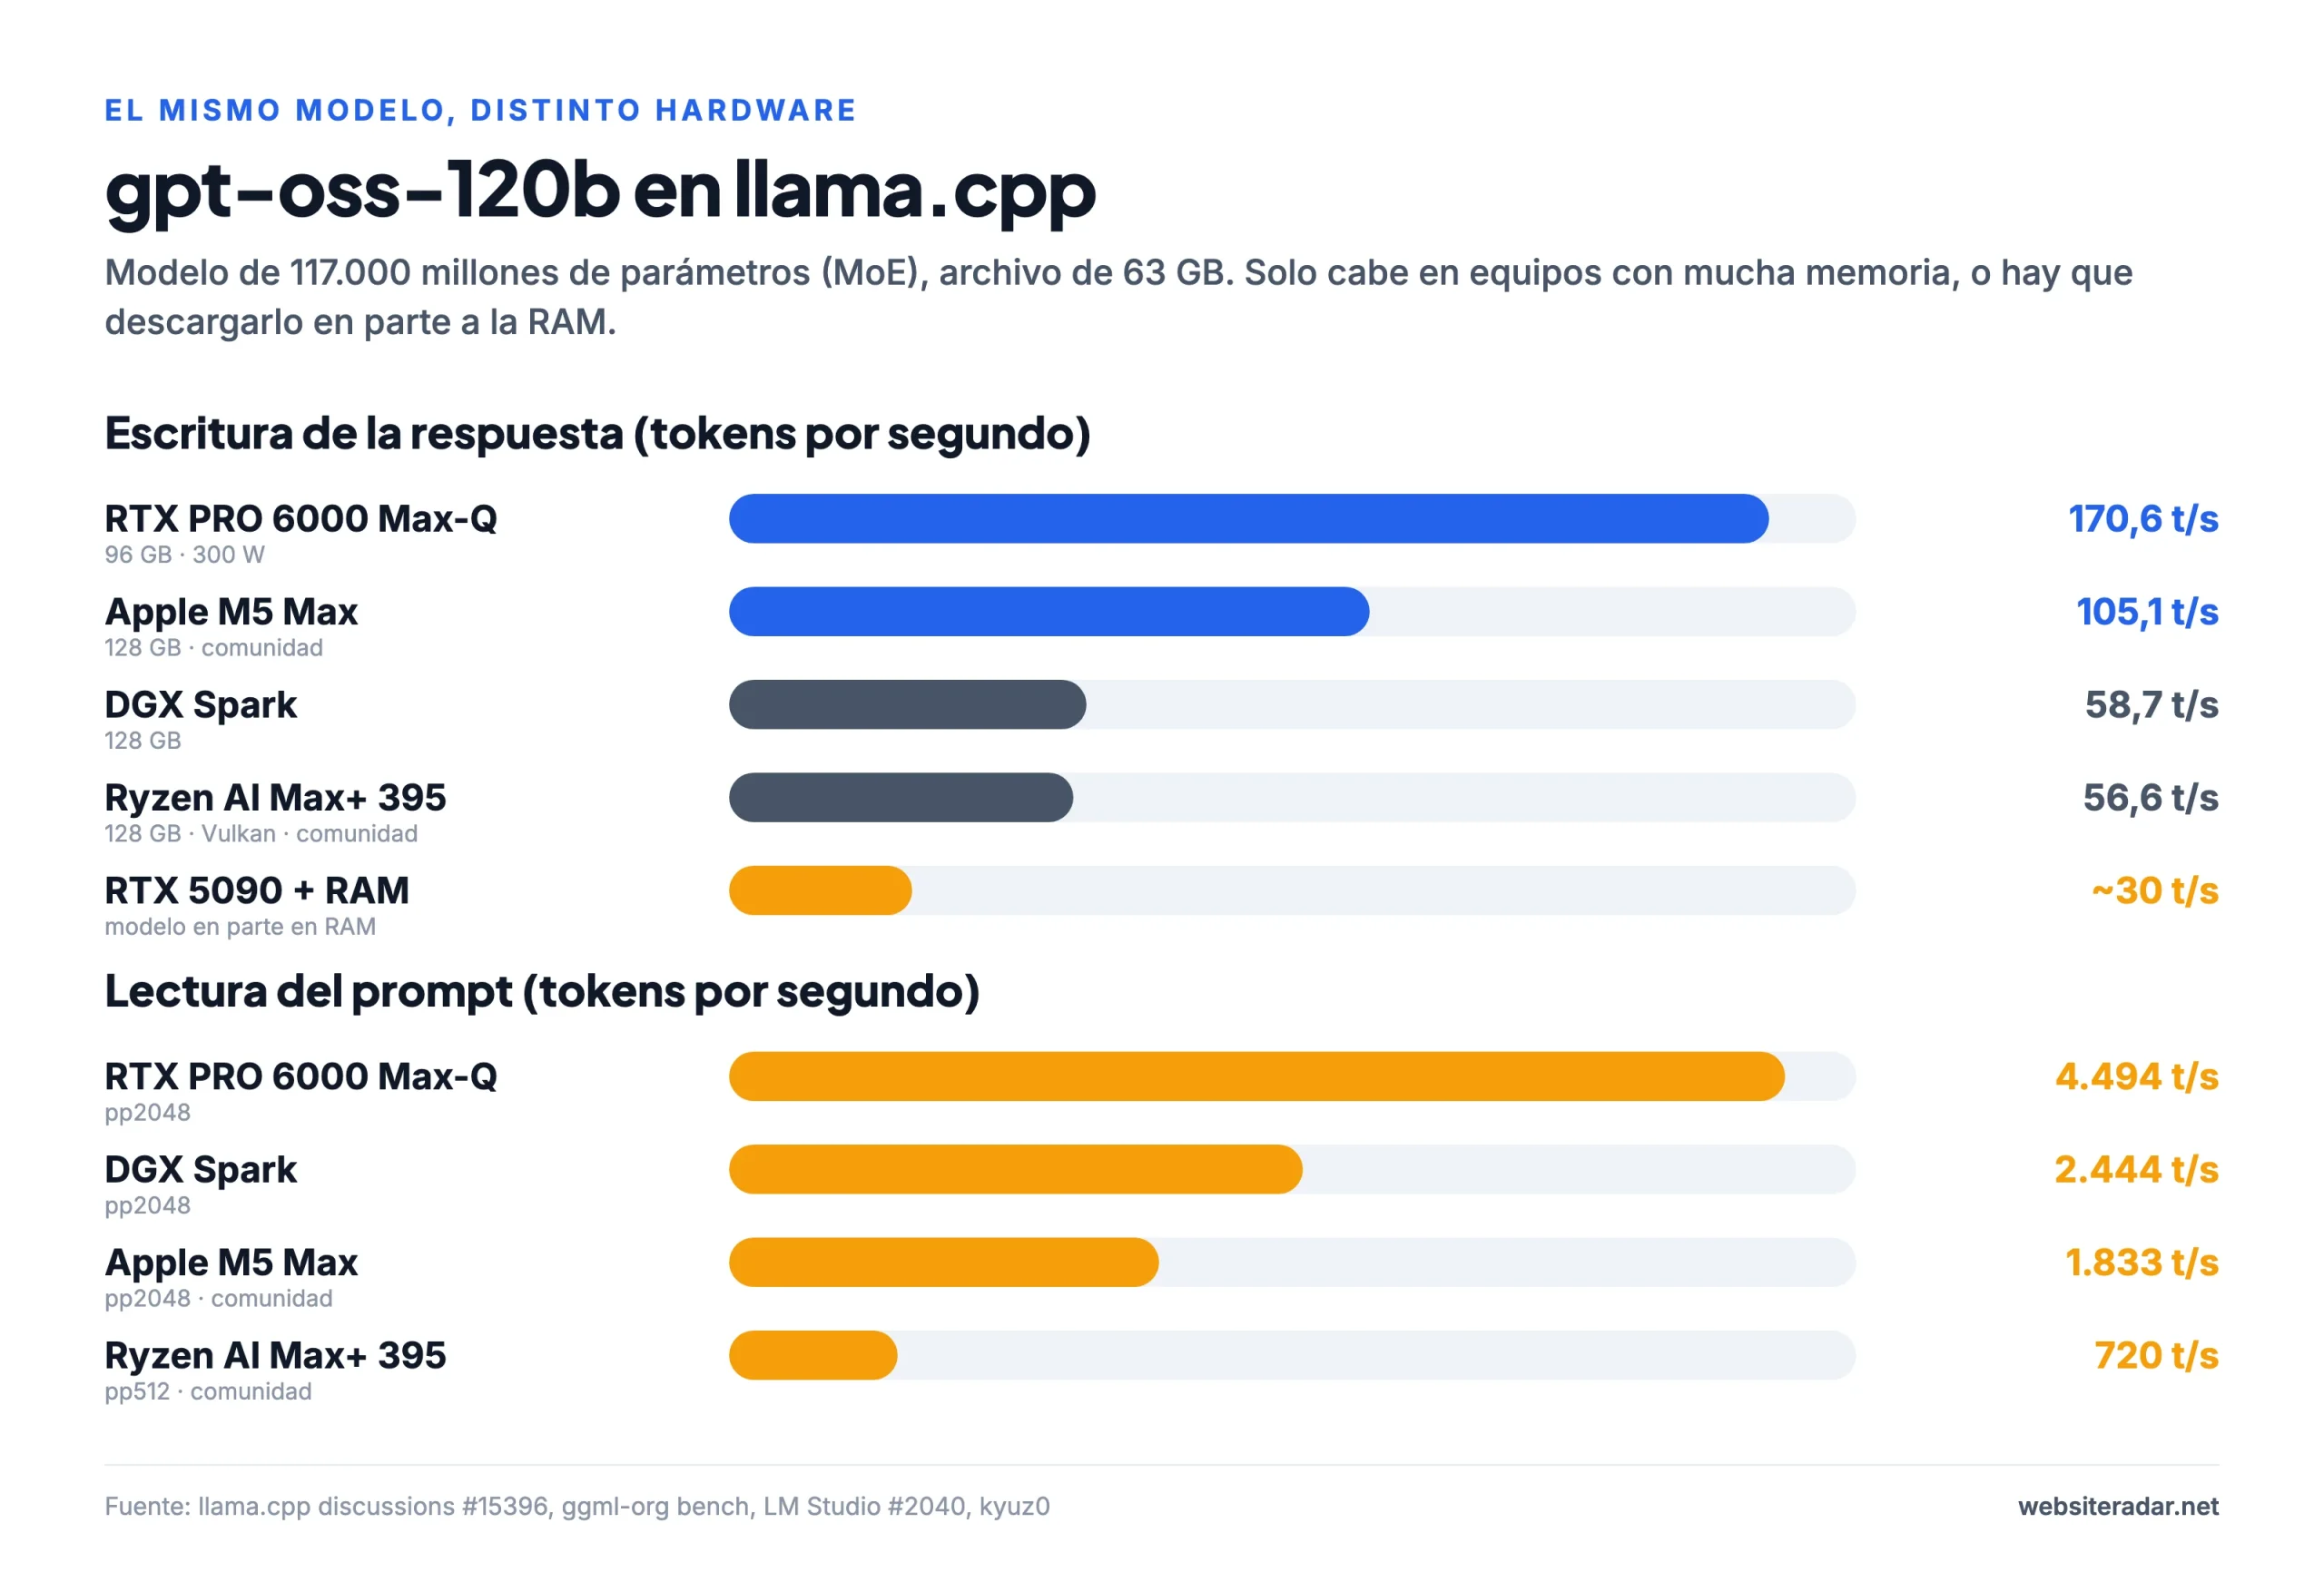
La comparación más justa usa el mismo modelo en el mismo programa. Hemos elegido gpt-oss-120b de OpenAI (63 GB) y mediciones de llama.cpp, el programa más extendido para ejecutar modelos en local.
Todos los dispositivos, frente a frente
| Dispositivo | Memoria para IA | Ancho de banda | gpt-oss-120b, escritura |
|---|---|---|---|
| Mac Studio M5 Max | ~96 GB de 128 GB | 614 GB/s | 105 t/s¹ |
| NVIDIA DGX Spark | 128 GB | 273 GB/s | 58,7 t/s |
| Portátiles RTX Spark | hasta 96 GB de 128 GB | hasta 300 GB/s | – |
| Ryzen AI Max+ 395 | 96 GB (Windows) / ~124 GB (Linux) | 256 GB/s | 56,6 t/s |
| Mac Studio M5 Ultra | ~192 GB de 256 GB | 1.228 GB/s | – |
| Mac mini M5 Pro | ~48 GB de 64 GB | 307 GB/s | no cabe |
| Mac mini M6 | ~24 GB de 32 GB | 170 GB/s | no cabe |
| MacBook Pro M5 Max | ~96 GB de 128 GB | 614 GB/s | 105 t/s¹ |
| RTX 5090 | 32 GB | 1.792 GB/s | ~30 t/s² |
| RTX 5060 Ti 16 GB | 16 GB | 448 GB/s | no cabe |
| RTX 5070 Ti / 5080 | 16 GB | 896 / 960 GB/s | no cabe |
| RTX PRO 6000 Max-Q | 96 GB | 1.792 GB/s | 170,6 t/s |
| GB10 de ASUS, MSI, Lenovo… | 128 GB | 273 GB/s | ~ igual que Spark |
| Radeon AI PRO R9700 | 32 GB | ~640 GB/s | no cabe |
| Portátiles Copilot+ | ~8 GB de 16 GB | ~135 GB/s | no cabe |
¹ Medición de la comunidad en un MacBook Pro M5 Max con 128 GB, llama.cpp. ² Parte del modelo descargada en la RAM del sistema.
1. Mac Studio M5 Max: la escritura más rápida por tu dinero
El Mac Studio con chip M5 Max es hoy la opción más sensata para quien quiere el chat o el agente local más rápido posible y no necesita CUDA. Con 614 GB/s de ancho de banda de memoria, la versión de 128 GB ejecuta gpt-oss-120b a más de 100 tokens por segundo, casi el doble de rápido que un DGX Spark. Los nuevos aceleradores neuronales de cada núcleo de la GPU también han acelerado la lectura del prompt, pero solo con software actualizado (consulta la configuración de software).
- Memoria: 36, 48, 64 o 128 GB · ancho de banda 460 GB/s (36 GB) / 614 GB/s
- Consumo: 7 W en reposo, 200 W como máximo
- Puertos: 4× Thunderbolt 5, 10GbE
- Ojo: la versión de 36 GB tiene una GPU más modesta de 32 núcleos y deja solo unos 27 GB para el modelo. A partir de 48 GB tienes el chip completo.
- Precio oficial en EE. UU.: desde 2.499 $ (configuración básica, agosto de 2026)
Ideal para: chat y agentes con modelos MoE, un servidor de IA doméstico silencioso, gente que además edita vídeo. No es para: quien necesite CUDA, vLLM o entrenar modelos.
2. NVIDIA DGX Spark: una estación para desarrolladores, no una máquina de chat
El chip GB10 con 128 GB de memoria compartida y todo el ecosistema de software de NVIDIA (CUDA, vLLM, TensorRT-LLM) en una caja de 15 × 15 cm. Lee los prompts más rápido que cualquier otra máquina pequeña (2.444 tokens por segundo con gpt-oss-120b), pero con 273 GB/s de ancho de banda escribe más despacio que un Mac: 58,7 tokens por segundo, y solo 4,4 con el denso Llama 70B. Consume 60–90 W mientras ejecuta un modelo, y se pueden conectar dos unidades con un cable QSFP para modelos de hasta unos 400.000 millones de parámetros.
- Memoria: 128 GB LPDDR5x · ancho de banda 273 GB/s
- GPU: Blackwell, 6.144 núcleos CUDA · rendimiento en IA 1 PFLOP FP4 (con dispersión; en la práctica, más o menos la mitad)
- Sistema operativo: DGX OS (Ubuntu sobre Arm)
- Precio oficial en EE. UU.: 3.999 $ en el lanzamiento (octubre de 2025), 4.699 $ desde febrero de 2026; ServeTheHome informó en octubre de 2026 de un salto a un nivel de «en torno a 6.950 $»
Ideal para: desarrollo con CUDA, agentes de programación con contextos grandes, ajuste fino (fine-tuning) de hasta 70B. No es para: chat rápido con modelos densos de 70B, Windows y juegos, principiantes.
3. Portátiles NVIDIA RTX Spark: 128 GB en la mochila
El chip N1X es un GB10 adaptado a portátiles con Windows, con una memoria más rápida (hasta 300 GB/s) y un margen de consumo de 45–80 W. En la prueba de The Register, un portátil movió Qwen3.6 35B-A3B a 67,6 tokens por segundo, más rápido que el DGX Spark de sobremesa. La pega es Windows: la GPU solo recibe una parte fija de la memoria, como máximo 16 GB de 32 GB, 48 GB de 64 GB y 96 GB de 128 GB.
- Memoria: 32, 64 o 128 GB · ancho de banda hasta 300 GB/s
- GPU: Blackwell, 6.144 núcleos (en rendimiento, más o menos una RTX 5070 para portátiles)
- Sistema operativo: Windows 11 on Arm, CUDA desde la versión 13.4
- Ojo: las primeras unidades (Surface, HP) se colgaron en los análisis tras horas a plena carga; Linux no tiene soporte oficial
- Precio en EE. UU.: desde 2.599 $ (Surface Laptop Ultra con 24 GB) hasta 5.899,99 $ (Surface con 128 GB), octubre de 2026
Ideal para: modelos grandes en un portátil con Windows, agentes de programación, trabajo creativo. No es para: la versión de 32 GB, entrenamientos largos, software que solo existe para x86.
4. Ryzen AI Max+ 395: los 128 GB más baratos
Los mini PC con este Ryzen de 16 núcleos y gráficos Radeon 8060S comparten 128 GB de memoria. La velocidad de escritura es comparable a la del DGX Spark (gpt-oss-120b a 56,6 tokens por segundo) por aproximadamente la mitad de precio, y funcionan con Windows y Linux, e incluso con juegos. El punto débil es la lectura del prompt: es entre dos y tres veces más lenta que en el Spark y cae con contextos largos, hasta 146 tokens por segundo con el controlador Vulkan y 371 con ROCm.
- Memoria: 128 GB LPDDR5x · ancho de banda 256 GB/s (~215 medidos)
- Para la GPU: 96 GB en Windows, ~124 GB en Linux
- Software: Vulkan o ROCm (gfx1151 tiene soporte oficial desde 2026)
- HP Z2 Mini G1a: cuesta más, pero es una estación de trabajo certificada con memoria ECC y tres años de garantía
- Ejemplo de precio en EE. UU.: el Framework Desktop con 128 GB salió a 1.999 $ y cuesta 2.459 $ tras la subida del precio de la memoria en 2026
Ideal para: la máxima memoria por el dinero, modelos MoE grandes, chat y resúmenes. No es para: agentes con contextos enormes, CUDA, ni la tableta ROG Flow Z13 con 32–64 GB para modelos grandes.
5. Mac Studio M5 Ultra: el rey de la memoria
Hasta 512 GB de memoria y 1,2 TB/s de ancho de banda. En el análisis de MacStories, el M5 Ultra leyó los prompts cuatro veces más rápido que el anterior M3 Ultra y escribió un 50% más deprisa. La versión de 256 GB llega a alojar incluso Qwen3 235B. Se pueden conectar varias unidades mediante Thunderbolt 5 y RDMA: según Apple, cuatro M5 Ultra ejecutan un modelo de 816.000 millones de parámetros a 36,7 tokens por segundo.
- Memoria: 96, 256 o 512 GB (la de 512 GB llega a finales de octubre) · ancho de banda 1.228 GB/s
- Consumo: 9 W en reposo, unos 300 W ejecutando un modelo
- Puertos: 6× Thunderbolt 5
- Ojo: la memoria no se puede ampliar después; en septiembre, la espera llegaba a 18 semanas
- Precio oficial en EE. UU.: desde 5.499 $ (agosto de 2026); pasar de 96 a 256 GB añade 4.000 $
Ideal para: modelos de 100–250B, agentes con contextos largos, equipos pequeños. No es para: modelos de hasta 30B, CUDA, presupuestos ajustados.
6. Mac mini M5 Pro: la puerta de entrada sensata
El Mac más barato capaz de ejecutar modelos realmente útiles. 307 GB/s de ancho de banda, hasta 64 GB de memoria y Thunderbolt 5. Gracias a los aceleradores neuronales, lee los prompts unas tres veces más rápido que el anterior M4 Pro. La versión de 64 GB mueve con holgura modelos de hasta 32.000 millones de parámetros; el denso Llama 70B cabe, pero apenas llega a unos 7 tokens por segundo, y gpt-oss-120b no cabe.
- Memoria: 24, 48 o 64 GB · ancho de banda 307 GB/s
- Consumo: 6 W en reposo, 145 W como máximo · prácticamente silencioso en reposo
- Precio oficial en EE. UU.: desde 1.699 $ (configuración básica, agosto de 2026)
Ideal para: modelos de 20–35B, un servidor de IA doméstico silencioso. No es para: gpt-oss-120b, modelos densos de 70B, la versión de 24 GB.
7. Mac mini M6: barato, pero no con 16 GB
El Mac más barato con aceleradores neuronales. Se queda en un máximo de 32 GB y 170 GB/s; la versión de 16 GB tiene solo 153 GB/s y deja unos 12 GB para el modelo. Frente al anterior Mac mini con M4, lee los prompts 4,5 veces más rápido y escribe un 50% más deprisa prácticamente por el mismo precio, así que no compres el modelo antiguo ni siquiera de oferta.
- Memoria: 16, 24 o 32 GB (máximo) · ancho de banda 153 / 170 GB/s
- Consumo: 4 W en reposo, 70 W como máximo
- Ojo: solo tiene Thunderbolt 4, así que no se pueden conectar varias unidades
- Precio oficial en EE. UU.: desde 899 $ (configuración básica, agosto de 2026)
Ideal para: modelos de 7–14B, gpt-oss-20b, Qwen3 30B-A3B. No es para: la versión de 16 GB, modelos de 70B o más.
8. MacBook Pro M5 Max: IA para llevar
El mismo chip que el Mac Studio y, por tanto, la misma velocidad: el portátil más rápido para modelos locales. Con el mediano Qwen3.6 35B-A3B genera más de 90 tokens por segundo. Eso sí, la versión de 14 pulgadas reduce su rendimiento con carga sostenida (de 96 a 42 W) y la carga está limitada a 97 W. Un Mac Studio con el mismo chip y 128 GB sale bastante más barato.
- Memoria: 36, 48, 64 o 128 GB · ancho de banda 460 / 614 GB/s
- Batería: 72,4 Wh (14″) / 100 Wh (16″)
- Precio oficial en EE. UU.: desde 3.599 $ (14″) y 3.899 $ (16″), marzo de 2026; pasar de 64 a 128 GB añade 1.000 $
Ideal para: quien necesita modelos grandes fuera de casa, idealmente el de 16 pulgadas con 64–128 GB. No es para: la versión de 36 GB, cargas de trabajo 24/7, quien trabaja siempre en un escritorio.
9. RTX 5090: la más rápida, pero solo 32 GB
1.792 GB/s de ancho de banda: gpt-oss-20b escribe a casi 300 tokens por segundo, y la tarjeta lee un prompt largo aproximadamente el doble de rápido que un Mac Studio con M5 Ultra. Sus 32 GB dan cabida a modelos de hasta unos 32.000 millones de parámetros a 4 bits, incluso con un contexto largo; un modelo de 70.000 millones no cabe. Los modelos MoE grandes se pueden descargar en parte a la RAM del sistema: gpt-oss-120b funciona entonces a unos 30 tokens por segundo.
- Memoria: 32 GB GDDR7 · ancho de banda 1.792 GB/s
- Consumo: 575 W, se recomienda una fuente de alimentación de 1.000 W
- Precio oficial en EE. UU.: 1.999 $ en el lanzamiento (enero de 2025); en 2026, los precios reales en tienda son muy superiores por la escasez de memoria
Ideal para: agentes de programación y RAG con modelos de hasta 32B, desarrollo con CUDA, juegos. No es para: modelos de 70B o más, un servidor silencioso y de bajo consumo.
10. RTX 5060 Ti 16 GB: la puerta de entrada sensata más barata
La tarjeta gráfica nueva de 16 GB más barata. Mueve gpt-oss-20b a unos 92 tokens por segundo, Qwen3 8B a 69 y Qwen3 14B a 41, más rápido de lo que eres capaz de leer. Eso sí, su ancho de banda de memoria es la mitad que el de la RTX 5070 Ti, así que escribe más o menos a la mitad de ritmo, y los modelos de unos 30.000 millones de parámetros no caben en 16 GB.
- Memoria: 16 GB GDDR7 · ancho de banda 448 GB/s
- Consumo: 180 W, basta con una fuente de alimentación de 600 W
- Precio oficial en EE. UU.: 429 $ por la versión de 16 GB en el lanzamiento (abril de 2025)
Ideal para: los primeros experimentos serios, modelos de 8–20B, un PC para IA económico. No es para: modelos de 27B o más.
11. RTX 5070 Ti frente a RTX 5080: casi idénticas para IA
Las dos tarjetas tienen 16 GB y casi el mismo ancho de banda (896 frente a 960 GB/s), así que escriben prácticamente a la misma velocidad: 182,4 frente a 184,7 tokens por segundo en la prueba estándar de llama.cpp, y 74 frente a 81 con Qwen3 14B. En ambas caben exactamente los mismos modelos. La 5080 es más rápida sobre todo en juegos, y su precio de lanzamiento era 250 $ más alto (999 $ frente a 749 $).
Nuestro consejo: para IA, hazte con la RTX 5070 Ti e invierte lo que ahorras en un SSD más grande o en más RAM. Compra la RTX 5080 solo si vas a usarla sobre todo para jugar.
12. RTX PRO 6000: 96 GB en una sola tarjeta
La única tarjeta en la que caben enteros Llama 3.3 70B (32 tokens por segundo), gpt-oss-120b (170,6 tokens por segundo en la versión Max-Q) y Qwen3.5 122B (unos 98 tokens por segundo). Gracias a CUDA y vLLM puede atender a varios usuarios a la vez. Se vende como tarjeta suelta o dentro de una estación de trabajo ya montada.
- Memoria: 96 GB GDDR7 con ECC · ancho de banda 1.792 GB/s
- Consumo: 300 W (Max-Q); la versión completa de 600 W escribe aproximadamente un 13% más rápido
- Precio oficial en EE. UU.: 8.565 $ en el lanzamiento; NVIDIA lo subió después a 13.250 $
Ideal para: empresas y equipos que quieren ejecutar modelos grandes en sus propias instalaciones o entrenarlos. No es para: particulares y aficionados.
13. DGX Spark de ASUS, MSI, Lenovo, Dell y Gigabyte: cuál elegir
Otros cinco fabricantes venden el mismo chip GB10 que el DGX Spark. El rendimiento en IA varía apenas unos pocos puntos porcentuales; las diferencias están en el almacenamiento, la fuente de alimentación, la refrigeración y el soporte, y también en el precio.
| Modelo | Almacenamiento | Fuente | Lo que destaca |
|---|---|---|---|
| NVIDIA / PNY DGX Spark | 4 TB, autocifrado | 240 W | el original |
| GIGABYTE AI TOP ATOM | 4 TB PCIe 5.0 | 240 W | el SSD más rápido |
| ASUS Ascent GX10 | 1 TB PCIe 4.0 / 4 TB PCIe 5.0 | 240 W | botón de encendido frontal |
| Lenovo ThinkStation PGX | 1 / 2 / 4 TB, autocifrado | 240 W | un año de asistencia in situ |
| Dell Pro Max with GB10 | PCIe 4.0 (el de 2 TB es QLC) | 280 W | fuente más potente, SSD más caliente |
| MSI EdgeXpert | 4 TB | – | nuevo, aún sin pruebas independientes |
Nuestro consejo: el mejor equipamiento por un precio razonable lo ofrece el Gigabyte AI TOP ATOM con 4 TB de almacenamiento rápido; el punto de partida probado más barato es el ASUS Ascent GX10 con 1 TB, que salió en EE. UU. por unos 3.000 $. Si piensas conectar dos unidades, necesitarás un cable QSFP. Novedad desde el 23 de octubre de 2026: una versión del GB10 con 64 GB que solo venden las marcas asociadas, desde 4.999 $.
14. Radeon AI PRO R9700: 32 GB por una fracción de lo que cuesta una RTX 5090
La tarjeta nueva con 32 GB más barata. En la misma prueba con Vulkan escribe aproximadamente un 40% más despacio que la RTX 5090, pero admite los mismos modelos: en torno a 30.000 millones de parámetros, incluso con un contexto más largo. gpt-oss-20b y Qwen3 30B-A3B funcionan en ella a más de 150 tokens por segundo. Cuidado con el marketing: lo de «hasta cinco veces más rápida que la RTX 5080» solo se cumple con un modelo que no cabe en 16 GB.
- Memoria: 32 GB GDDR6 · ancho de banda ~640 GB/s · consumo 300 W
- Software: Vulkan (normalmente escribe más rápido) o ROCm (lee el prompt más rápido); sin CUDA
- Precio oficial en EE. UU.: 1.299 $ (octubre de 2025)
Ideal para: modelos de 27–32B con contextos largos, varias tarjetas en un mismo PC. No es para: herramientas que solo funcionan con CUDA, quien busque la máxima velocidad.
15. «PC con IA» y portátiles Copilot+: un mito
Copilot+ es la certificación de Microsoft para funciones de Windows: efectos de cámara, subtítulos en directo, Recall o el pequeño modelo integrado Phi Silica. No dice nada sobre la capacidad de ejecutar modelos de lenguaje grandes. Ni Ollama ni LM Studio usan la unidad de procesamiento neuronal (NPU), y llama.cpp solo de forma experimental; la NPU solo la aprovechan herramientas de los propios fabricantes, como Microsoft Foundry Local o AMD Lemonade, con modelos concretos.
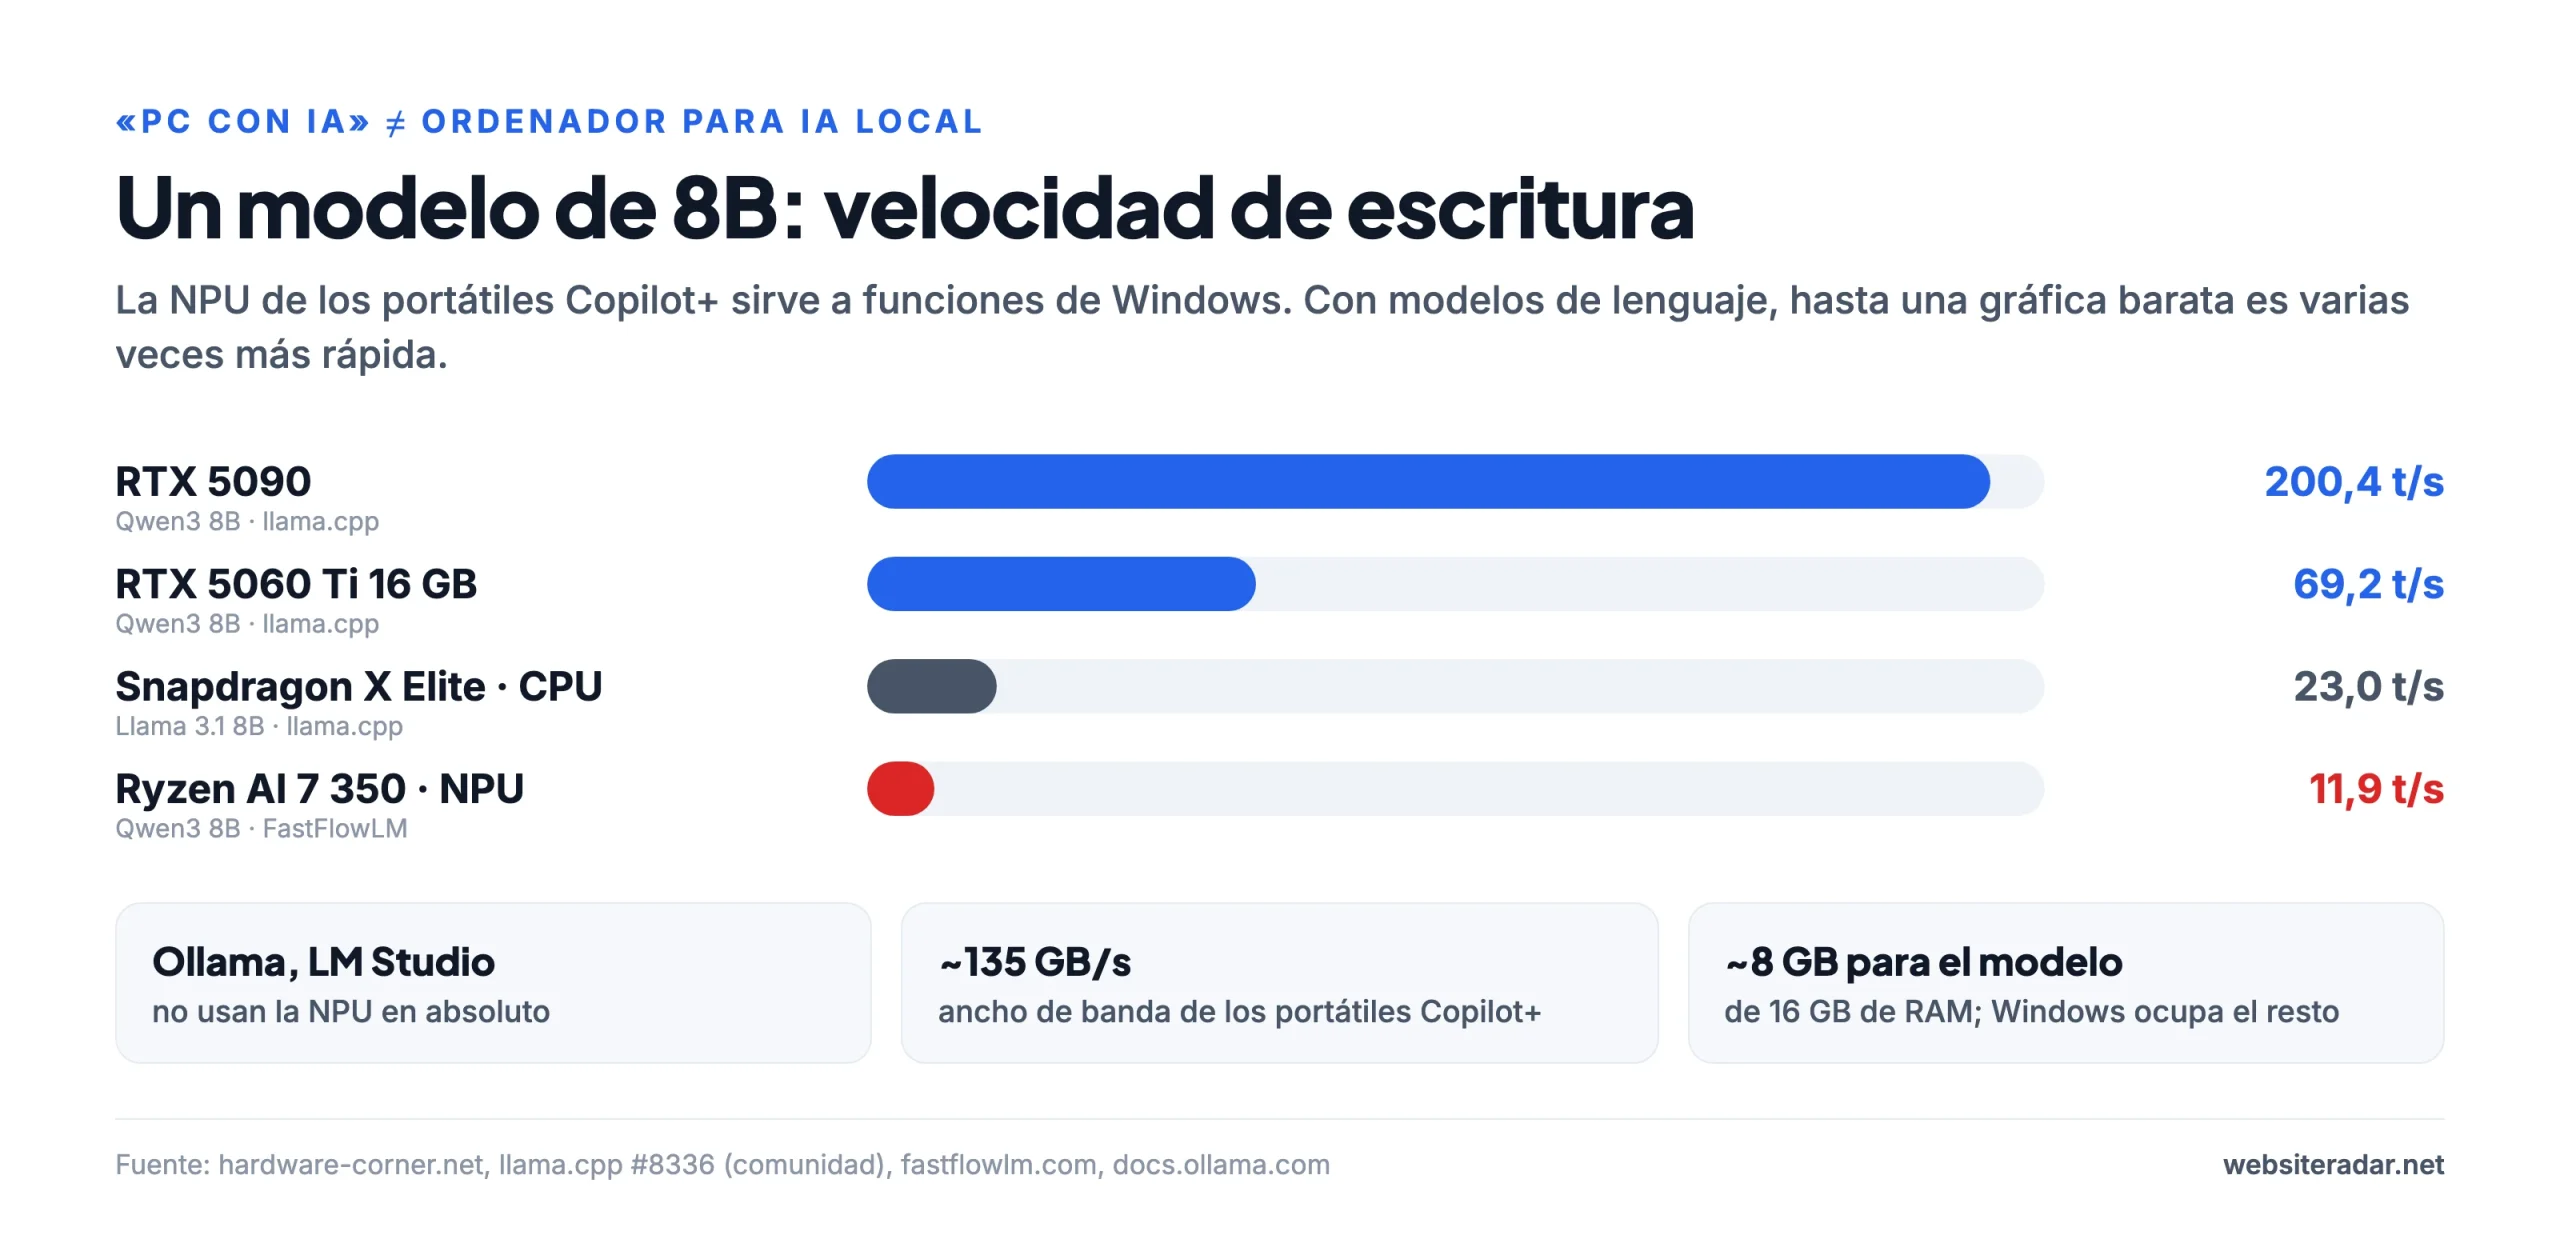
Además, estos portátiles tienen una memoria con unos 135 GB/s de ancho de banda y 16 GB de RAM, lo que deja unos 8 GB para el modelo. Sirven para modelos de hasta 4.000 millones de parámetros y para las funciones de Windows, no para tener «tu propio ChatGPT en casa».
Ideal para: ofimática, autonomía, modelos pequeños de 1–4B. No es para: quien quiera ejecutar modelos de 14B o más.
Consumo y costes de funcionamiento
Si el ordenador va a funcionar como servidor de IA doméstico las 24 horas, el consumo y el ruido también cuentan.
| Dispositivo | En reposo | Con un modelo / máximo | Nota |
|---|---|---|---|
| Mac mini M6 | 4 W | 70 W máx. | prácticamente silencioso |
| Mac mini M5 Pro | 6 W | 145 W máx. | 5 dBA en reposo (Apple) |
| Mac Studio M5 Max | 7 W | 200 W máx. | silencioso |
| Mac Studio M5 Ultra | 9 W | ~300 W con IA | silencioso, según los análisis |
| DGX Spark | 25–45 W | 60–90 W con IA, picos de hasta 200 W | depende de la versión de firmware |
| Mini PC con Ryzen AI Max+ 395 | ~13 W | 120–160 W | el HP Z2 Mini es ruidoso con carga |
| RTX 5090 (solo la tarjeta) | – | hasta 575 W | más el resto del PC |
| RTX 5060 Ti (solo la tarjeta) | – | hasta 180 W |
Las cifras proceden de fabricantes y análisis (ServeTheHome, Tom’s Hardware, Notebookcheck) y no se midieron con el mismo método: tómalas como orientación.
Software: con qué ejecutar el modelo
- Ollama: la forma más sencilla de empezar en cualquier plataforma; descargas un modelo con un solo comando. En el Mac, desde la versión 0.19 (todavía en preview y para modelos concretos) usa MLX y los aceleradores neuronales del M5.
- LM Studio: una aplicación clara con interfaz gráfica. Consejo para Mac con M5: con modelos GGUF todavía no usa los aceleradores neuronales y lee los prompts a la mitad de velocidad, más o menos; usa mejor modelos en formato MLX.
- llama.cpp: la base de la mayoría de las demás herramientas, con más opciones de ajuste que ninguna y el soporte más rápido para hardware nuevo. En Ryzen AI Max, prueba los dos backends: Vulkan suele escribir más rápido y ROCm lee antes los prompts largos.
- MLX: la biblioteca de Apple, con el mejor rendimiento en Mac, incluida la conexión de varios Mac mediante Thunderbolt 5.
- vLLM, SGLang, TensorRT-LLM: herramientas de servidor para NVIDIA, para cuando un mismo modelo atiende a varios usuarios a la vez.
Los errores de compra más habituales
- Un Mac de 36 GB «para IA». Tiene un chip más modesto y deja solo unos 27 GB para el modelo.
- Un portátil RTX Spark con 32 GB. Windows le da a la GPU 16 GB como máximo.
- Un Mac mini M6 con 16 GB. Memoria más lenta y solo unos 12 GB para el modelo.
- Un portátil Copilot+ para IA local. Las herramientas habituales no usan la NPU.
- Una RTX 5080 en lugar de una 5070 Ti solo para IA. Los mismos 16 GB y casi la misma velocidad.
- Ignorar el ancho de banda de memoria. Una memoria grande pero lenta implica una escritura lenta con modelos densos.
- Quedarse corto de memoria. En los Mac, en Ryzen AI Max y en RTX Spark la memoria va soldada y no se puede ampliar después.
Preguntas frecuentes
¿Bastan 16 GB para IA local? Para modelos de hasta 14.000–20.000 millones de parámetros, sí: por ejemplo, gpt-oss-20b o Qwen3 14B. Los modelos de unos 30.000 millones necesitan 24–32 GB, y los de 70.000 millones, al menos 48 GB.
¿Mac o NVIDIA? Un Mac escribe más rápido y te da más memoria por el dinero; NVIDIA lee los prompts más rápido y tiene CUDA. Para chat y agentes con modelos MoE gana el Mac; para desarrollo, entrenamiento y dar servicio a varios usuarios, gana NVIDIA.
¿Qué significa «MoE»? Mixture of experts (mezcla de expertos): el modelo tiene muchos parámetros, pero solo usa una pequeña parte de ellos para cada palabra. Necesita mucha memoria, pero escribe a la velocidad de un modelo más pequeño.
¿A qué velocidad tiene que escribir un modelo? Unos 15 tokens por segundo equivalen a la velocidad de lectura. Para un chat fluido resultan cómodos 30 o más; para agentes de programación que generan mucho texto, mejor 50 o más.
¿Sale la IA local más barata que una suscripción? Por lo general, no: los modelos comparables a los mejores servicios en la nube necesitan máquinas que cuestan muchos miles de dólares. Las razones principales son la privacidad, el control sobre tus datos y la independencia.
¿Puedo conectar varios ordenadores? Sí. Dos DGX Spark se conectan con un cable QSFP, y los Mac con Thunderbolt 5 mediante RDMA (con MLX o exo). El Mac mini M6 no puede hacerlo porque solo tiene Thunderbolt 4.
Cómo hemos comparado y fuentes
No hemos probado los dispositivos nosotros mismos. Las cifras proceden de fuentes verificadas y siempre las citamos en los gráficos. Comparamos la velocidad en un único programa (llama.cpp), porque otro programa u otra cuantización pueden desplazar fácilmente los resultados entre un 20 y un 50%. Las mediciones de la comunidad (GitHub, foros) están señaladas. Los precios son precios oficiales en EE. UU. tomados de anuncios de los fabricantes y de análisis, con su fecha.
- Modelo que se desborda a la RAM, RTX 5060 Ti: inventivehq.com/blog/vram-offload-cliff-gpu-layers-benchmark
- Benchmark de DGX Spark: github.com/ggml-org/llama.cpp/blob/master/benches/dgx-spark/dgx-spark.md
- Guía de gpt-oss y mediciones en GPU: github.com/ggml-org/llama.cpp/discussions/15396
- M5 Max y LM Studio: github.com/lmstudio-ai/lmstudio-bug-tracker/issues/2040
- Ryzen AI Max (Strix Halo): strix-halo-toolboxes.com, llm-tracker.info/_TOORG/Strix-Halo
- Apple: apple.com/mac-studio/specs, apple.com/mac-mini/specs, machinelearning.apple.com/research/mlx-distributed-inference
- M5 Ultra: macstories.net/stories/m5-ultra-mac-studio-review-the-dream-mac-for-local-ai-agents
- RTX Spark: theregister.com (16 de octubre de 2026), servethehome.com, storagereview.com
- Tarjetas gráficas GeForce: nvidia.com/en-us/geforce/graphics-cards/compare, hardware-corner.net/gpu-llm-benchmarks
- Clasificaciones de llama.cpp: github.com/ggml-org/llama.cpp/discussions/15013 y /10879
- PC Copilot+: microsoft.com/windows/windows-11-specifications, docs.ollama.com/gpu, fastflowlm.com
- Tamaños de los modelos: huggingface.co (repositorios de ggml-org, unsloth y bartowski)
- Precios: Apple Newsroom, NVIDIA Newsroom y foros para desarrolladores, servethehome.com, storagereview.com, notebookcheck.net, tomshardware.com