Nasza strona internetowa zawiera linki do stron partnerskich. Jeśli klikniesz z naszej strony na stronę partnera i tam dokonasz zakupu jego usług, otrzymamy prowizję za pośrednictwo (Dowiedz się więcej). Ta forma współpracy nie wpływa na obiektywność naszych recenzji. Przy każdym zakupie za pomocą kliknięcia z naszej strony internetowej wspierasz naszą redakcję, abyśmy mogli tworzyć wysokiej jakości przydatne treści również w przyszłości. Dziękujemy.

Komputer do lokalnej AI w 2026 roku: jak wybrać sprzęt do uruchamiania LLM w domu
Spis treści
Chcesz uruchamiać modele językowe na własnym komputerze – bez abonamentu, bez wysyłania danych poza biurko i bez połączenia z internetem? W takim razie procesor i naklejka z liczbą „TOPS” na pudełku znaczą dużo mniej niż dwie inne rzeczy: ile pamięci może wykorzystać model i jak szybko komputer potrafi tę pamięć odczytywać. W tym poradniku wyjaśniamy, jak lokalna AI naprawdę działa na komputerze, ile pamięci potrzebują popularne modele i jak obecny sprzęt radzi sobie w praktyce – od karty graficznej, którą dołożysz do swojego obecnego PC, po stację roboczą dla całego zespołu. Przy każdym urządzeniu znajdziesz zweryfikowane liczby, źródła i jasny werdykt, dla kogo się nadaje; niektóre sekcje mają też krótkie wideo.
Najważniejsze w 30 sekund
- Pamięć decyduje o wszystkim. Cały model musi zmieścić się w szybkiej pamięci, do której ma dostęp GPU. Przy 4 bitach licz z grubsza 0,6 GB na miliard parametrów.
- Przepustowość pamięci decyduje o tym, jak szybko model pisze, a moc obliczeniowa – jak szybko czyta długi prompt. Dlatego Mac pisze szybciej niż DGX Spark, za to Spark szybciej czyta długie dokumenty.
- Najlepsza opłacalność w tej chwili: Mac Studio M5 Max ze 128 GB (szybkie odpowiedzi), Ryzen AI Max+ 395 ze 128 GB (najtańsza duża pamięć), RTX 5060 Ti 16 GB (najtańszy sensowny punkt wejścia).
- „Komputer AI” z NPU to nie jest komputer do lokalnej AI. Ani Ollama, ani LM Studio nie korzystają z NPU.
Nie testowaliśmy tych urządzeń samodzielnie – liczby pochodzą ze źródeł wymienionych na końcu artykułu, a pomiary społeczności są wyraźnie oznaczone. Ceny to amerykańskie ceny katalogowe z podaną datą; niedobory pamięci w 2026 roku podniosły wiele z nich.
Co kupić: szybkie rekomendacje
Jeśli nie chcesz czytać całego poradnika, oto skrót. Każdą rekomendację szczegółowo omawiamy niżej, niektóre także na wideo.

| Klasa | Wybór | Jakie modele obsłuży |
|---|---|---|
| Podstawa | RTX 5060 Ti 16 GB w obecnym PC | 8–20B (Qwen3 14B, gpt-oss-20b) |
| Na start | Mac mini M6 z 32 GB lub RTX 5070 Ti | szybko do 14B, Qwen3 30B-A3B |
| 64 GB | Mac mini M5 Pro z 64 GB | 20–35B, cichy domowy serwer |
| 128 GB, opłacalnie | Ryzen AI Max+ 395 ze 128 GB | duże modele MoE do 120B |
| 128 GB, najszybciej | Mac Studio M5 Max ze 128 GB | gpt-oss-120b ponad 100 tokenów/s |
| Dla CUDA | DGX Spark lub inny komputer z GB10 | programowanie w CUDA, agenci kodujący |
| Maks. pamięć | Mac Studio M5 Ultra z 256 GB | modele 100–250B w domu |
| Dla zespołu | RTX PRO 6000 | 70–120B dla całego zespołu |
Po co uruchamiać AI lokalnie – i czego się nie spodziewać
Lokalny model działa na twoim własnym komputerze. Dane nie opuszczają biurka, nie płacisz miesięcznego abonamentu ani opłat za tokeny, model działa offline i nikt nie zmieni go ani nie wycofa z dnia na dzień. Dlatego dobrze sprawdza się przy poufnych dokumentach, asystentach programowania pracujących na firmowym kodzie, automatyzacjach wysyłających tysiące zapytań dziennie – albo po prostu do eksperymentowania dla frajdy.
Są dwa haczyki. Po pierwsze, otwarte modele, które mieszczą się na domowym sprzęcie, są bystre, ale nie dorównują najlepszym usługom w chmurze. Po drugie, sprzęt nie jest tani, a w 2026 roku niedobory pamięci podbijają ceny. Główne powody, by postawić na lokalne modele, to prywatność, kontrola i niezależność – nie oszczędność.
Jak model działa na twoim komputerze
Kiedy zadajesz modelowi pytanie, zachodzą dwie fazy, a każdą z nich ogranicza coś innego:
- Czytanie promptu (prefill). Model przetwarza całe wejście naraz – pytanie, wklejony dokument, kod twojego projektu. Ta faza zależy od mocy obliczeniowej GPU i decyduje o tym, jak długo czekasz na pierwsze słowo odpowiedzi. Przy krótkim pytaniu trwa ułamek sekundy, przy dokumencie liczącym dziesiątki tysięcy słów może trwać minuty.
- Pisanie odpowiedzi (decode). Model generuje tekst słowo po słowie (ściśle mówiąc – token po tokenie). Dla każdego tokena musi odczytać z pamięci cały model – a w przypadku modeli typu mixture of experts tylko jego aktywną część. Ta faza zależy od przepustowości pamięci, czyli od tego, ile gigabajtów na sekundę układ potrafi odczytać.
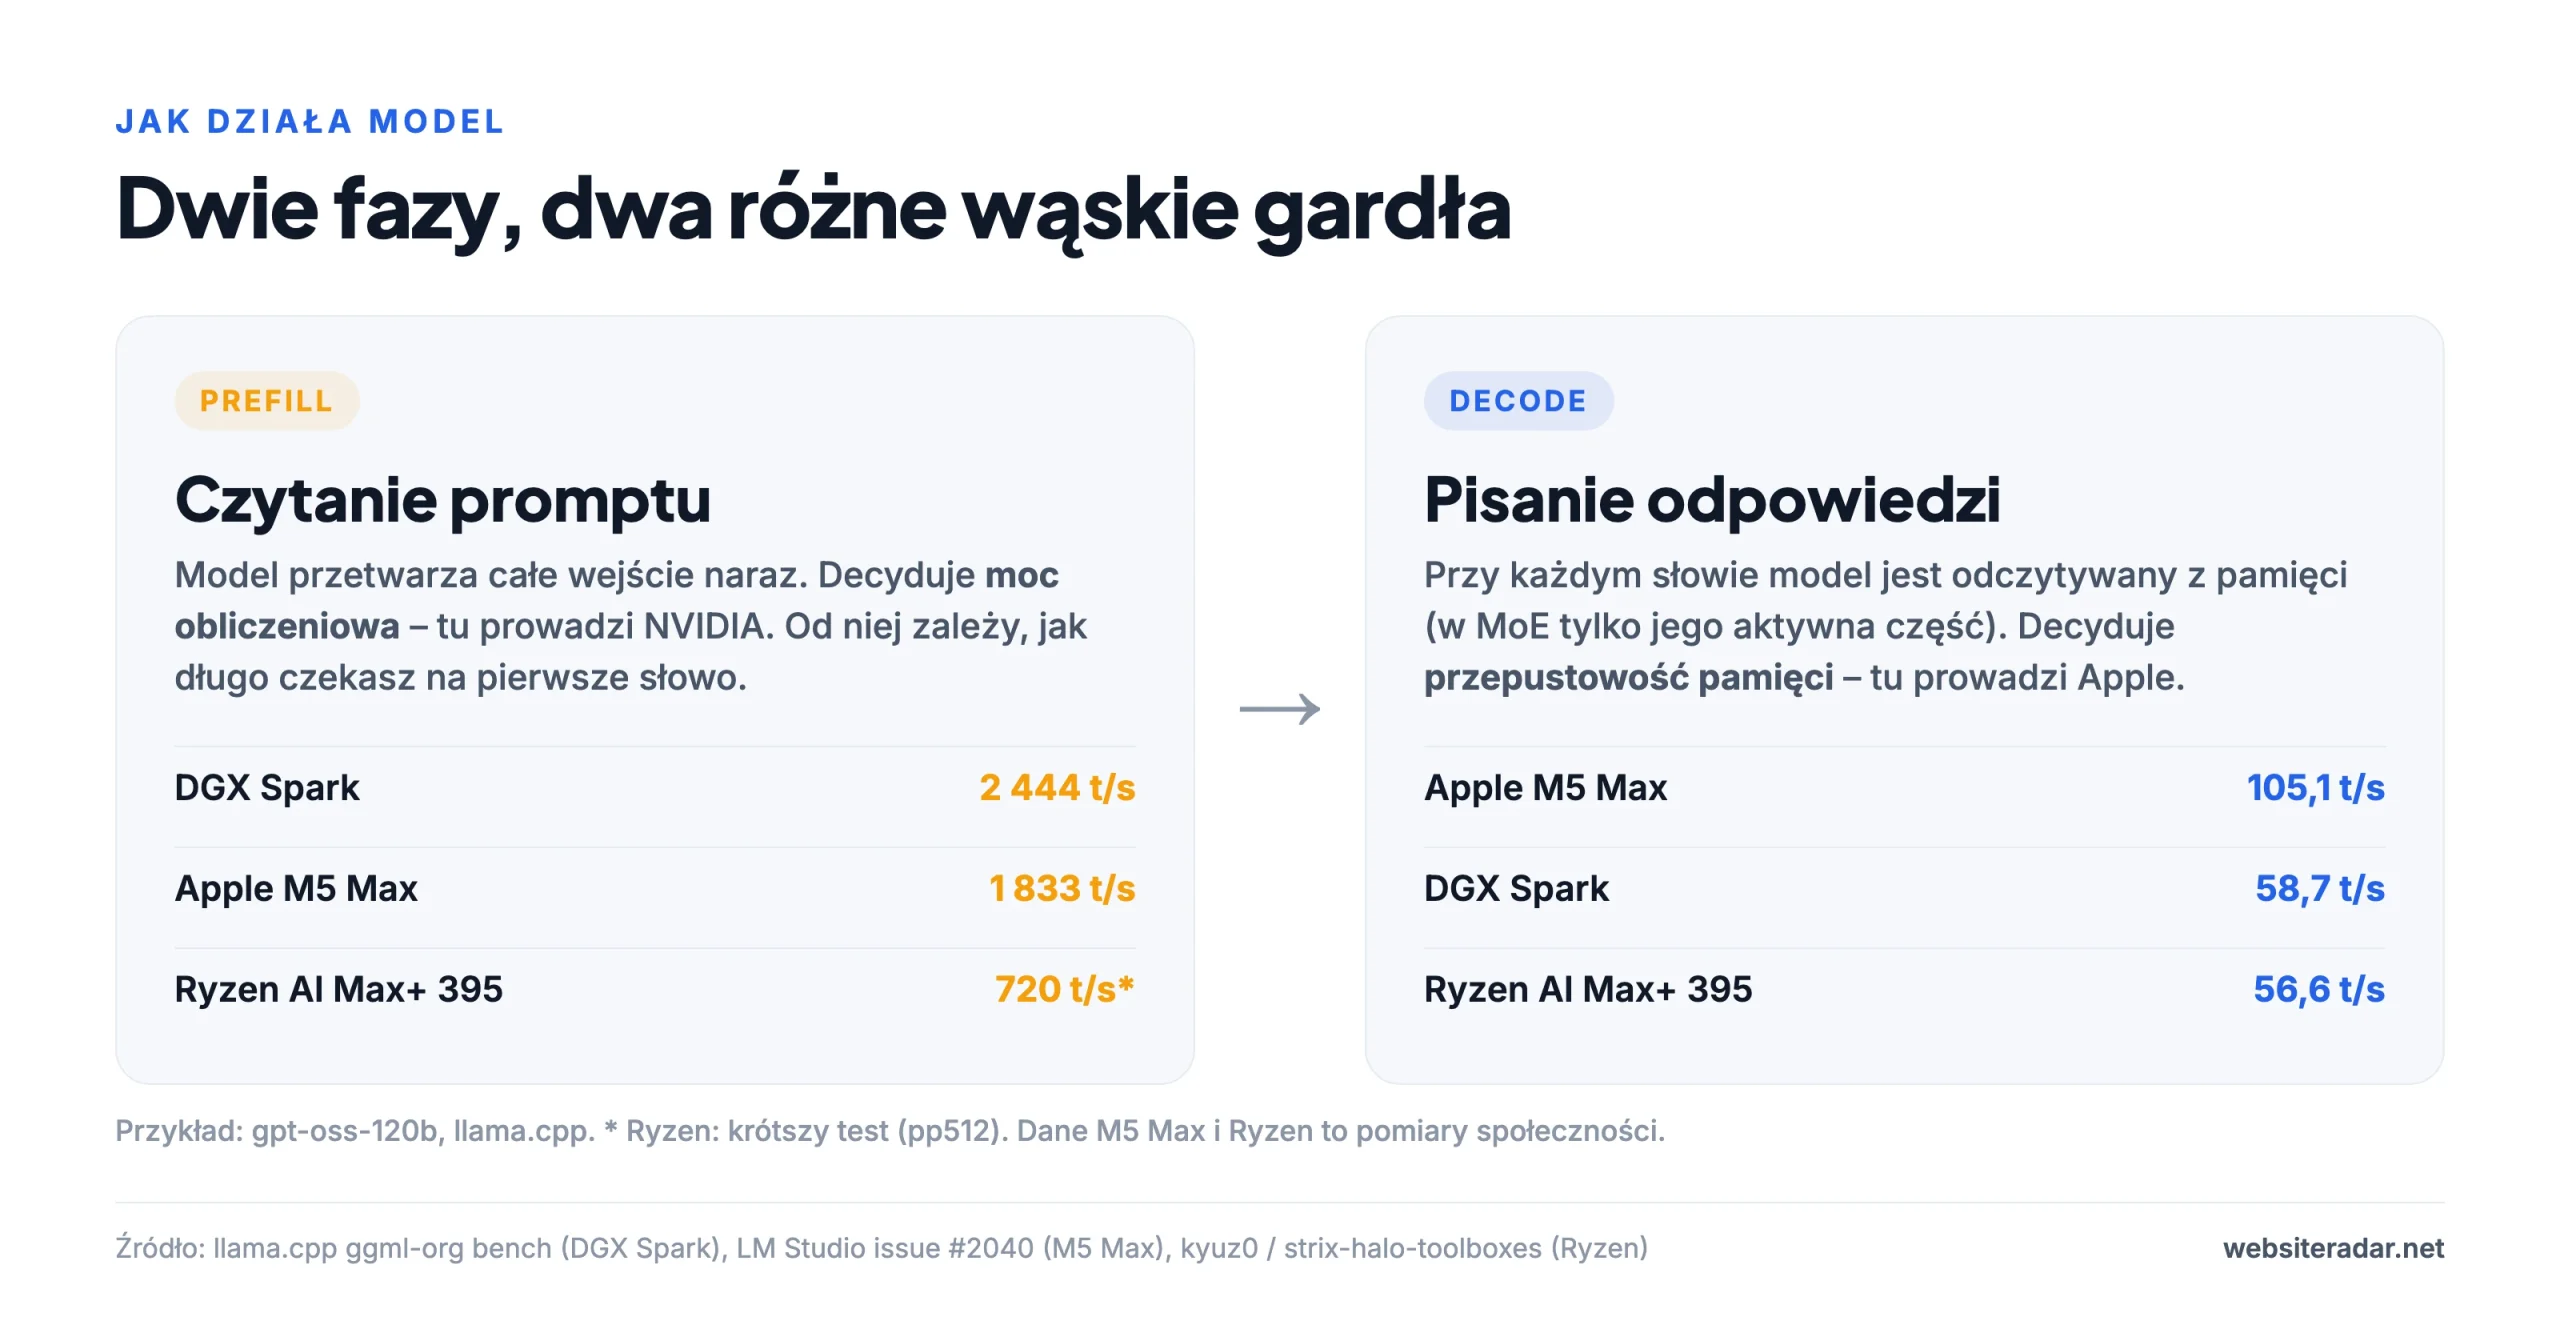
Różnica w praktyce: w czacie odczuwasz przede wszystkim szybkość generowania odpowiedzi (i tu błyszczy Mac). Przy agentach kodujących i pracy z dokumentami, które nieustannie podsyłają modelowi ogromne ilości kontekstu, szybkie czytanie promptu jest równie ważne (i tu prowadzi NVIDIA). Szybkość mierzy się w tokenach na sekundę – jeden token to mniej więcej trzy czwarte słowa. Około 15 tokenów na sekundę odpowiada tempu czytania; powyżej 50 model sprawia wrażenie naprawdę żwawego.
Ile pamięci potrzebujesz
Cały model musi znajdować się w szybkiej pamięci, do której ma dostęp GPU: albo w VRAM karty graficznej, albo we wspólnej (zunifikowanej) pamięci, jaką mają Maki, DGX Spark czy Ryzen AI Max. Jeśli się nie zmieści, część trafia do zwykłej pamięci RAM i szybkość dramatycznie spada. W jednym teście na RTX 5060 Ti przeniesienie poza GPU zaledwie jednej szóstej warstw modelu Qwen 14B obniżyło szybkość generowania z 43 do 12,5 tokena na sekundę; na samym procesorze model osiągnął 2,9.

| Model | Typ | Rozmiar (4 bity) | Gdzie się zmieści |
|---|---|---|---|
| Llama 3.1 8B / Qwen3 8B | gęsty | 4,9–5,0 GB | wszystko z 8 GB |
| Qwen3 14B | gęsty | 9,0 GB | 12–16 GB |
| gpt-oss-20b | MoE | 12,1 GB (MXFP4) | 16 GB |
| Gemma 3 27B | gęsty | 16,6 GB | 24 GB |
| Qwen3 30B-A3B | MoE, 3B aktywnych | 18,6 GB | 24 GB |
| Qwen3 32B | gęsty | 19,8 GB | 24–32 GB |
| Llama 3.3 70B | gęsty | 42,5 GB | 48 GB lub więcej |
| gpt-oss-120b | MoE | 63,4 GB (MXFP4) | 96–128 GB |
| GLM-4.5-Air 106B | MoE | 73,0 GB | 96 GB lub więcej |
| Qwen3.5 122B-A10B | MoE | 76,5 GB | 96–128 GB |
| Qwen3 235B-A22B | MoE | 142,2 GB | 192–256 GB |
| DeepSeek R1 671B | MoE | 404,9 GB | 512 GB |
Kontekst też potrzebuje pamięci
Oprócz samego modelu potrzebujesz pamięci na kontekst (KV cache) – wszystko, co model „pamięta” z rozmowy lub dokumentu. W przypadku Llama 3.3 70B to około 10 GB więcej przy kontekście 32 000 tokenów i około 40 GB przy 128 000 tokenów. Modele gpt-oss są pod tym względem znacznie oszczędniejsze dzięki przesuwanemu oknu (sliding window): gpt-oss-120b potrzebuje maksymalnie około 9 GB nawet przy 128 000 tokenów. Wraz ze wzrostem kontekstu spada też szybkość generowania – gpt-oss-120b na M5 Max pisze około 80 tokenów na sekundę przy krótkim kontekście, ale tylko 14 przy 128 000 tokenów.
Nie cała pamięć trafia do GPU
- macOS domyślnie pozwala GPU korzystać z mniej więcej 75% RAM (Apple nie podaje dokładnej wartości). Mac z 64 GB oferuje więc modelowi około 48 GB, a Mac ze 128 GB – około 96 GB. Limit możesz podnieść poleceniem
sudo sysctl iogpu.wired_limit_mb=…, ale po restarcie wraca on do wartości domyślnej. - Windows na Ryzen AI Max dzieli pamięć w BIOS-ie w stałej proporcji – GPU dostaje maksymalnie 96 GB ze 128 GB. W Linuksie może to być nawet około 124 GB.
- Laptopy NVIDIA RTX Spark w Windows domyślnie dzielą pamięć mniej więcej po połowie, a ręcznie można ustawić maksymalnie 96 GB ze 128 GB. Wersja z 32 GB daje GPU tylko 16 GB.
- DGX Spark w Linuksie przydziela pamięć dynamicznie, więc model może wykorzystać większość ze 128 GB.
Kwantyzacja i MoE w prostych słowach
Kwantyzacja to kompresja modeli: zamiast 16 bitów na parametr używa się 8 lub 4. Przy 4 bitach (oznaczenia Q4, Q4_K_M lub MXFP4) model zajmuje mniej więcej ćwierć pierwotnego rozmiaru, a jakość spada tylko nieznacznie – to rozsądny wybór domyślny do zastosowań domowych. Osiem bitów (Q8) to jakość niemal bezstratna, ale przy dwukrotnie większym rozmiarze.
Mixture of experts (MoE), czyli mieszanina ekspertów, to architektura, w której model ma bardzo dużo parametrów, ale do każdego słowa wykorzystuje tylko ich niewielki wycinek. gpt-oss-120b ma 117 miliardów parametrów, ale w każdym kroku aktywuje tylko około pięciu miliardów; Qwen3 30B-A3B – zaledwie trzy miliardy. Taki model potrzebuje dużo pamięci, ale pisze z prędkością znacznie mniejszego modelu. Dlatego modele MoE idealnie pasują do maszyn z dużą, ale wolniejszą pamięcią współdzieloną, takich jak DGX Spark, Ryzen AI Max czy komputery Mac. Modele gęste (Llama 70B, Qwen3 32B) z kolei przy każdym słowie odczytują cały model i na wolnej pamięci ledwo się wloką.
Przepustowość pamięci: dlaczego Mac pisze szybciej niż Spark
Szybkość generowania można całkiem dobrze oszacować: to przepustowość pamięci podzielona przez ilość danych, które model musi odczytać na każdy token. Gęsty model 70B w 4 bitach (~42 GB) nie może więc na DGX Spark z przepustowością 273 GB/s pisać szybciej niż około 6–7 tokenów na sekundę – a pomiary pokazują około 4,4.

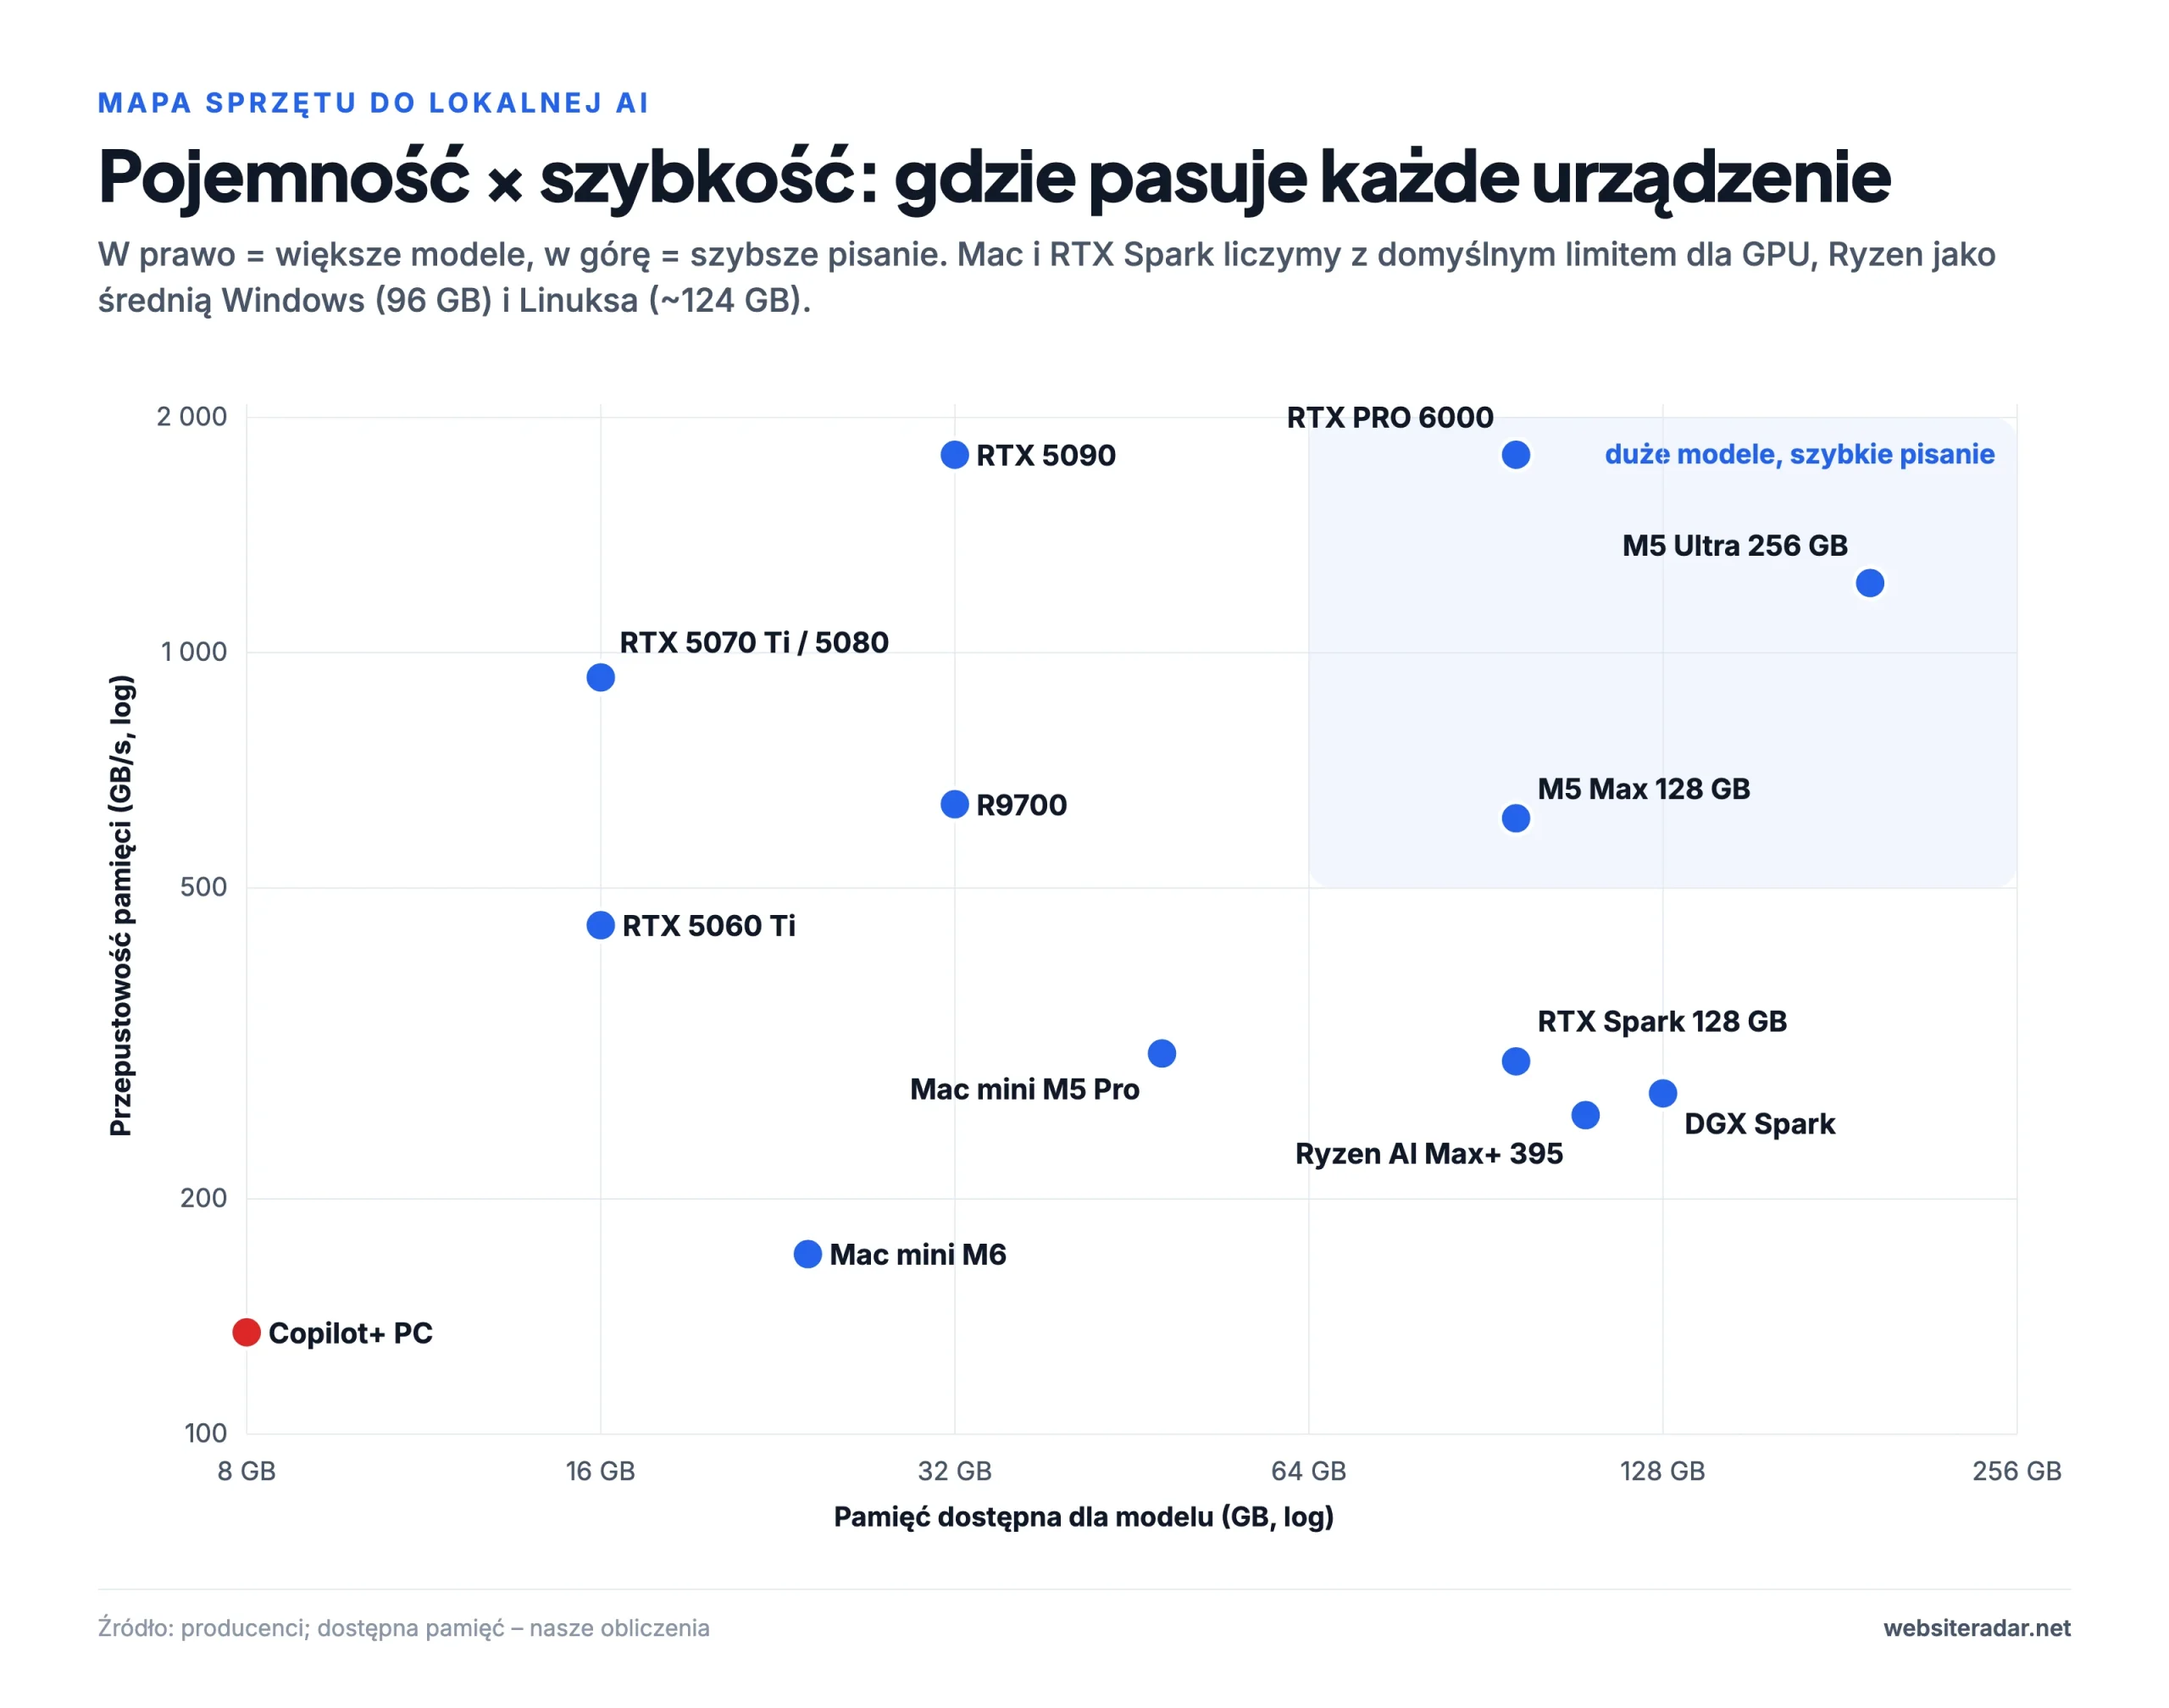
Mapa jasno pokazuje, że idealne urządzenie nie istnieje. Karty graficzne NVIDIA mają najszybszą pamięć, ale o małej pojemności. DGX Spark, Ryzen AI Max i RTX Spark mają mnóstwo pamięci, ale wolniejszej. Mac Studio z M5 Max – a przede wszystkim z M5 Ultra – łączy jedno z drugim, za cenę braku CUDA i wolniejszego niż u NVIDII czytania promptu.
Ten sam model, różny sprzęt
Najuczciwsze porównanie to ten sam model w tym samym programie. Wybraliśmy gpt-oss-120b od OpenAI (63 GB) i pomiary z llama.cpp, najpopularniejszego programu do uruchamiania lokalnych modeli.

Wszystkie urządzenia w porównaniu
| Urządzenie | Pamięć dla AI | Przepustowość | gpt-oss-120b, pisanie |
|---|---|---|---|
| Mac Studio M5 Max | ~96 GB ze 128 GB | 614 GB/s | 105 t/s¹ |
| NVIDIA DGX Spark | 128 GB | 273 GB/s | 58,7 t/s |
| Laptopy RTX Spark | do 96 GB ze 128 GB | do 300 GB/s | – |
| Ryzen AI Max+ 395 | 96 GB (Windows) / ~124 GB (Linux) | 256 GB/s | 56,6 t/s |
| Mac Studio M5 Ultra | ~192 GB z 256 GB | 1228 GB/s | – |
| Mac mini M5 Pro | ~48 GB z 64 GB | 307 GB/s | nie mieści się |
| Mac mini M6 | ~24 GB z 32 GB | 170 GB/s | nie mieści się |
| MacBook Pro M5 Max | ~96 GB ze 128 GB | 614 GB/s | 105 t/s¹ |
| RTX 5090 | 32 GB | 1792 GB/s | ~30 t/s² |
| RTX 5060 Ti 16 GB | 16 GB | 448 GB/s | nie mieści się |
| RTX 5070 Ti / 5080 | 16 GB | 896 / 960 GB/s | nie mieści się |
| RTX PRO 6000 Max-Q | 96 GB | 1792 GB/s | 170,6 t/s |
| GB10 od ASUS-a, MSI, Lenovo… | 128 GB | 273 GB/s | ~ jak Spark |
| Radeon AI PRO R9700 | 32 GB | ~640 GB/s | nie mieści się |
| Laptopy Copilot+ | ~8 GB z 16 GB | ~135 GB/s | nie mieści się |
¹ Pomiar społeczności na MacBooku Pro M5 Max ze 128 GB, llama.cpp. ² Część modelu przeniesiona do systemowej pamięci RAM.
1. Mac Studio M5 Max – najszybsze odpowiedzi w tej cenie
Mac Studio z układem M5 Max to dziś najrozsądniejszy wybór dla każdego, kto chce możliwie najszybszego lokalnego czatu lub agenta i nie potrzebuje CUDA. Dzięki przepustowości pamięci 614 GB/s wersja ze 128 GB uruchamia gpt-oss-120b z prędkością ponad 100 tokenów na sekundę – niemal dwa razy szybciej niż DGX Spark. Nowe akceleratory neuronowe w każdym rdzeniu GPU przyspieszyły też czytanie promptu, ale tylko w aktualnym oprogramowaniu (zobacz konfigurację oprogramowania).
- Pamięć: 36, 48, 64 lub 128 GB · przepustowość 460 GB/s (36 GB) / 614 GB/s
- Pobór mocy: 7 W w spoczynku, maks. 200 W
- Złącza: 4× Thunderbolt 5, 10GbE
- Uwaga: wersja z 36 GB ma słabsze, 32-rdzeniowe GPU i zostawia dla modelu tylko około 27 GB. Od 48 GB w górę dostajesz pełny układ.
- Cena katalogowa w USA: od 2499 USD (konfiguracja podstawowa, sierpień 2026)
Dla kogo: czat i agenci z modelami MoE, cichy domowy serwer AI, osoby, które montują też wideo. Nie dla: tych, którzy potrzebują CUDA, vLLM lub trenowania modeli.
2. NVIDIA DGX Spark – stacja deweloperska, a nie maszynka do czatu
Układ GB10 ze 128 GB pamięci współdzielonej i pełnym zestawem oprogramowania NVIDII (CUDA, vLLM, TensorRT-LLM) w obudowie 15 × 15 cm. Czyta prompty szybciej niż jakikolwiek inny mały komputer – 2444 tokeny na sekundę z gpt-oss-120b – ale przy przepustowości 273 GB/s pisze wolniej niż Mac: 58,7 tokena na sekundę, a z gęstą Llamą 70B tylko 4,4. Podczas pracy modelu pobiera 60–90 W, a dwa egzemplarze można połączyć kablem QSFP, by uruchamiać modele do około 400 miliardów parametrów.
- Pamięć: 128 GB LPDDR5x · przepustowość 273 GB/s
- GPU: Blackwell, 6144 rdzenie CUDA · wydajność AI 1 PFLOP FP4 (ze sparsity; w praktyce mniej więcej połowa)
- System: DGX OS (Ubuntu na Arm)
- Cena katalogowa w USA: 3999 USD na premierę (październik 2025), 4699 USD od lutego 2026; w październiku 2026 ServeTheHome poinformował o przejściu do progu „w okolicach 6950 USD”
Dla kogo: programowanie w CUDA, agenci kodujący z dużym kontekstem, fine-tuning modeli do 70B. Nie dla: szybkiego czatu z gęstymi modelami 70B, Windows i gier, początkujących.
3. Laptopy NVIDIA RTX Spark – 128 GB w plecaku
Układ N1X to GB10 przystosowany do laptopów z Windows, z szybszą pamięcią (do 300 GB/s) i budżetem mocy 45–80 W. W teście serwisu The Register laptop uruchomił Qwen3.6 35B-A3B z prędkością 67,6 tokena na sekundę – szybciej niż stacjonarny DGX Spark. Haczykiem jest Windows: GPU dostaje tylko stałą część pamięci – maksymalnie 16 GB z 32 GB, 48 GB z 64 GB i 96 GB ze 128 GB.
- Pamięć: 32, 64 lub 128 GB · przepustowość do 300 GB/s
- GPU: Blackwell, 6144 rdzenie (wydajnością mniej więcej jak laptopowa RTX 5070)
- System: Windows 11 na Arm, CUDA od wersji 13.4
- Uwaga: pierwsze egzemplarze (Surface, HP) w recenzjach zawieszały się po wielu godzinach pełnego obciążenia; Linux nie jest oficjalnie wspierany
- Cena w USA: od 2599 USD (Surface Laptop Ultra z 24 GB) do 5899,99 USD (Surface ze 128 GB), październik 2026
Dla kogo: duże modele na laptopie z Windows, agenci kodujący, praca kreatywna. Nie dla: długiego trenowania i oprogramowania tylko na x86; omijaj wersję z 32 GB.
4. Ryzen AI Max+ 395 – najtańsze 128 GB
Mini PC z 16-rdzeniowym Ryzenem i grafiką Radeon 8060S mają 128 GB współdzielonej pamięci. Szybkość pisania jest porównywalna z DGX Spark (gpt-oss-120b z prędkością 56,6 tokena na sekundę) za mniej więcej połowę ceny, a do tego działają na nich Windows i Linux – oraz gry. Słabym punktem jest czytanie promptu: jest dwa do trzech razy wolniejsze niż na Sparku i spada przy długim kontekście – do 146 tokenów na sekundę ze sterownikiem Vulkan i 371 z ROCm.
- Pamięć: 128 GB LPDDR5x · przepustowość 256 GB/s (~215 w pomiarach)
- Dla GPU: 96 GB w Windows, ~124 GB w Linuksie
- Oprogramowanie: Vulkan lub ROCm (gfx1151 jest oficjalnie wspierany od 2026 roku)
- HP Z2 Mini G1a kosztuje więcej, ale to certyfikowana stacja robocza z pamięcią ECC i trzyletnią gwarancją
- Przykładowa cena w USA: Framework Desktop ze 128 GB debiutował w cenie 1999 USD, a po podwyżce cen pamięci w 2026 roku kosztuje 2459 USD
Dla kogo: najwięcej pamięci za te pieniądze, duże modele MoE, czat i streszczenia. Nie dla: agentów z ogromnym kontekstem i CUDA; do dużych modeli nie wybieraj też tabletu ROG Flow Z13 z 32–64 GB.
5. Mac Studio M5 Ultra – król pamięci
Do 512 GB pamięci i przepustowość 1,2 TB/s. W recenzji MacStories M5 Ultra czytał prompty cztery razy szybciej niż poprzedni M3 Ultra i pisał o 50% szybciej. Wersja z 256 GB mieści nawet Qwen3 235B. Kilka egzemplarzy można połączyć przez Thunderbolt 5 i RDMA: według Apple cztery M5 Ultra uruchamiają model z 816 miliardami parametrów z prędkością 36,7 tokena na sekundę.
- Pamięć: 96, 256 lub 512 GB (512 GB trafi do sprzedaży pod koniec października) · przepustowość 1228 GB/s
- Pobór mocy: 9 W w spoczynku, około 300 W podczas pracy modelu
- Złącza: 6× Thunderbolt 5
- Uwaga: pamięci nie da się później rozbudować; we wrześniu czas oczekiwania sięgał 18 tygodni
- Cena katalogowa w USA: od 5499 USD (sierpień 2026); przejście z 96 na 256 GB to dodatkowe 4000 USD
Dla kogo: modele 100–250B, agenci z długim kontekstem, małe zespoły. Nie dla: modeli do 30B, CUDA, napiętego budżetu.
6. Mac mini M5 Pro – rozsądny punkt wejścia
Najtańszy Mac, który uruchamia naprawdę przydatne modele. Przepustowość 307 GB/s, do 64 GB pamięci i Thunderbolt 5. Dzięki akceleratorom neuronowym czyta prompty mniej więcej trzy razy szybciej niż poprzedni M4 Pro. Wersja z 64 GB swobodnie uruchamia modele do 32 miliardów parametrów; gęsta Llama 70B się mieści, ale osiąga tylko około 7 tokenów na sekundę, a gpt-oss-120b się nie mieści.
- Pamięć: 24, 48 lub 64 GB · przepustowość 307 GB/s
- Pobór mocy: 6 W w spoczynku, maks. 145 W · w spoczynku praktycznie bezgłośny
- Cena katalogowa w USA: od 1699 USD (konfiguracja podstawowa, sierpień 2026)
Dla kogo: modele 20–35B, cichy domowy serwer AI. Nie dla: gpt-oss-120b i gęstych modeli 70B; omijaj wersję z 24 GB.
7. Mac mini M6 – tani, ale nie w wersji 16 GB
Najtańszy Mac z akceleratorami neuronowymi. Kończy się na 32 GB i 170 GB/s – wersja z 16 GB ma tylko 153 GB/s i zostawia dla modelu około 12 GB. W porównaniu z poprzednim Makiem mini z M4 czyta prompty 4,5× szybciej i pisze o 50% szybciej przy praktycznie tej samej cenie, więc nie kupuj starego modelu nawet na promocji.
- Pamięć: 16, 24 lub 32 GB (maksimum) · przepustowość 153 / 170 GB/s
- Pobór mocy: 4 W w spoczynku, maks. 70 W
- Uwaga: tylko Thunderbolt 4, więc bez łączenia kilku egzemplarzy
- Cena katalogowa w USA: od 899 USD (konfiguracja podstawowa, sierpień 2026)
Dla kogo: modele 7–14B, gpt-oss-20b, Qwen3 30B-A3B. Nie dla: modeli 70B i większych; omijaj wersję z 16 GB.
8. MacBook Pro M5 Max – AI w podróży
Ten sam układ co w Mac Studio, a więc ta sama szybkość: to najszybszy laptop do lokalnych modeli. Ze średniej wielkości Qwen3.6 35B-A3B generuje ponad 90 tokenów na sekundę. Wersja 14-calowa przy długotrwałym obciążeniu obniża jednak moc (z 96 do 42 W), a ładowanie jest ograniczone do 97 W. Mac Studio z tym samym układem i 128 GB jest wyraźnie tańszy.
- Pamięć: 36, 48, 64 lub 128 GB · przepustowość 460 / 614 GB/s
- Bateria: 72,4 Wh (14″) / 100 Wh (16″)
- Cena katalogowa w USA: od 3599 USD (14″) i 3899 USD (16″), marzec 2026; przejście z 64 na 128 GB to dodatkowe 1000 USD
Dla kogo: osoby, które potrzebują dużych modeli w podróży, najlepiej w wersji 16-calowej z 64–128 GB. Nie dla: pracy całodobowej i tych, którzy pracują przy biurku; omijaj wersję z 36 GB.
9. RTX 5090 – najszybsza, ale tylko 32 GB
Przepustowość 1792 GB/s: gpt-oss-20b pisze z prędkością prawie 300 tokenów na sekundę, a karta czyta długi prompt mniej więcej dwa razy szybciej niż Mac Studio z M5 Ultra. 32 GB mieszczą modele do około 32 miliardów parametrów w 4 bitach, nawet z długim kontekstem; model z 70 miliardami parametrów się nie zmieści. Duże modele MoE można częściowo przenieść do systemowej pamięci RAM – gpt-oss-120b działa wtedy z prędkością około 30 tokenów na sekundę.
- Pamięć: 32 GB GDDR7 · przepustowość 1792 GB/s
- Pobór mocy: 575 W, zalecany zasilacz 1000 W
- Cena katalogowa w USA: 1999 USD na premierę (styczeń 2025); ceny sklepowe w 2026 roku są znacznie wyższe z powodu niedoboru pamięci
Dla kogo: agenci kodujący i RAG z modelami do 32B, programowanie w CUDA, gry. Nie dla: modeli 70B i większych, cichego i energooszczędnego serwera.
10. RTX 5060 Ti 16 GB – najtańszy sensowny start
Najtańsza nowa karta graficzna z 16 GB. Uruchamia gpt-oss-20b z prędkością około 92 tokenów na sekundę, Qwen3 8B – 69, a Qwen3 14B – 41. To szybciej, niż jesteś w stanie czytać. Jej przepustowość pamięci to jednak połowa tego, co oferuje RTX 5070 Ti, więc pisze mniej więcej o połowę wolniej, a modele w okolicach 30 miliardów parametrów nie mieszczą się w 16 GB.
- Pamięć: 16 GB GDDR7 · przepustowość 448 GB/s
- Pobór mocy: 180 W, wystarczy zasilacz 600 W
- Cena katalogowa w USA: 429 USD za wersję 16 GB na premierę (kwiecień 2025)
Dla kogo: pierwsze poważne eksperymenty, modele 8–20B, budżetowy komputer do AI. Nie dla: modeli 27B i większych.
11. RTX 5070 Ti czy RTX 5080 – w AI niemal identyczne
Obie karty mają 16 GB i niemal taką samą przepustowość (896 vs 960 GB/s), więc piszą niemal równie szybko: 182,4 vs 184,7 tokena na sekundę w standardowym teście llama.cpp i 74 vs 81 z Qwen3 14B. Mieszczą się w nich dokładnie te same modele. 5080 jest szybsza głównie w grach – a jej cena premierowa była o 250 USD wyższa (999 USD vs 749 USD).
Nasza rada: do AI weź RTX 5070 Ti, a zaoszczędzone pieniądze przeznacz na większy dysk SSD lub więcej RAM. RTX 5080 kupuj tylko wtedy, gdy głównym zastosowaniem są gry.
12. RTX PRO 6000 – 96 GB na jednej karcie
Jedyna karta, która pomieści w całości Llamę 3.3 70B (32 tokeny na sekundę), gpt-oss-120b (170,6 tokena na sekundę w wersji Max-Q) i Qwen3.5 122B (około 98 tokenów na sekundę). Dzięki CUDA i vLLM może obsługiwać kilku użytkowników jednocześnie. Kupisz ją jako osobną kartę albo w gotowej stacji roboczej.
- Pamięć: 96 GB GDDR7 z ECC · przepustowość 1792 GB/s
- Pobór mocy: 300 W (Max-Q); pełna wersja 600 W pisze o około 13% szybciej
- Cena katalogowa w USA: 8565 USD na premierę; NVIDIA podniosła ją później do 13 250 USD
Dla kogo: firmy i zespoły, które chcą uruchamiać lub trenować duże modele u siebie. Nie dla: użytkowników indywidualnych i hobbystów.
13. DGX Spark od ASUS-a, MSI, Lenovo, Della i Gigabyte’a – który wybrać
Ten sam układ GB10 co DGX Spark sprzedaje pięciu innych producentów. Wydajność AI różni się zaledwie o kilka procent; różnice dotyczą dysku, zasilacza, chłodzenia i wsparcia – oraz ceny.
| Model | Dysk | Zasilacz | Wyróżnik |
|---|---|---|---|
| NVIDIA / PNY DGX Spark | 4 TB, samoszyfrujący | 240 W | oryginał |
| GIGABYTE AI TOP ATOM | 4 TB PCIe 5.0 | 240 W | najszybszy SSD |
| ASUS Ascent GX10 | 1 TB PCIe 4.0 / 4 TB PCIe 5.0 | 240 W | włącznik z przodu |
| Lenovo ThinkStation PGX | 1 / 2 / 4 TB, samoszyfrujący | 240 W | rok serwisu u klienta |
| Dell Pro Max with GB10 | PCIe 4.0 (2 TB to QLC) | 280 W | mocniejszy zasilacz, najgorętszy SSD |
| MSI EdgeXpert | 4 TB | – | nowość, brak niezależnych testów |
Nasza rada: najlepszy zestaw za rozsądne pieniądze to Gigabyte AI TOP ATOM z 4 TB szybkiego dysku; najtańszy sprawdzony punkt startowy to ASUS Ascent GX10 z 1 TB, który w USA debiutował w cenie około 3000 USD. Jeśli planujesz połączyć dwa egzemplarze, potrzebujesz kabla QSFP. Nowość od 23 października 2026: wersja GB10 z 64 GB, sprzedawana wyłącznie przez marki partnerskie, od 4999 USD.
14. Radeon AI PRO R9700 – 32 GB za ułamek ceny RTX 5090
Najtańsza nowa karta z 32 GB. W tym samym teście Vulkan pisze o około 40% wolniej niż RTX 5090, ale mieści te same modele – około 30 miliardów parametrów, także z dłuższym kontekstem. gpt-oss-20b i Qwen3 30B-A3B działają na niej z prędkością ponad 150 tokenów na sekundę. Uważaj na marketing: „nawet pięć razy szybsza od RTX 5080” dotyczy tylko modelu, który nie mieści się w 16 GB.
- Pamięć: 32 GB GDDR6 · przepustowość ~640 GB/s · pobór mocy 300 W
- Oprogramowanie: Vulkan (zwykle szybsze pisanie) lub ROCm (szybsze czytanie promptu); bez CUDA
- Cena katalogowa w USA: 1299 USD (październik 2025)
Dla kogo: modele 27–32B z długim kontekstem, kilka kart w jednym PC. Nie dla: narzędzi działających tylko z CUDA, maksymalnej szybkości.
15. „Komputery AI” i laptopy Copilot+ – mit
Copilot+ to certyfikacja Microsoftu dla funkcji Windows – efektów kamery, napisów na żywo, Recall czy małego wbudowanego modelu Phi Silica. Nie mówi nic o możliwości uruchamiania dużych modeli językowych. Ani Ollama, ani LM Studio nie korzystają z jednostki przetwarzania neuronowego (NPU), a llama.cpp tylko eksperymentalnie; NPU wykorzystują jedynie narzędzia producentów, takie jak Microsoft Foundry Local czy AMD Lemonade, z wybranymi modelami.
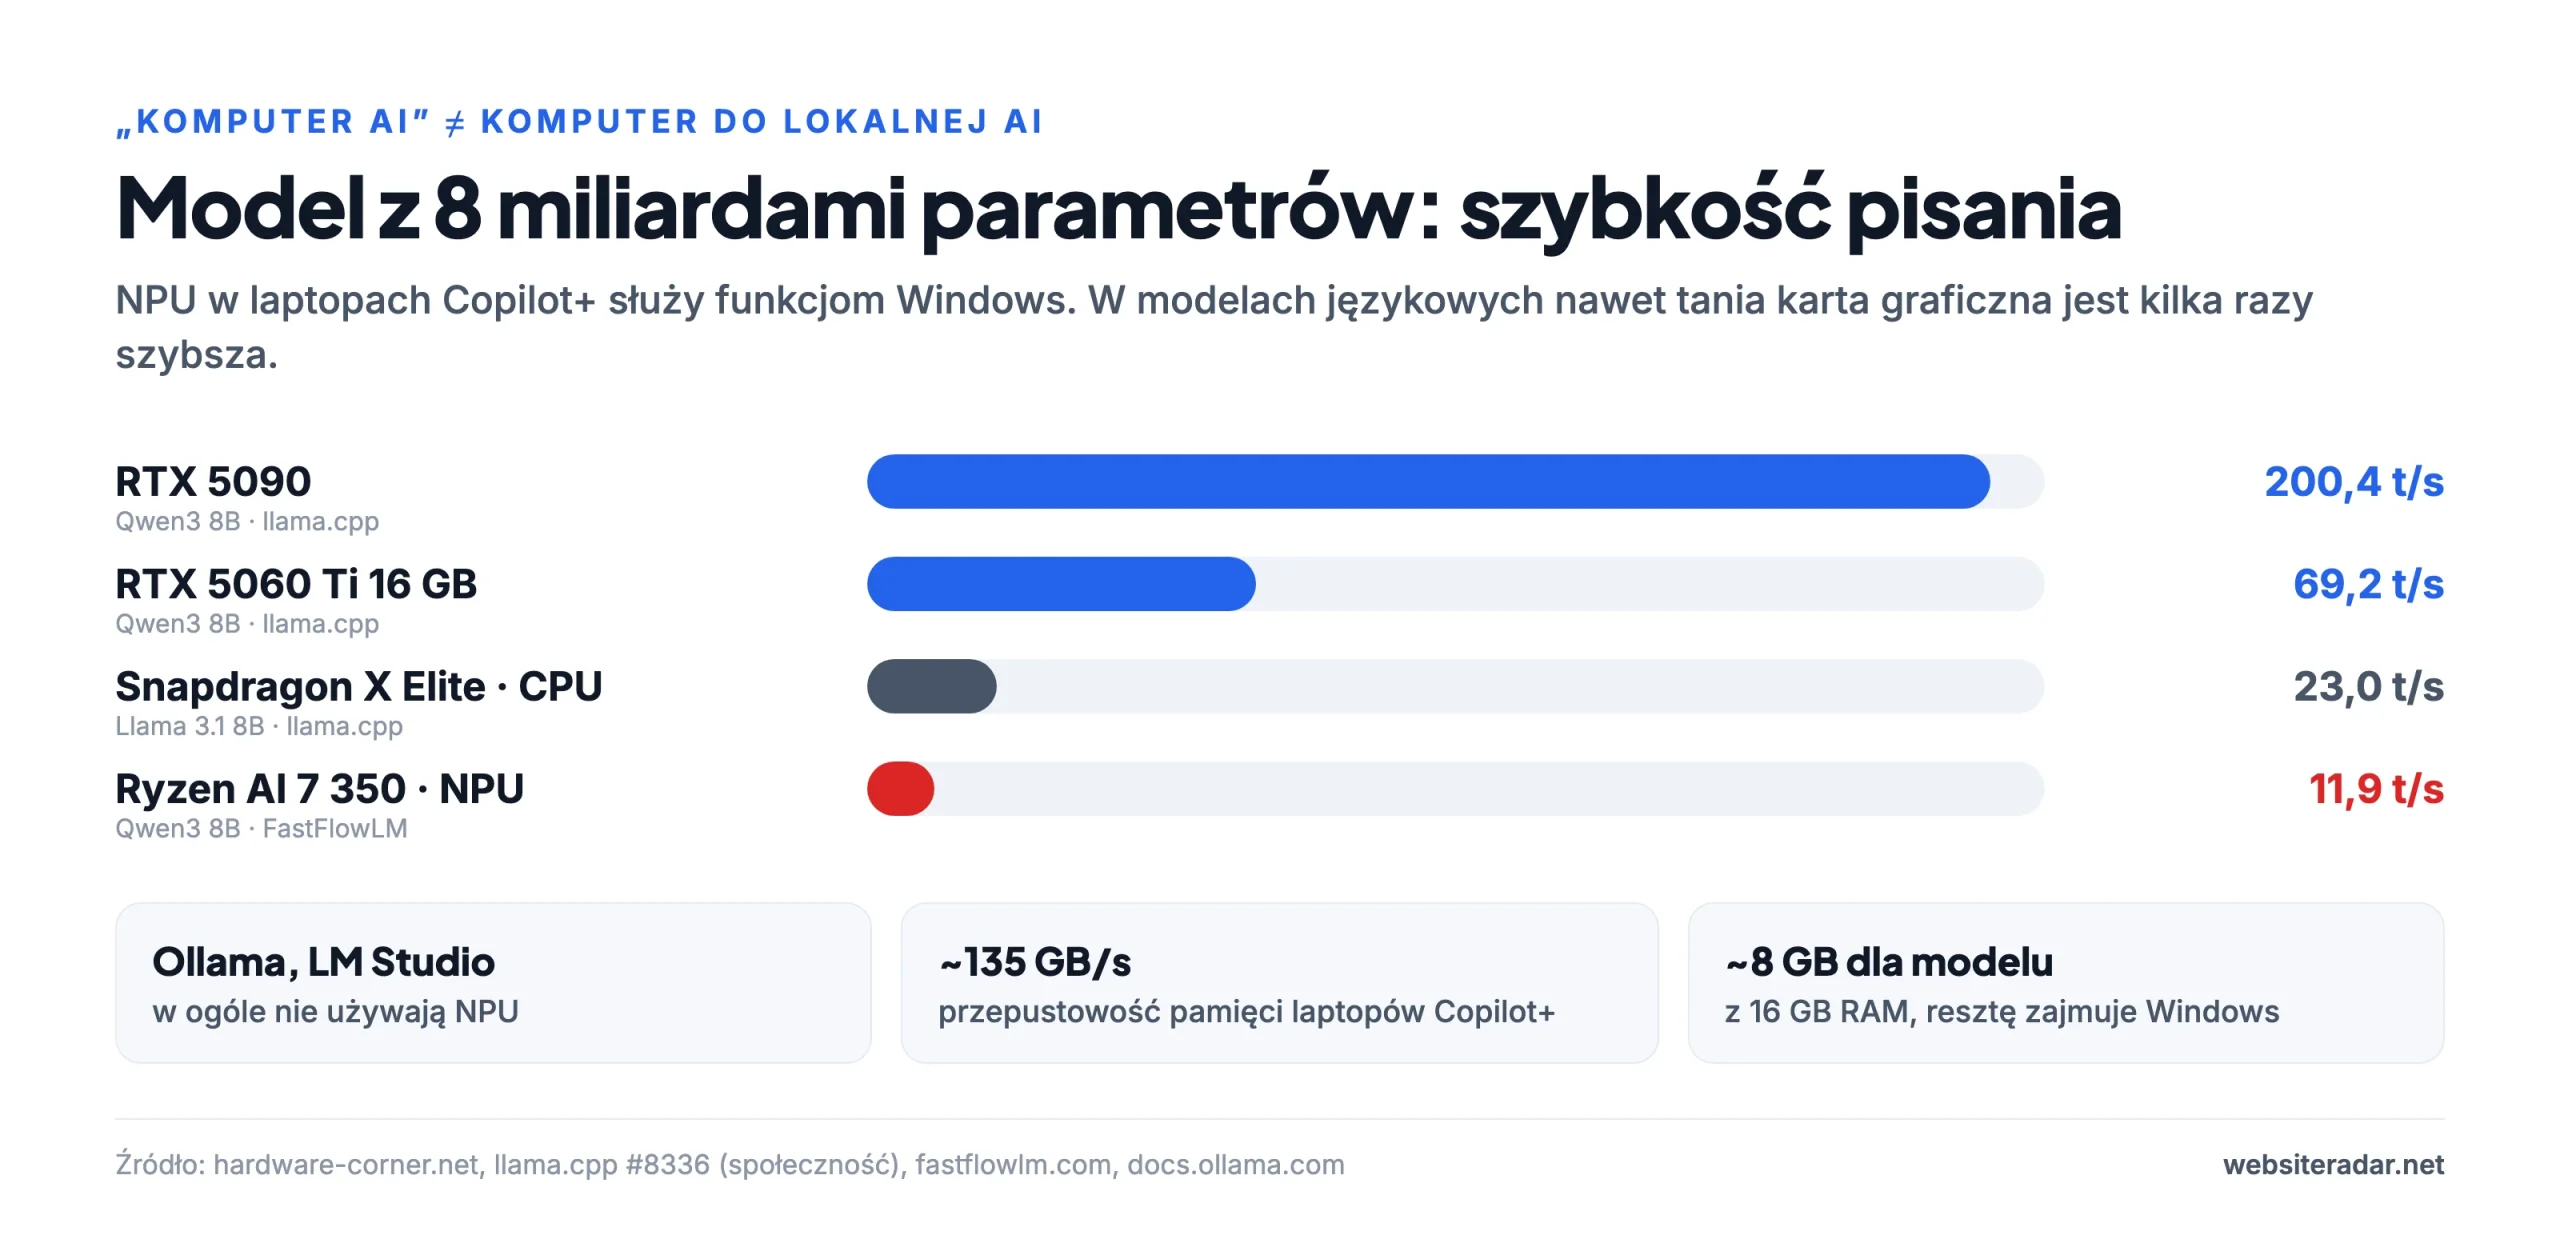
Do tego te laptopy mają pamięć o przepustowości około 135 GB/s i 16 GB RAM, co zostawia dla modelu około 8 GB. Wystarczą do modeli do 4 miliardów parametrów i funkcji Windows – nie do „własnego ChatGPT w domu”.
Dla kogo: praca biurowa, długi czas pracy na baterii, małe modele 1–4B. Nie dla: tych, którzy chcą uruchamiać modele 14B lub większe.
Pobór mocy i koszty eksploatacji
Jeśli komputer ma działać jako domowy serwer AI przez całą dobę, liczą się też pobór mocy i hałas.
| Urządzenie | Spoczynek | Praca modelu / maksimum | Uwagi |
|---|---|---|---|
| Mac mini M6 | 4 W | maks. 70 W | praktycznie bezgłośny |
| Mac mini M5 Pro | 6 W | maks. 145 W | 5 dBA w spoczynku (Apple) |
| Mac Studio M5 Max | 7 W | maks. 200 W | cichy |
| Mac Studio M5 Ultra | 9 W | ~300 W przy AI | cichy według recenzji |
| DGX Spark | 25–45 W | 60–90 W przy AI, szczytowo do 200 W | zależy od wersji firmware’u |
| Mini PC z Ryzen AI Max+ 395 | ~13 W | 120–160 W | HP Z2 Mini głośny pod obciążeniem |
| RTX 5090 (sama karta) | – | do 575 W | plus reszta komputera |
| RTX 5060 Ti (sama karta) | – | do 180 W |
Dane pochodzą od producentów i z recenzji (ServeTheHome, Tom’s Hardware, Notebookcheck) i nie były mierzone tą samą metodą – traktuj je orientacyjnie.
Oprogramowanie: czym uruchomić model
- Ollama – najprostszy start na każdej platformie; model pobierasz jednym poleceniem. Na Macu od wersji 0.19 (wciąż w wersji preview, dla wybranych modeli) korzysta z MLX i akceleratorów neuronowych M5.
- LM Studio – przejrzysta aplikacja z interfejsem graficznym. Wskazówka dla Maków z M5: przy modelach GGUF nie korzysta jeszcze z akceleratorów neuronowych i czyta prompty mniej więcej o połowę wolniej; zamiast nich używaj modeli w formacie MLX.
- llama.cpp – fundament większości innych narzędzi, z największą liczbą ustawień i najszybszym wsparciem nowego sprzętu. Na Ryzen AI Max wypróbuj oba backendy: Vulkan zwykle szybciej pisze, ROCm szybciej czyta długie prompty.
- MLX – biblioteka Apple z najlepszą wydajnością na Macu, łącznie z łączeniem kilku Maków przez Thunderbolt 5.
- vLLM, SGLang, TensorRT-LLM – narzędzia serwerowe dla NVIDII, gdy jeden model obsługuje kilku użytkowników jednocześnie.
Najczęstsze błędy przy zakupie
- Mac z 36 GB „do AI”. Ma słabszy układ i zostawia dla modelu tylko około 27 GB.
- Laptop RTX Spark z 32 GB. Windows daje GPU maksymalnie 16 GB.
- Mac mini M6 z 16 GB. Wolniejsza pamięć i tylko około 12 GB dla modelu.
- Laptop Copilot+ do lokalnej AI. Popularne narzędzia nie korzystają z NPU.
- RTX 5080 zamiast 5070 Ti tylko do AI. Te same 16 GB, niemal ta sama szybkość.
- Ignorowanie przepustowości pamięci. Duża, ale wolna pamięć oznacza powolne pisanie w przypadku modeli gęstych.
- Oszczędzanie na pamięci. W Makach, Ryzen AI Max i RTX Spark pamięć jest wlutowana i nie da się jej później dołożyć.
Najczęściej zadawane pytania
Czy 16 GB wystarczy do lokalnej AI? Do modeli do 14–20 miliardów parametrów – tak, na przykład gpt-oss-20b czy Qwen3 14B. Modele w okolicach 30 miliardów potrzebują 24–32 GB, a 70 miliardów – co najmniej 48 GB.
Mac czy NVIDIA? Mac pisze szybciej i daje więcej pamięci za te same pieniądze; NVIDIA szybciej czyta prompty i ma CUDA. W czacie i agentach z modelami MoE wygrywa Mac; w programowaniu, trenowaniu i obsłudze kilku użytkowników – NVIDIA.
Co oznacza „MoE”? Mixture of experts (mieszanina ekspertów): model ma wiele parametrów, ale do każdego słowa używa tylko niewielkiej ich części. Potrzebuje dużo pamięci, ale pisze z szybkością mniejszego modelu.
Jak szybko musi pisać model? Około 15 tokenów na sekundę odpowiada tempu czytania. Do płynnego czatu komfortowe jest 30 lub więcej; przy agentach kodujących, które generują dużo tekstu, lepiej mieć 50 lub więcej.
Czy lokalna AI jest tańsza niż abonament? Zwykle nie – modele porównywalne z najlepszymi usługami w chmurze wymagają maszyn kosztujących wiele tysięcy dolarów. Główne powody to prywatność, kontrola nad danymi i niezależność.
Czy mogę połączyć kilka komputerów? Tak. Dwa DGX Spark łączy się kablem QSFP, Maki – przez Thunderbolt 5 z RDMA (za pomocą MLX lub exo). Mac mini M6 tego nie potrafi, bo ma tylko Thunderbolt 4.
Jak porównywaliśmy i źródła
Nie testowaliśmy urządzeń samodzielnie. Liczby pochodzą ze zweryfikowanych źródeł, które zawsze podajemy na wykresach. Szybkość porównujemy w jednym programie (llama.cpp), bo inny program lub inna kwantyzacja mogą łatwo przesunąć wyniki o 20–50%. Pomiary społeczności (GitHub, fora) są oznaczone. Ceny to amerykańskie ceny katalogowe z zapowiedzi producentów i recenzji, z podaną datą.
- Model przelewający się do RAM, RTX 5060 Ti: inventivehq.com/blog/vram-offload-cliff-gpu-layers-benchmark
- Benchmark DGX Spark: github.com/ggml-org/llama.cpp/blob/master/benches/dgx-spark/dgx-spark.md
- Poradnik gpt-oss i pomiary GPU: github.com/ggml-org/llama.cpp/discussions/15396
- M5 Max i LM Studio: github.com/lmstudio-ai/lmstudio-bug-tracker/issues/2040
- Ryzen AI Max (Strix Halo): strix-halo-toolboxes.com, llm-tracker.info/_TOORG/Strix-Halo
- Apple: apple.com/mac-studio/specs, apple.com/mac-mini/specs, machinelearning.apple.com/research/mlx-distributed-inference
- M5 Ultra: macstories.net/stories/m5-ultra-mac-studio-review-the-dream-mac-for-local-ai-agents
- RTX Spark: theregister.com (16 października 2026), servethehome.com, storagereview.com
- Karty graficzne GeForce: nvidia.com/en-us/geforce/graphics-cards/compare, hardware-corner.net/gpu-llm-benchmarks
- Rankingi llama.cpp: github.com/ggml-org/llama.cpp/discussions/15013 i /10879
- Copilot+ PC: microsoft.com/windows/windows-11-specifications, docs.ollama.com/gpu, fastflowlm.com
- Rozmiary modeli: huggingface.co (repozytoria ggml-org, unsloth i bartowski)
- Ceny: Apple Newsroom, NVIDIA Newsroom i fora deweloperskie, servethehome.com, storagereview.com, notebookcheck.net, tomshardware.com