Weboldalunk linkeket tartalmaz a partneroldalakra. Ha webhelyünkről a partner webhelyére kattint és ott vásárolja meg a szolgáltatásait, jutalékot kapunk a közvetítésért (További információ). Az együttműködés ezen formája nem befolyásolja értékeléseink objektivitását. Minden, a weboldalunkon keresztül történő vásárlással támogatja szerkesztőségünket, hogy a jövőben is minőségi és hasznos tartalmat készíthessünk. Köszönjük.

Helyi AI-hardver 2026-ban: milyen számítógép kell az LLM-ek otthoni futtatásához
Tartalom
Saját gépen szeretnél nyelvi modelleket futtatni – előfizetés nélkül, úgy, hogy az adataid nem hagyják el az asztalodat, és még internetkapcsolat sem kell hozzá? Akkor a processzor és a dobozon díszelgő „TOPS” matrica sokkal kevésbé számít, mint két másik dolog: mennyi memóriát használhat a modell, és milyen gyorsan tudja a gép olvasni ezt a memóriát. Ez az útmutató elmagyarázza, hogyan fut valójában a helyi AI egy számítógépen, mennyi memóriát igényelnek a népszerű modellek, és hogyan teljesítenek a gyakorlatban a mai hardverek – a meglévő PC-be tehető videokártyától egészen az egész csapatot kiszolgáló munkaállomásig. Minden eszközhöz ellenőrzött számokat, forrásokat és egyértelmű ítéletet adunk arról, kinek való; néhány fejezethez rövid videó is tartozik.
A lényeg 30 másodpercben
- A memória dönt mindenről. A teljes modellnek bele kell férnie egy olyan gyors memóriába, amelyet a GPU elér. 4 bites kvantálásnál számolj nagyjából milliárd paraméterenként 0,6 GB-tal.
- A memória-sávszélesség határozza meg, milyen gyorsan ír a modell, a számítási teljesítmény pedig azt, milyen gyorsan olvassa be a hosszú promptot. Ezért ír gyorsabban a Mac, mint a DGX Spark, a Spark viszont gyorsabban dolgozza fel a hosszú dokumentumokat.
- Jelenleg a legjobb ár-érték: Mac Studio M5 Max 128 GB-tal (gyors kimenet), Ryzen AI Max+ 395 128 GB-tal (a legolcsóbb nagy memória), RTX 5060 Ti 16 GB (a legolcsóbb értelmes belépő).
- Az NPU-val szerelt „AI PC” nem helyi AI-ra való számítógép. Sem az Ollama, sem az LM Studio nem használja az NPU-t.
Az eszközöket nem teszteltük saját magunk – a számok a cikk végén felsorolt forrásokból származnak, a közösségi méréseket külön jelöljük. Az árak dátummal ellátott amerikai listaárak; a memóriahiány miatt 2026 folyamán sok közülük emelkedett.
Mit érdemes venni: gyors ajánló
Ha nem akarod végigolvasni az egész útmutatót, itt a rövidített változat. Minden ajánlást lejjebb részletesen is bemutatunk, néhányat videóval.
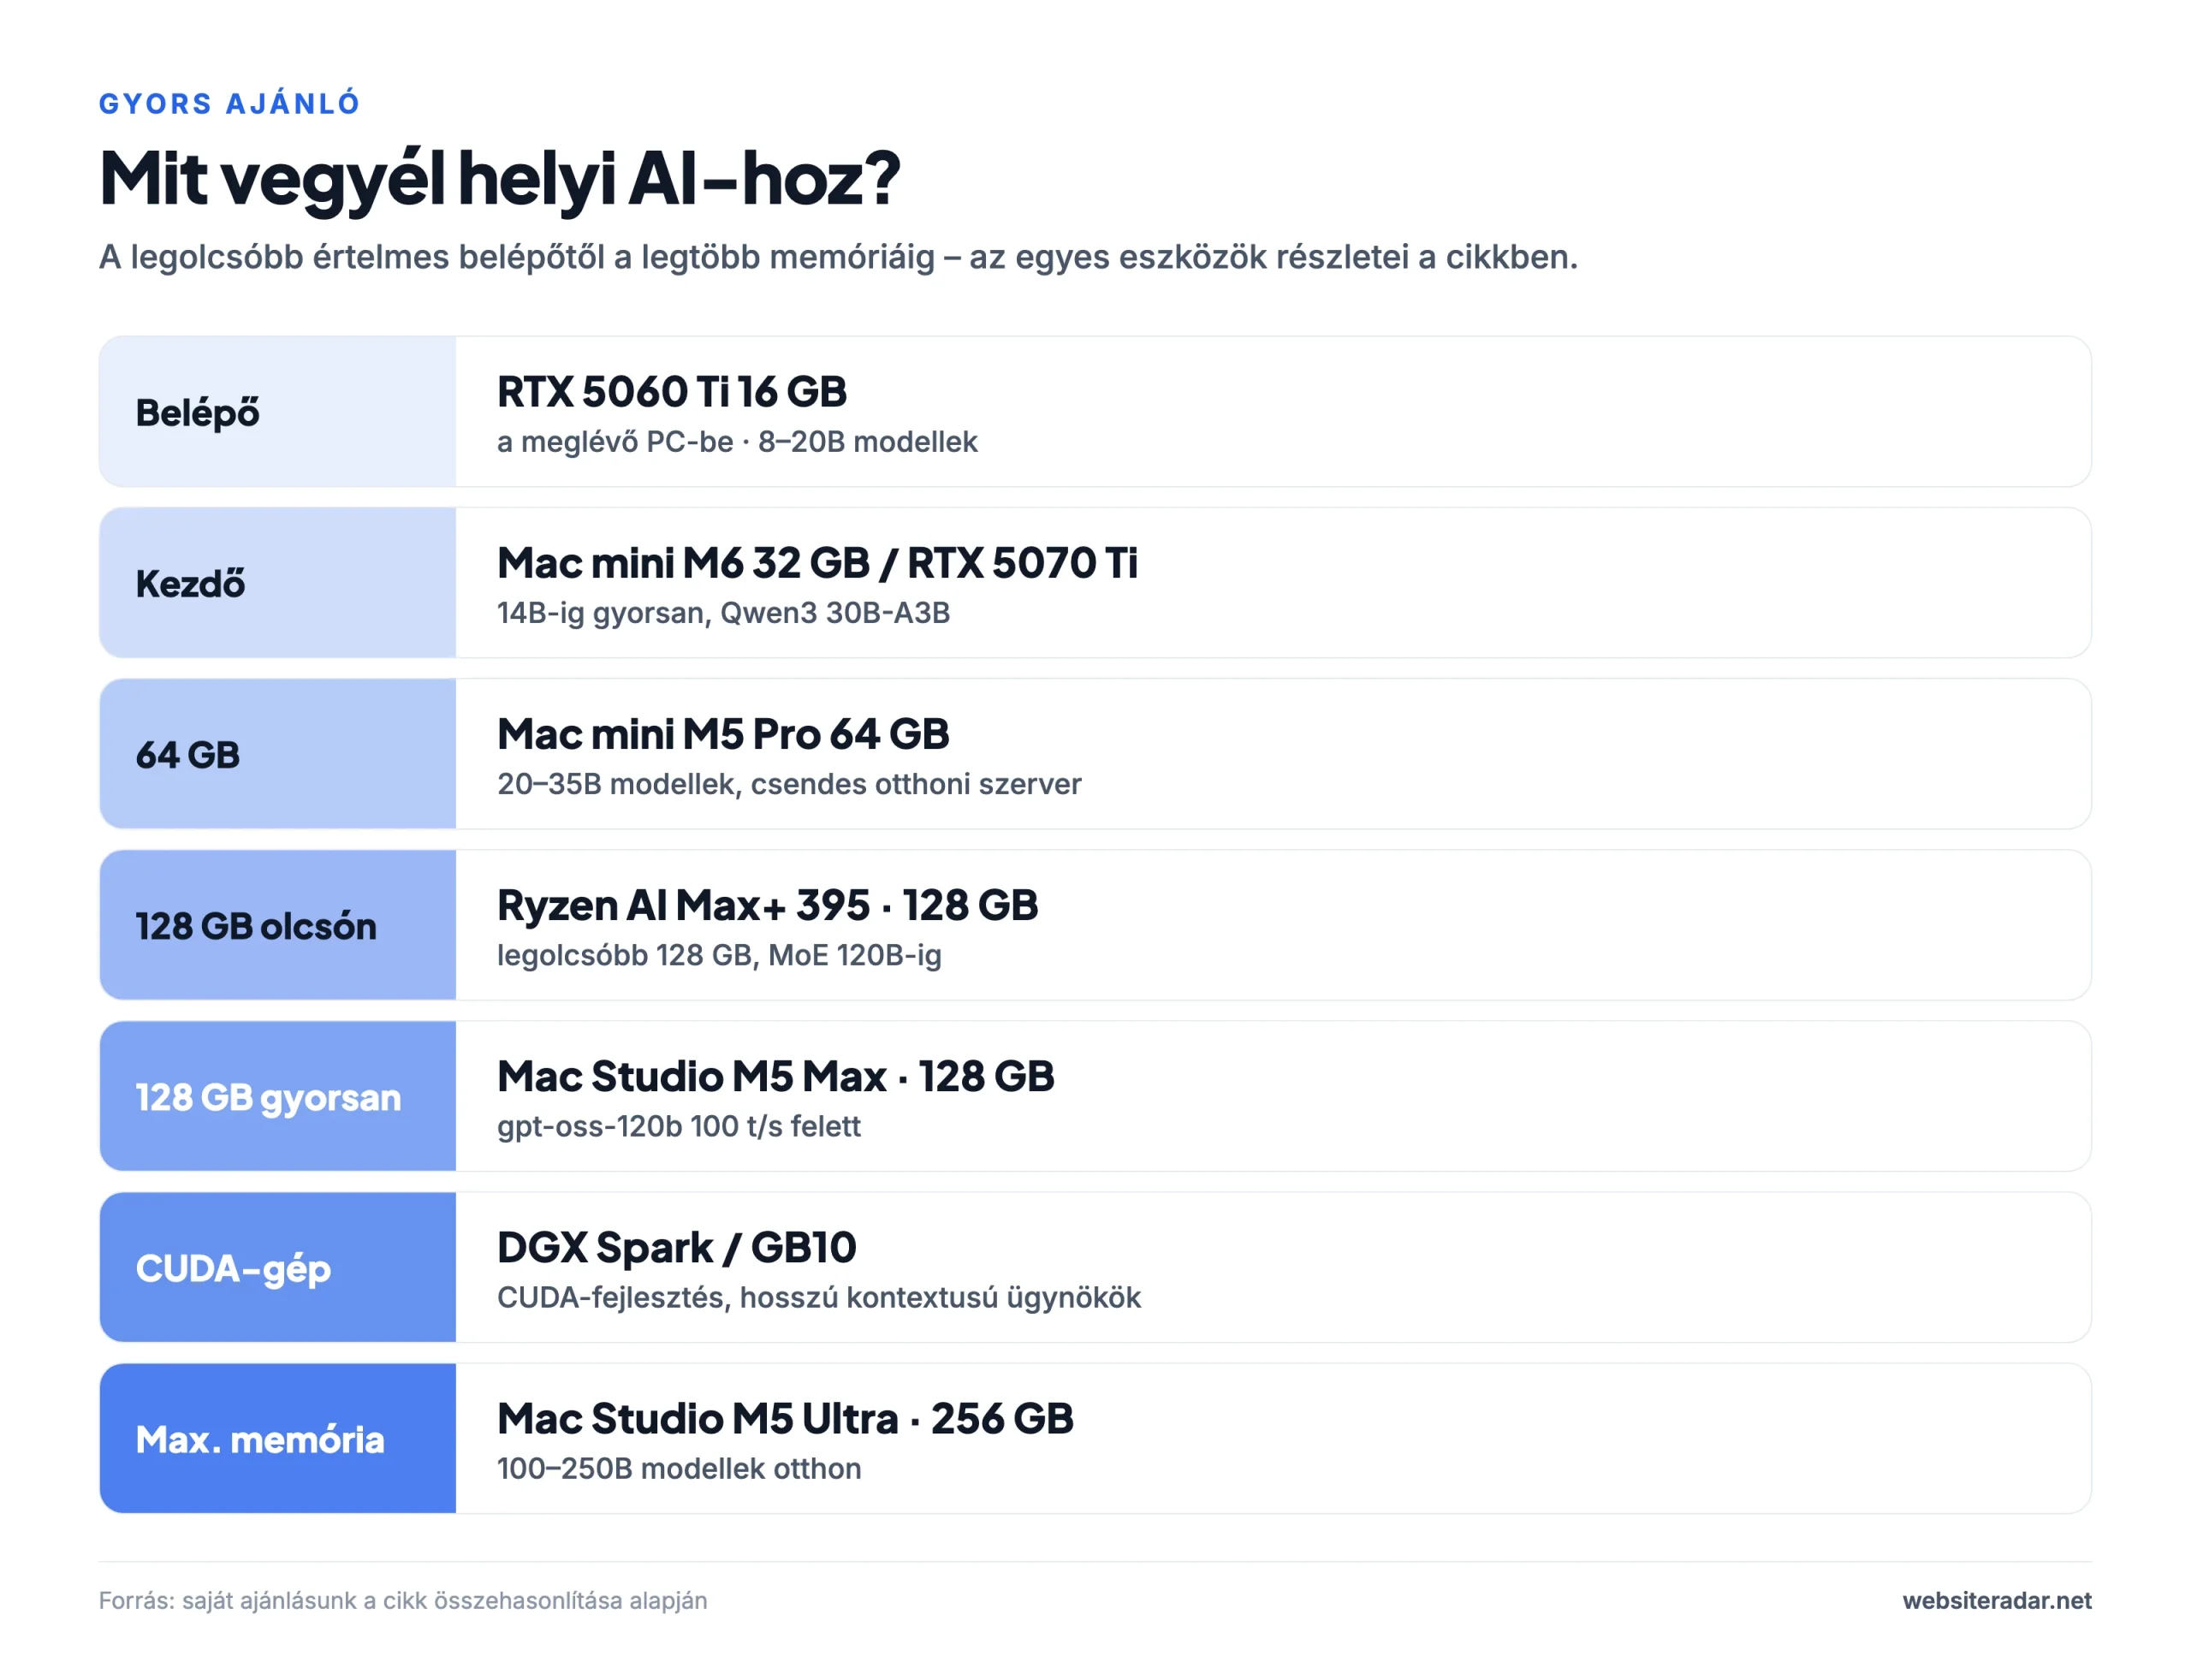
| Kategória | Ajánlat | Milyen modellekhez |
|---|---|---|
| Belépő | RTX 5060 Ti 16 GB a meglévő PC-be | 8–20B (Qwen3 14B, gpt-oss-20b) |
| Kezdő | Mac mini M6 32 GB-tal vagy RTX 5070 Ti | 14B-ig gyorsan, Qwen3 30B-A3B |
| 64 GB | Mac mini M5 Pro 64 GB-tal | 20–35B, csendes otthoni szerver |
| 128 GB, legjobb ár-érték | Ryzen AI Max+ 395 128 GB-tal | nagy MoE-modellek 120B-ig |
| 128 GB, leggyorsabb kimenet | Mac Studio M5 Max 128 GB-tal | gpt-oss-120b 100 token/s felett |
| CUDA-fejlesztői gép | DGX Spark vagy más GB10-es gép | CUDA-fejlesztés, kódoló ügynökök |
| Maximális memória | Mac Studio M5 Ultra 256 GB-tal | 100–250B-s modellek otthon |
| Csapat-munkaállomás | RTX PRO 6000 | 70–120B egy egész csapatnak |
Miért érdemes helyben futtatni az AI-t – és mit ne várj tőle
A helyi modell a saját számítógépeden fut. Az adataid nem hagyják el az asztalodat, nem fizetsz havi előfizetést vagy tokenalapú díjat, a modell internet nélkül is működik, és senki sem változtathatja meg vagy vezetheti ki egyik napról a másikra. Ezért jó választás érzékeny dokumentumokhoz, céges kódon dolgozó kódolási asszisztensekhez, naponta több ezer kérést küldő automatizációkhoz – vagy egyszerűen a kísérletezés öröméért.
Két bökkenő van. Az egyik, hogy az otthoni hardverre férő nyílt modellek okosak, de nem érik el a legjobb felhőszolgáltatások szintjét. A másik, hogy a hardver nem olcsó, és 2026-ban a memóriahiány felfelé hajtja az árakat. A helyi futtatás mellett elsősorban az adatvédelem, a kontroll és a függetlenség szól – nem a spórolás.
Hogyan fut a modell a gépeden
Amikor kérdést küldesz a modellnek, két fázis zajlik le, és mindkettőt más korlátozza:
- A prompt beolvasása (prefill). A modell egyszerre dolgozza fel a teljes bemenetet – a kérdést, a bemásolt dokumentumot, a projekted kódját. Ez a fázis a GPU számítási teljesítményén múlik, és ez határozza meg, mennyit vársz a válasz első szavára. Egy rövid kérdésnél a másodperc töredékéig tart, egy több tízezer szavas dokumentumnál akár percekig is.
- A válasz írása (decode). A modell szavanként (pontosabban tokenenként) generálja a szöveget. Minden tokenhez be kell olvasnia a memóriából a teljes modellt – a szakértőkeveréket (mixture of experts) használó modelleknél csak az aktív részét. Ez a fázis a memória-sávszélességen múlik: hány gigabájtot tud a chip másodpercenként beolvasni.
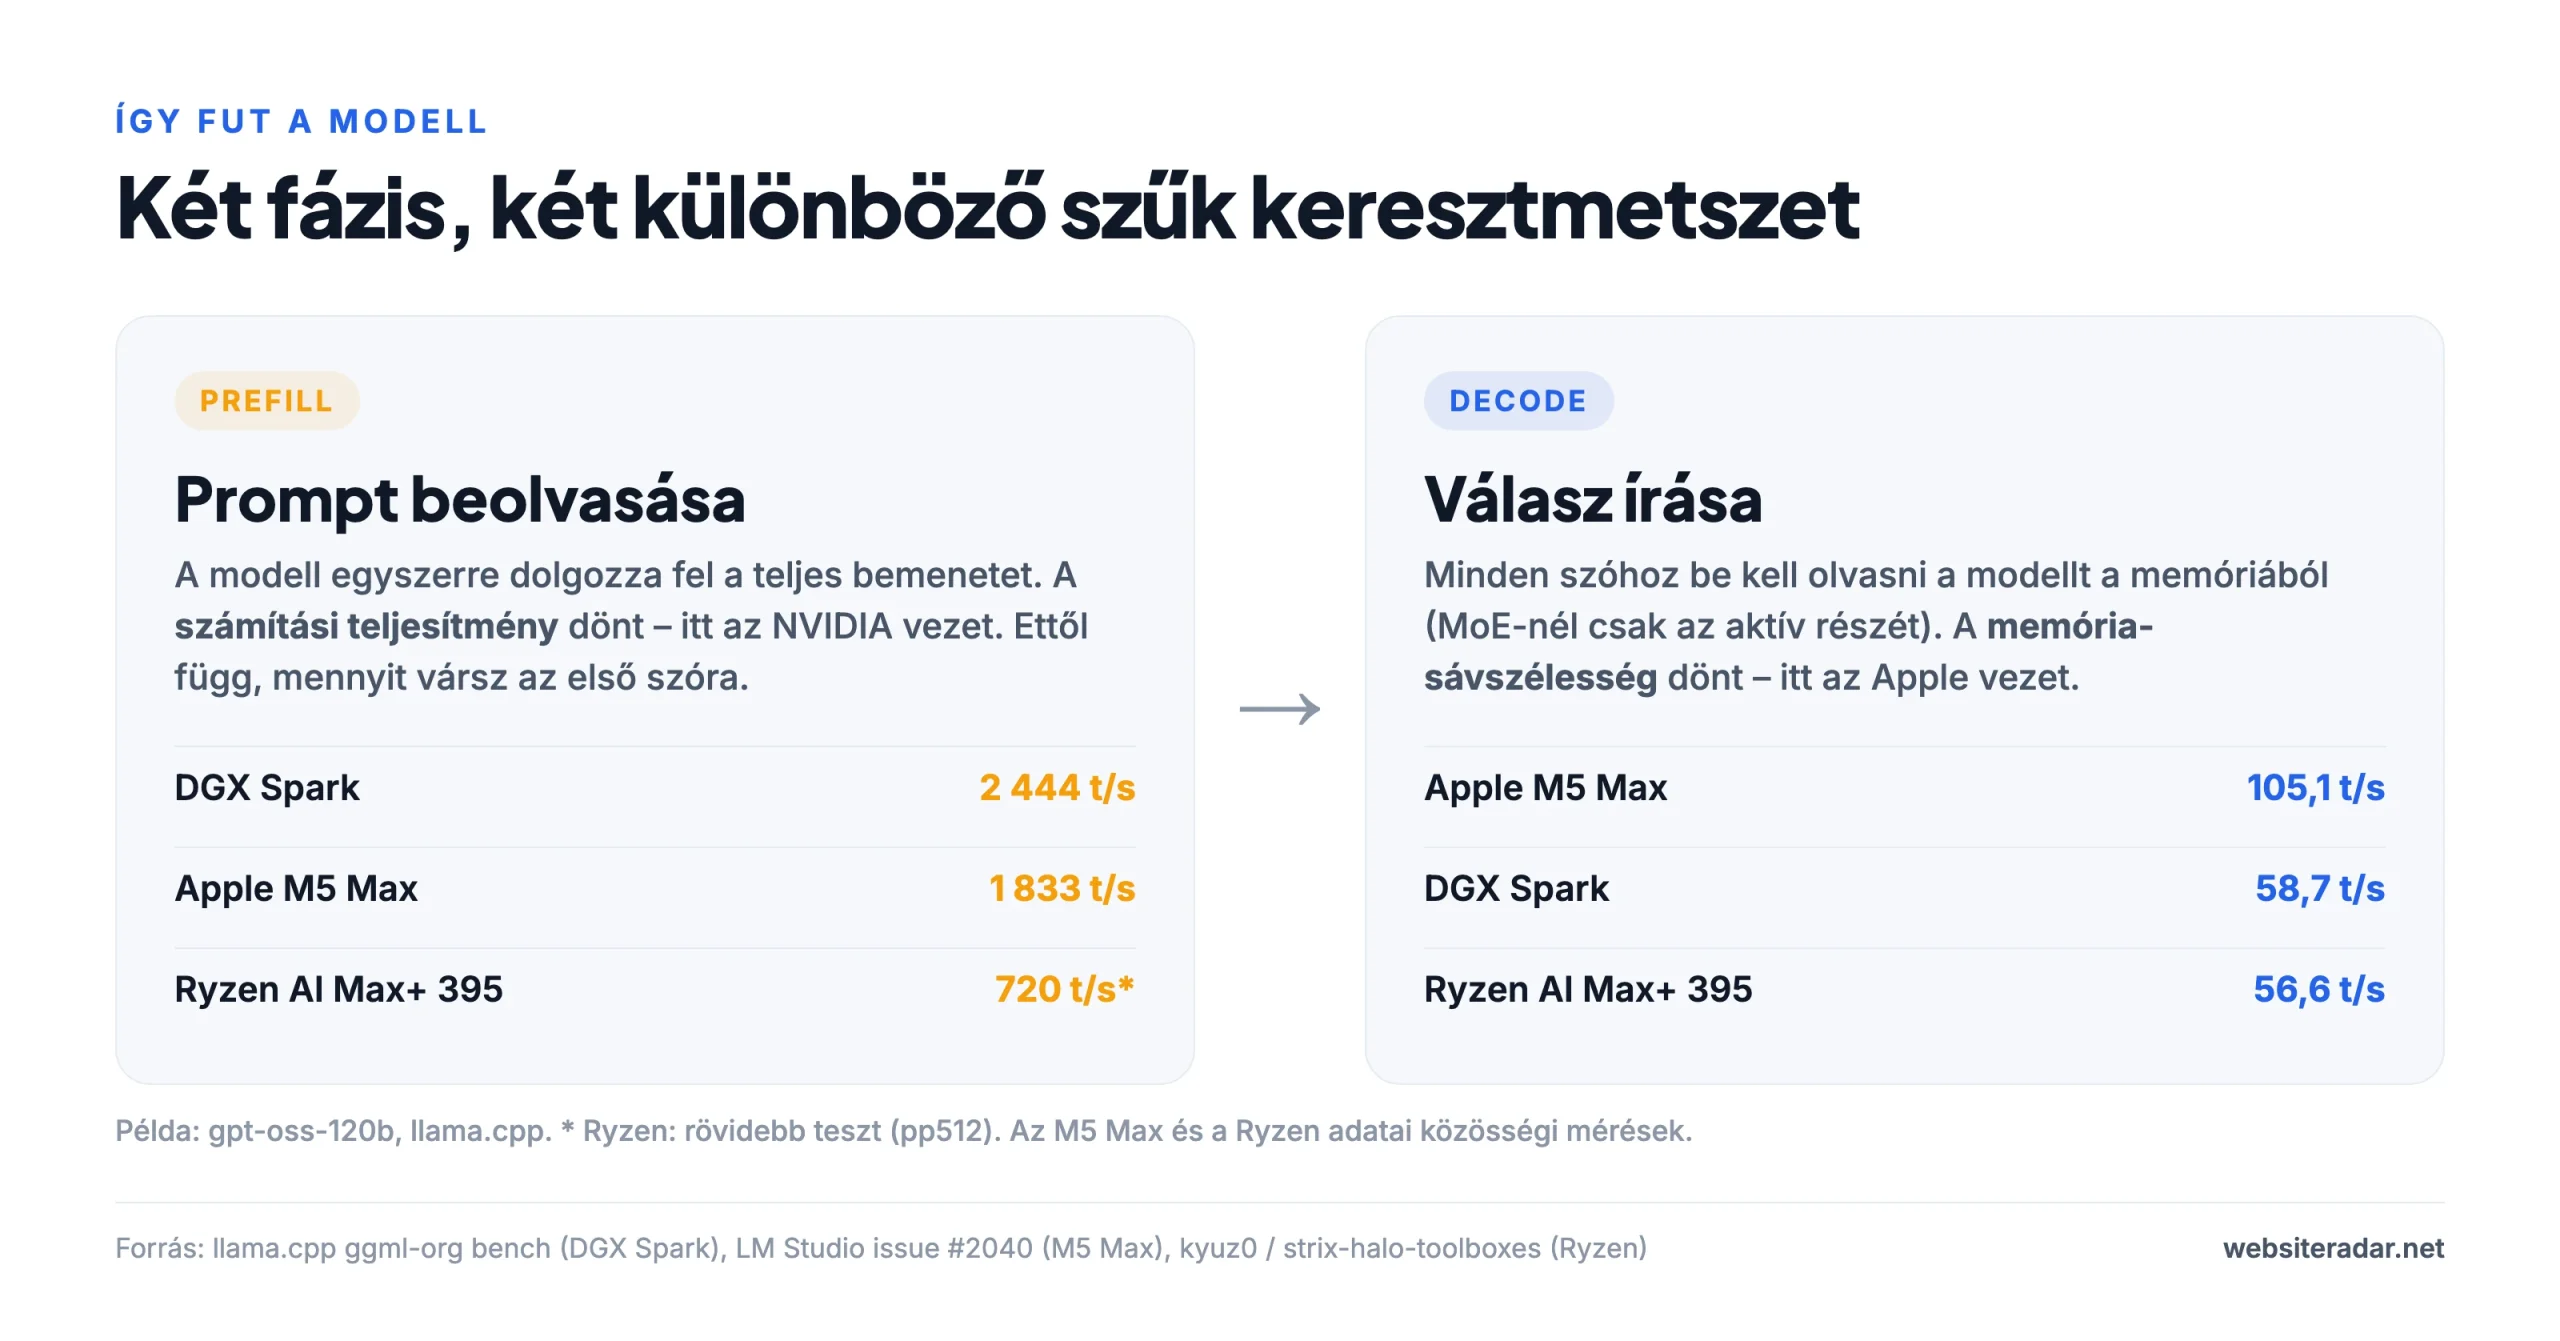
A gyakorlati különbség: csevegésnél a gyors kimenetet érzed (és itt brillírozik a Mac). Kódoló ügynököknél és dokumentumokkal végzett munkánál, amelyek folyamatosan hatalmas kontextust küldenek a modellnek, a gyors promptbeolvasás ugyanolyan fontos (és itt az NVIDIA vezet). A sebességet token másodpercenként (token/s) mérjük – egy token nagyjából háromnegyed szó. Körülbelül 15 token/s felel meg az olvasási sebességnek; 50 felett a modell fürgének érződik.
Mennyi memória kell
A teljes modellnek olyan gyors memóriában kell ülnie, amelyhez a GPU hozzáfér: vagy a videokártya VRAM-jában, vagy a Macekben, a DGX Sparkban és a Ryzen AI Maxban található közös (egyesített, unified) memóriában. Ha nem fér bele, egy része átkerül a normál rendszermemóriába, és a sebesség összeomlik. Egy RTX 5060 Ti-on végzett teszten már az is, hogy a Qwen 14B rétegeinek csak a hatodát tették át a GPU-ról, 43-ról 12,5 token/s-ra vetette vissza a kimeneti sebességet; pusztán a processzoron 2,9 token/s jött ki.
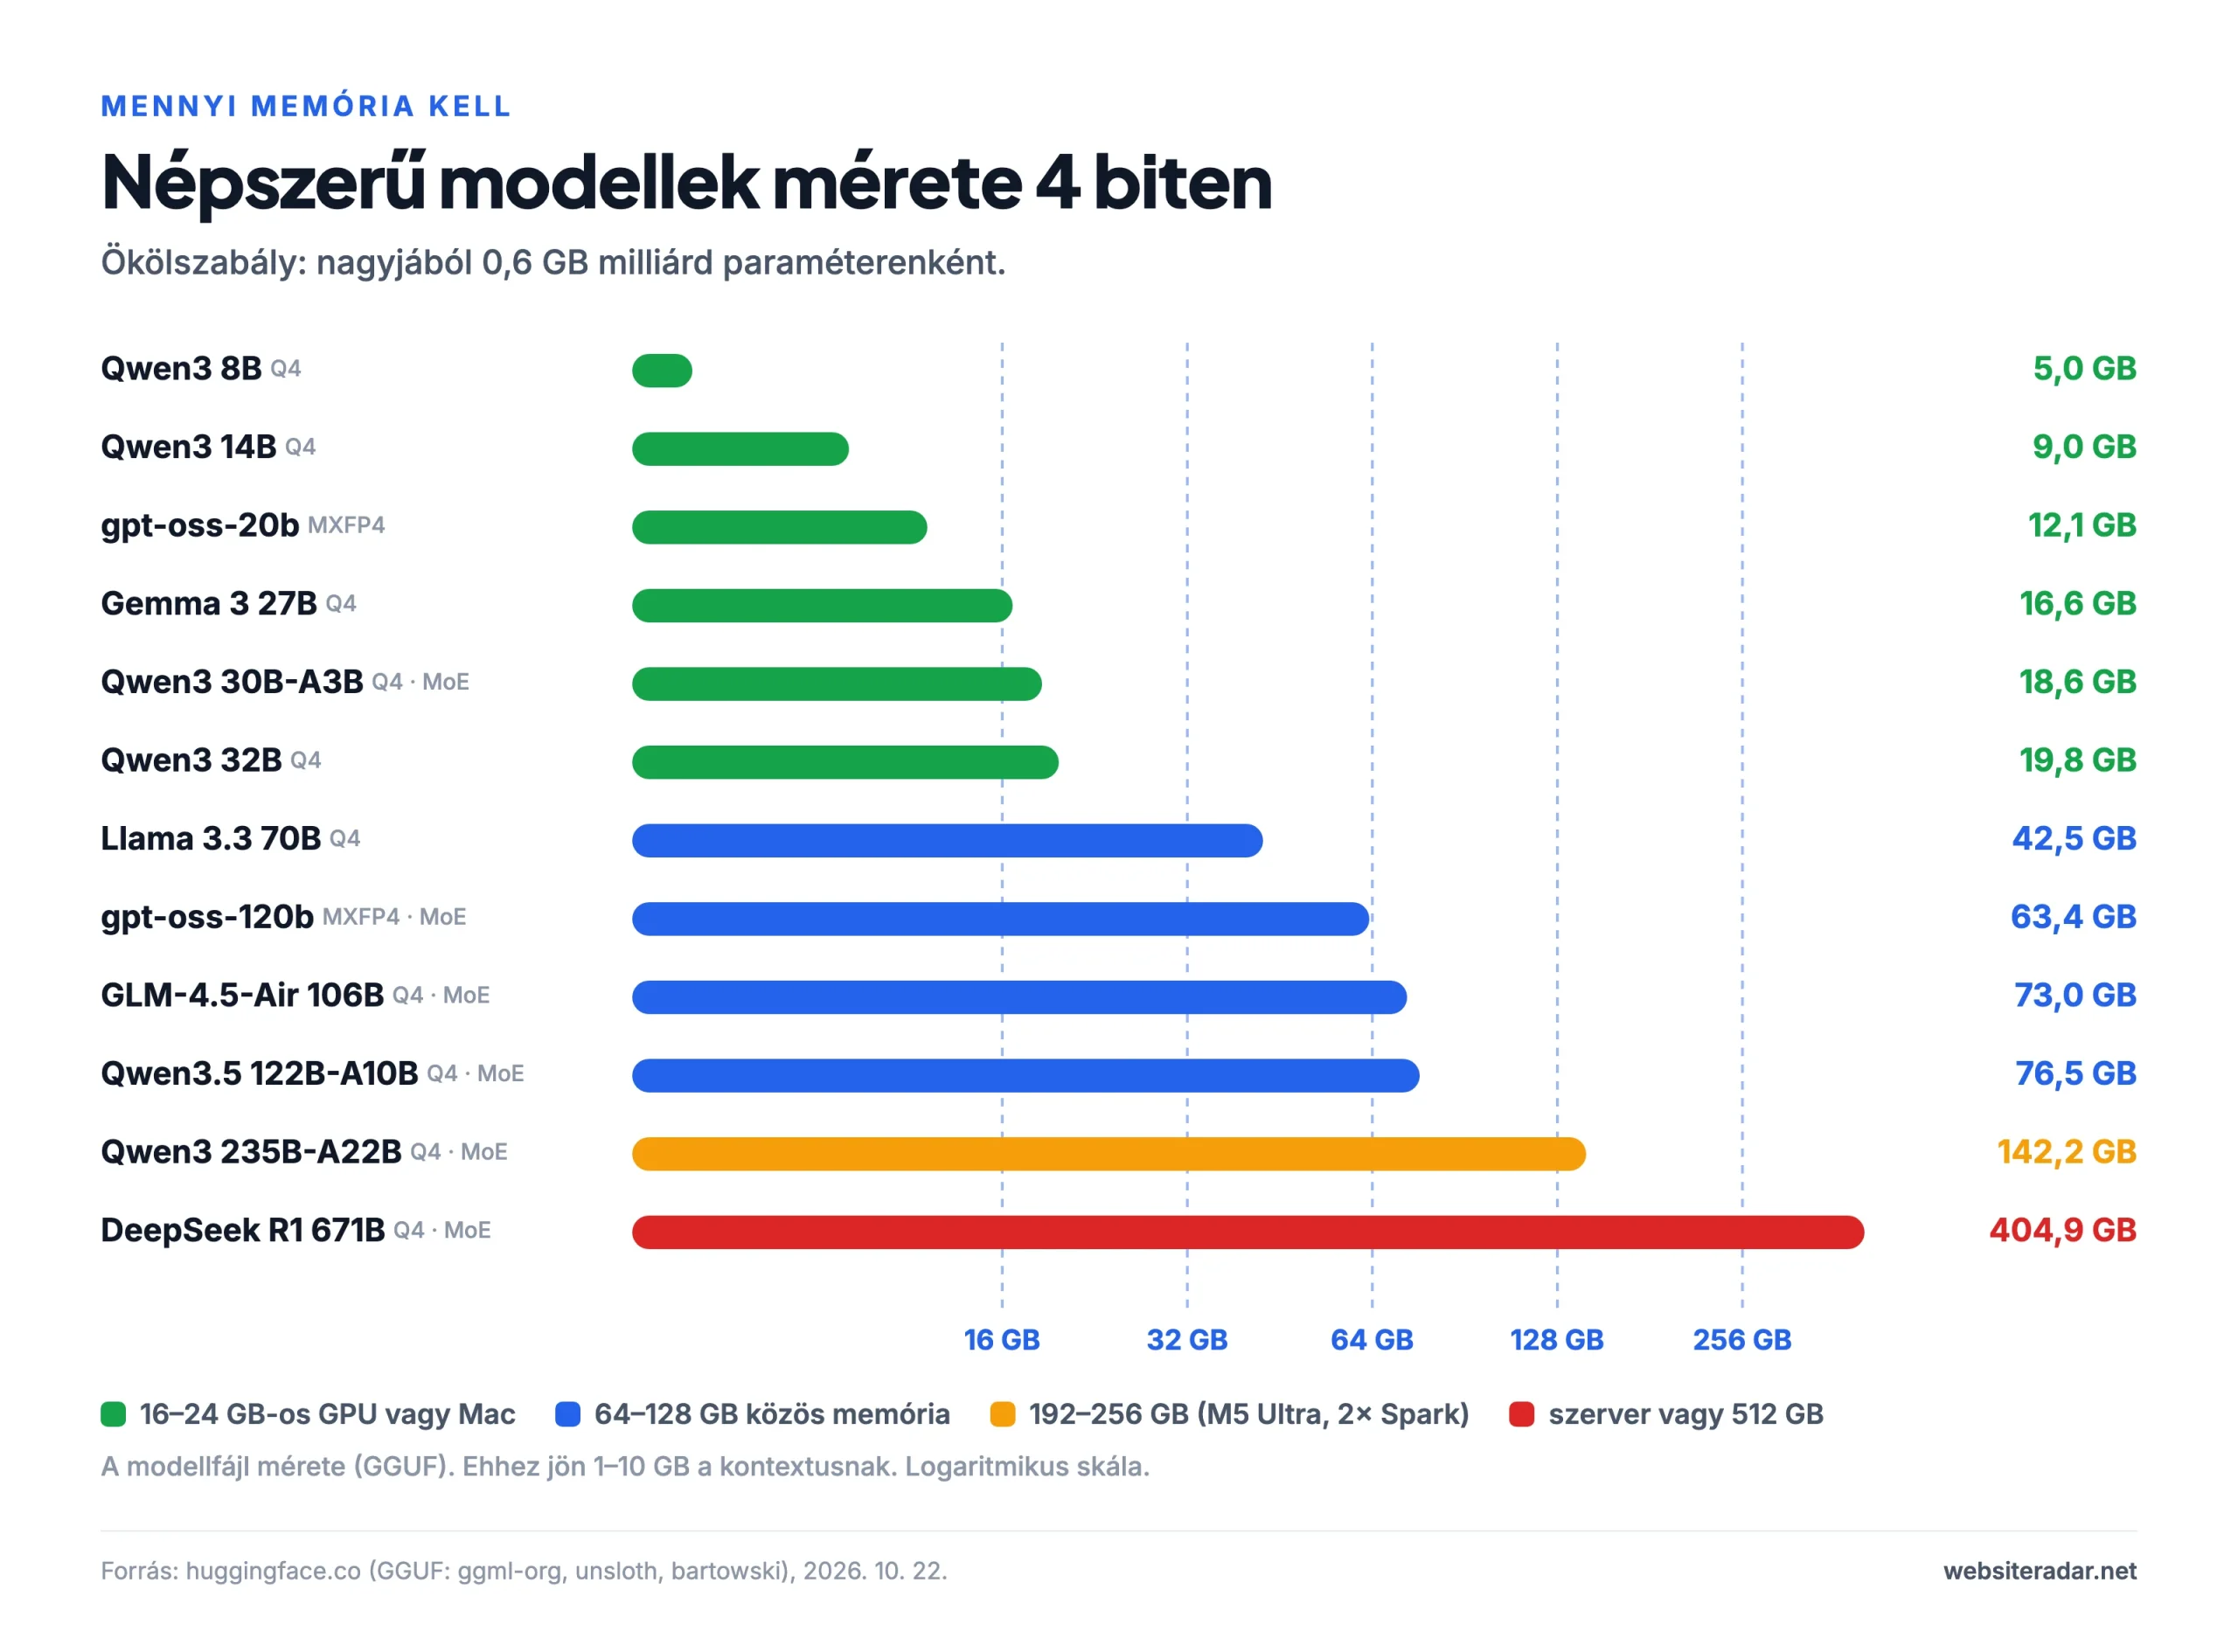
| Modell | Típus | Méret (4 bit) | Hová fér el |
|---|---|---|---|
| Llama 3.1 8B / Qwen3 8B | sűrű | 4,9–5,0 GB | bármibe, aminek 8 GB-ja van |
| Qwen3 14B | sűrű | 9,0 GB | 12–16 GB |
| gpt-oss-20b | MoE | 12,1 GB (MXFP4) | 16 GB |
| Gemma 3 27B | sűrű | 16,6 GB | 24 GB |
| Qwen3 30B-A3B | MoE, 3B aktív | 18,6 GB | 24 GB |
| Qwen3 32B | sűrű | 19,8 GB | 24–32 GB |
| Llama 3.3 70B | sűrű | 42,5 GB | 48 GB vagy több |
| gpt-oss-120b | MoE | 63,4 GB (MXFP4) | 96–128 GB |
| GLM-4.5-Air 106B | MoE | 73,0 GB | 96 GB vagy több |
| Qwen3.5 122B-A10B | MoE | 76,5 GB | 96–128 GB |
| Qwen3 235B-A22B | MoE | 142,2 GB | 192–256 GB |
| DeepSeek R1 671B | MoE | 404,9 GB | 512 GB |
A kontextusnak is kell memória
A modellen felül memória kell a kontextusnak (a KV-gyorsítótárnak, angolul KV cache) is – mindannak, amire a modell „emlékszik” a beszélgetésből vagy a dokumentumból. A Llama 3.3 70B esetében ez 32 000 tokenes kontextusnál nagyjából 10 GB többletet jelent, 128 000 tokennél pedig körülbelül 40 GB-ot. A gpt-oss modellek a csúszóablaknak köszönhetően sokkal takarékosabbak: a gpt-oss-120b-nek még 128 000 tokenhez is legfeljebb körülbelül 9 GB kell. A kontextus növekedésével a kimeneti sebesség is csökken – a gpt-oss-120b egy M5 Maxon rövid kontextussal körülbelül 80 token/s-mal ír, 128 000 tokennél viszont már csak 14-gyel.
Nem minden memória jut a GPU-nak
- A macOS alapértelmezés szerint a RAM nagyjából 75%-át engedi át a GPU-nak (az Apple nem közli a pontos értéket). Egy 64 GB-os Mac így körülbelül 48 GB-ot kínál a modellnek, egy 128 GB-os körülbelül 96 GB-ot. A korlátot a
sudo sysctl iogpu.wired_limit_mb=…paranccsal megemelheted, de újraindítás után visszaáll. - A Windows a Ryzen AI Maxon a BIOS-ban rögzített arányban osztja fel a memóriát – a GPU 128 GB-ból legfeljebb 96 GB-ot kap. Linux alatt ez körülbelül 124 GB-ig mehet.
- Az NVIDIA RTX Spark notebookok Windows alatt alapból nagyjából 50:50 arányban osztják meg a memóriát, kézi beállítással 128 GB-ból legfeljebb 96 GB jut a GPU-nak. A 32 GB-os változat csak 16 GB-ot ad a GPU-nak.
- A DGX Spark Linux alatt dinamikusan osztja ki a memóriát, így a modell a 128 GB nagy részét használhatja.
A kvantálás és a MoE egyszerűen
A kvantálás a modellek tömörítése: paraméterenként 16 bit helyett 8 vagy 4 bitet használsz. 4 biten (Q4, Q4_K_M vagy MXFP4 jelöléssel) a modell az eredeti méretének nagyjából a negyedét foglalja el, a minőség pedig csak kicsit romlik – ez otthoni használatra ésszerű alapbeállítás. A 8 bit (Q8) szinte veszteségmentes, de kétszer akkora.
A szakértőkeverék (mixture of experts, MoE) olyan architektúra, amelyben a modellnek rengeteg paramétere van, de minden szóhoz csak egy kis szeletüket használja. A gpt-oss-120b 117 milliárd paraméteres, de lépésenként csak körülbelül ötmilliárdot aktivál; a Qwen3 30B-A3B mindössze hárommilliárdot. Egy ilyen modellnek sok memória kell, de egy jóval kisebb modell sebességével ír. Ezért a MoE-modellek ideálisak a nagy, de lassabb közös memóriájú gépekhez – DGX Spark, Ryzen AI Max vagy Mac. A sűrű (dense) modellek (Llama 70B, Qwen3 32B) viszont minden szóhoz a teljes modellt beolvassák, és lassú memórián csak vánszorognak.
Memória-sávszélesség: miért ír gyorsabban a Mac, mint a Spark
A kimeneti sebesség elég jól megbecsülhető: a memória-sávszélességet el kell osztani azzal, mennyi adatot kell a modellnek tokenenként beolvasnia. Egy 4 bites, sűrű 70B-s modell (~42 GB) ezért egy 273 GB/s-os DGX Sparkon nem írhat gyorsabban nagyjából 6–7 token/s-nál – a mérések körülbelül 4,4-et mutatnak.
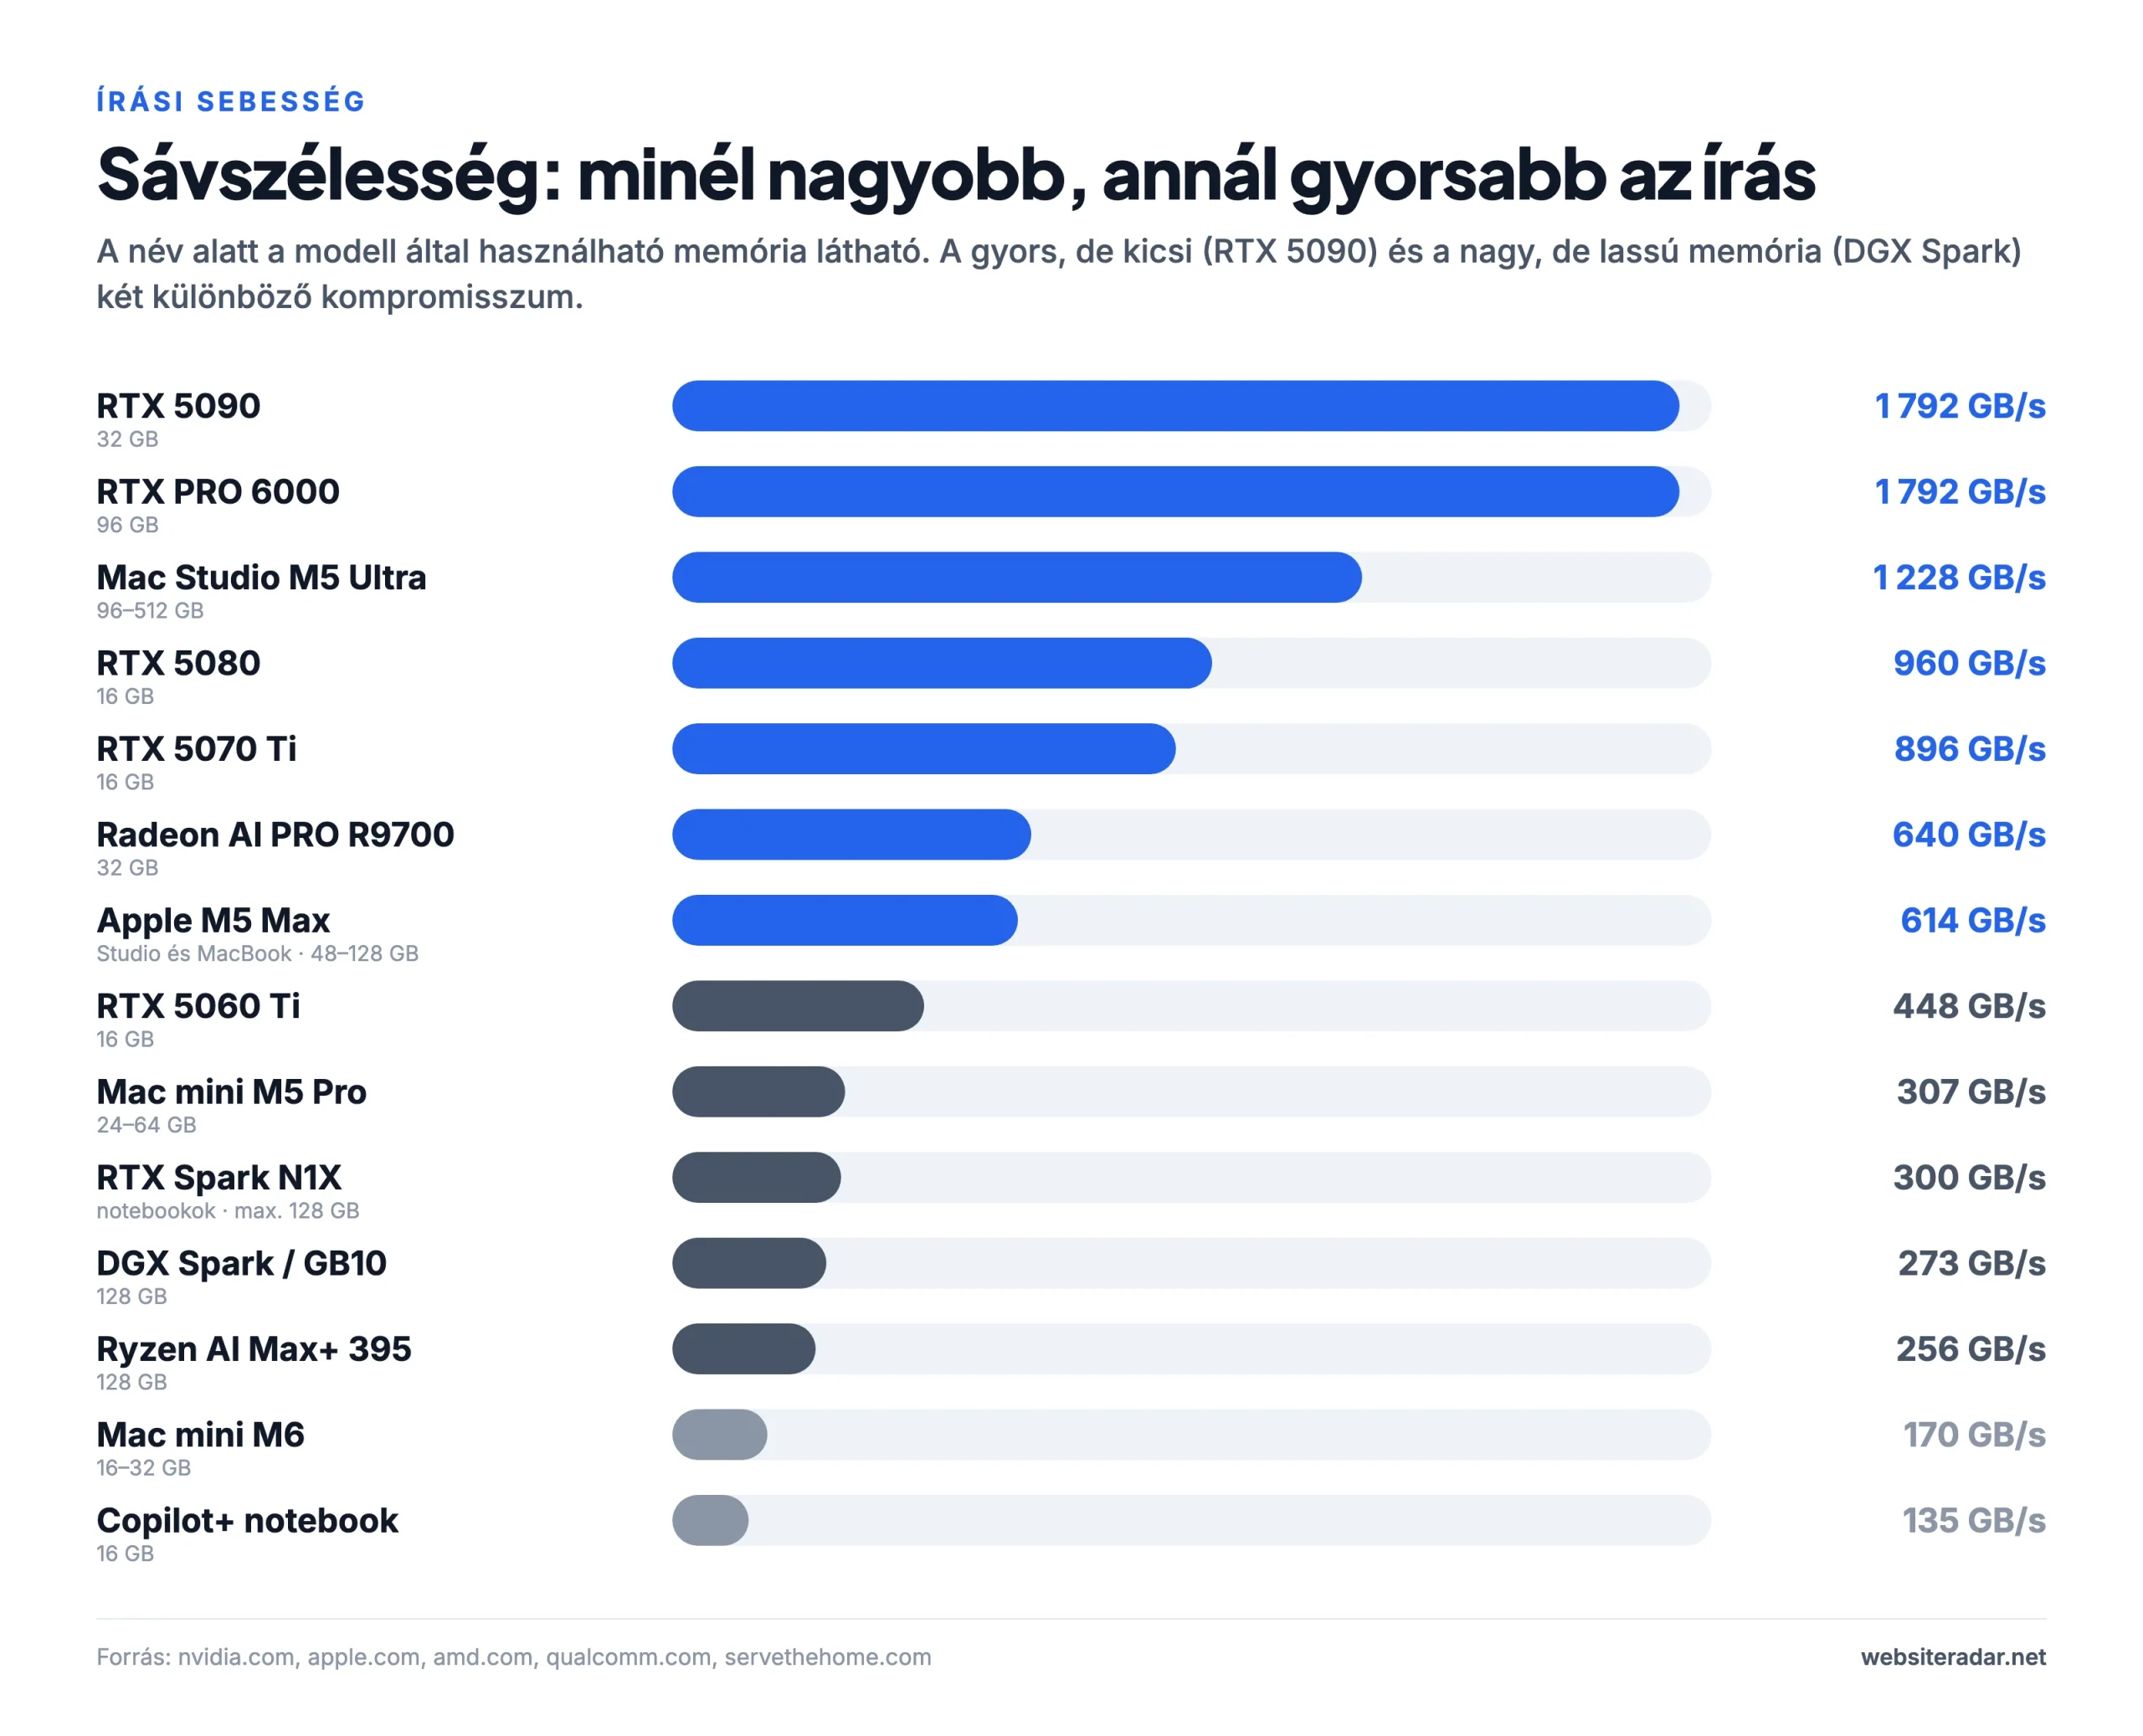
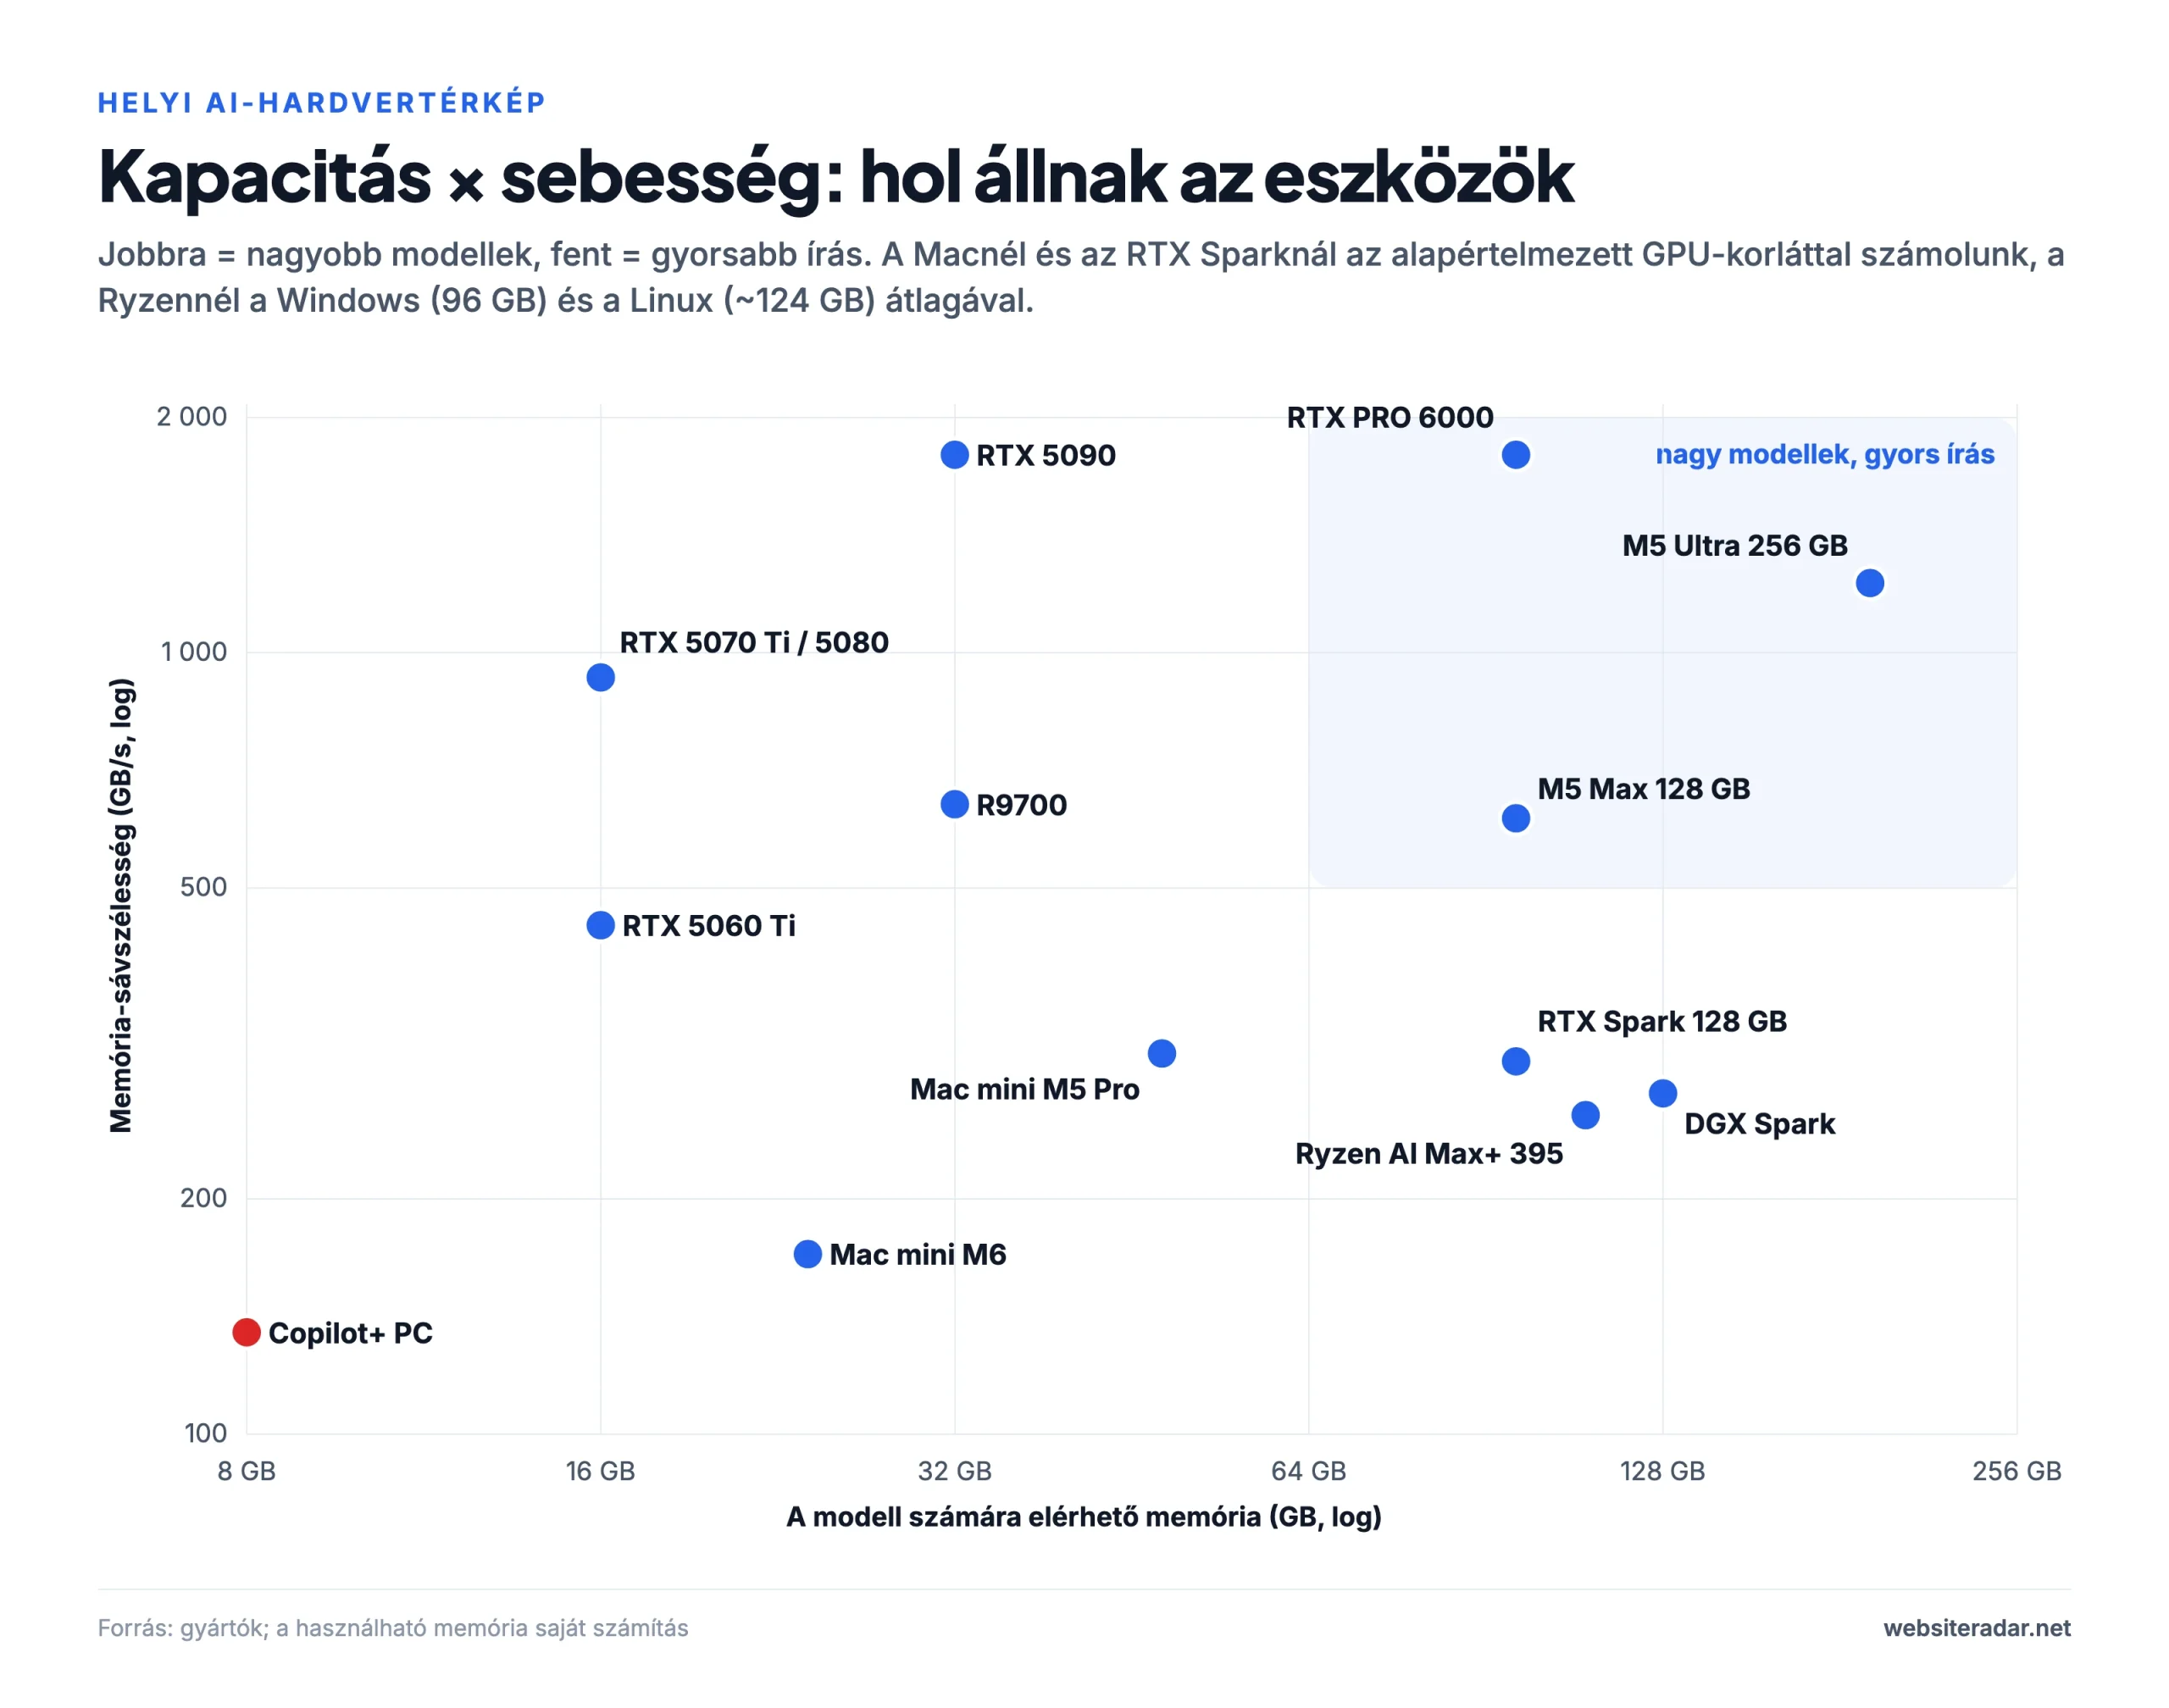
A térképen jól látszik, hogy tökéletes eszköz nincs. Az NVIDIA videokártyáinak a leggyorsabb a memóriájuk, de kicsi a kapacitásuk. A DGX Spark, a Ryzen AI Max és az RTX Spark bőven kínál kapacitást, de lassabb memóriával. Az M5 Maxos – és főleg az M5 Ultrás – Mac Studio mindkettőt ötvözi, cserébe nincs CUDA, és a promptot lassabban olvassa be, mint az NVIDIA.
Ugyanaz a modell, különböző hardver
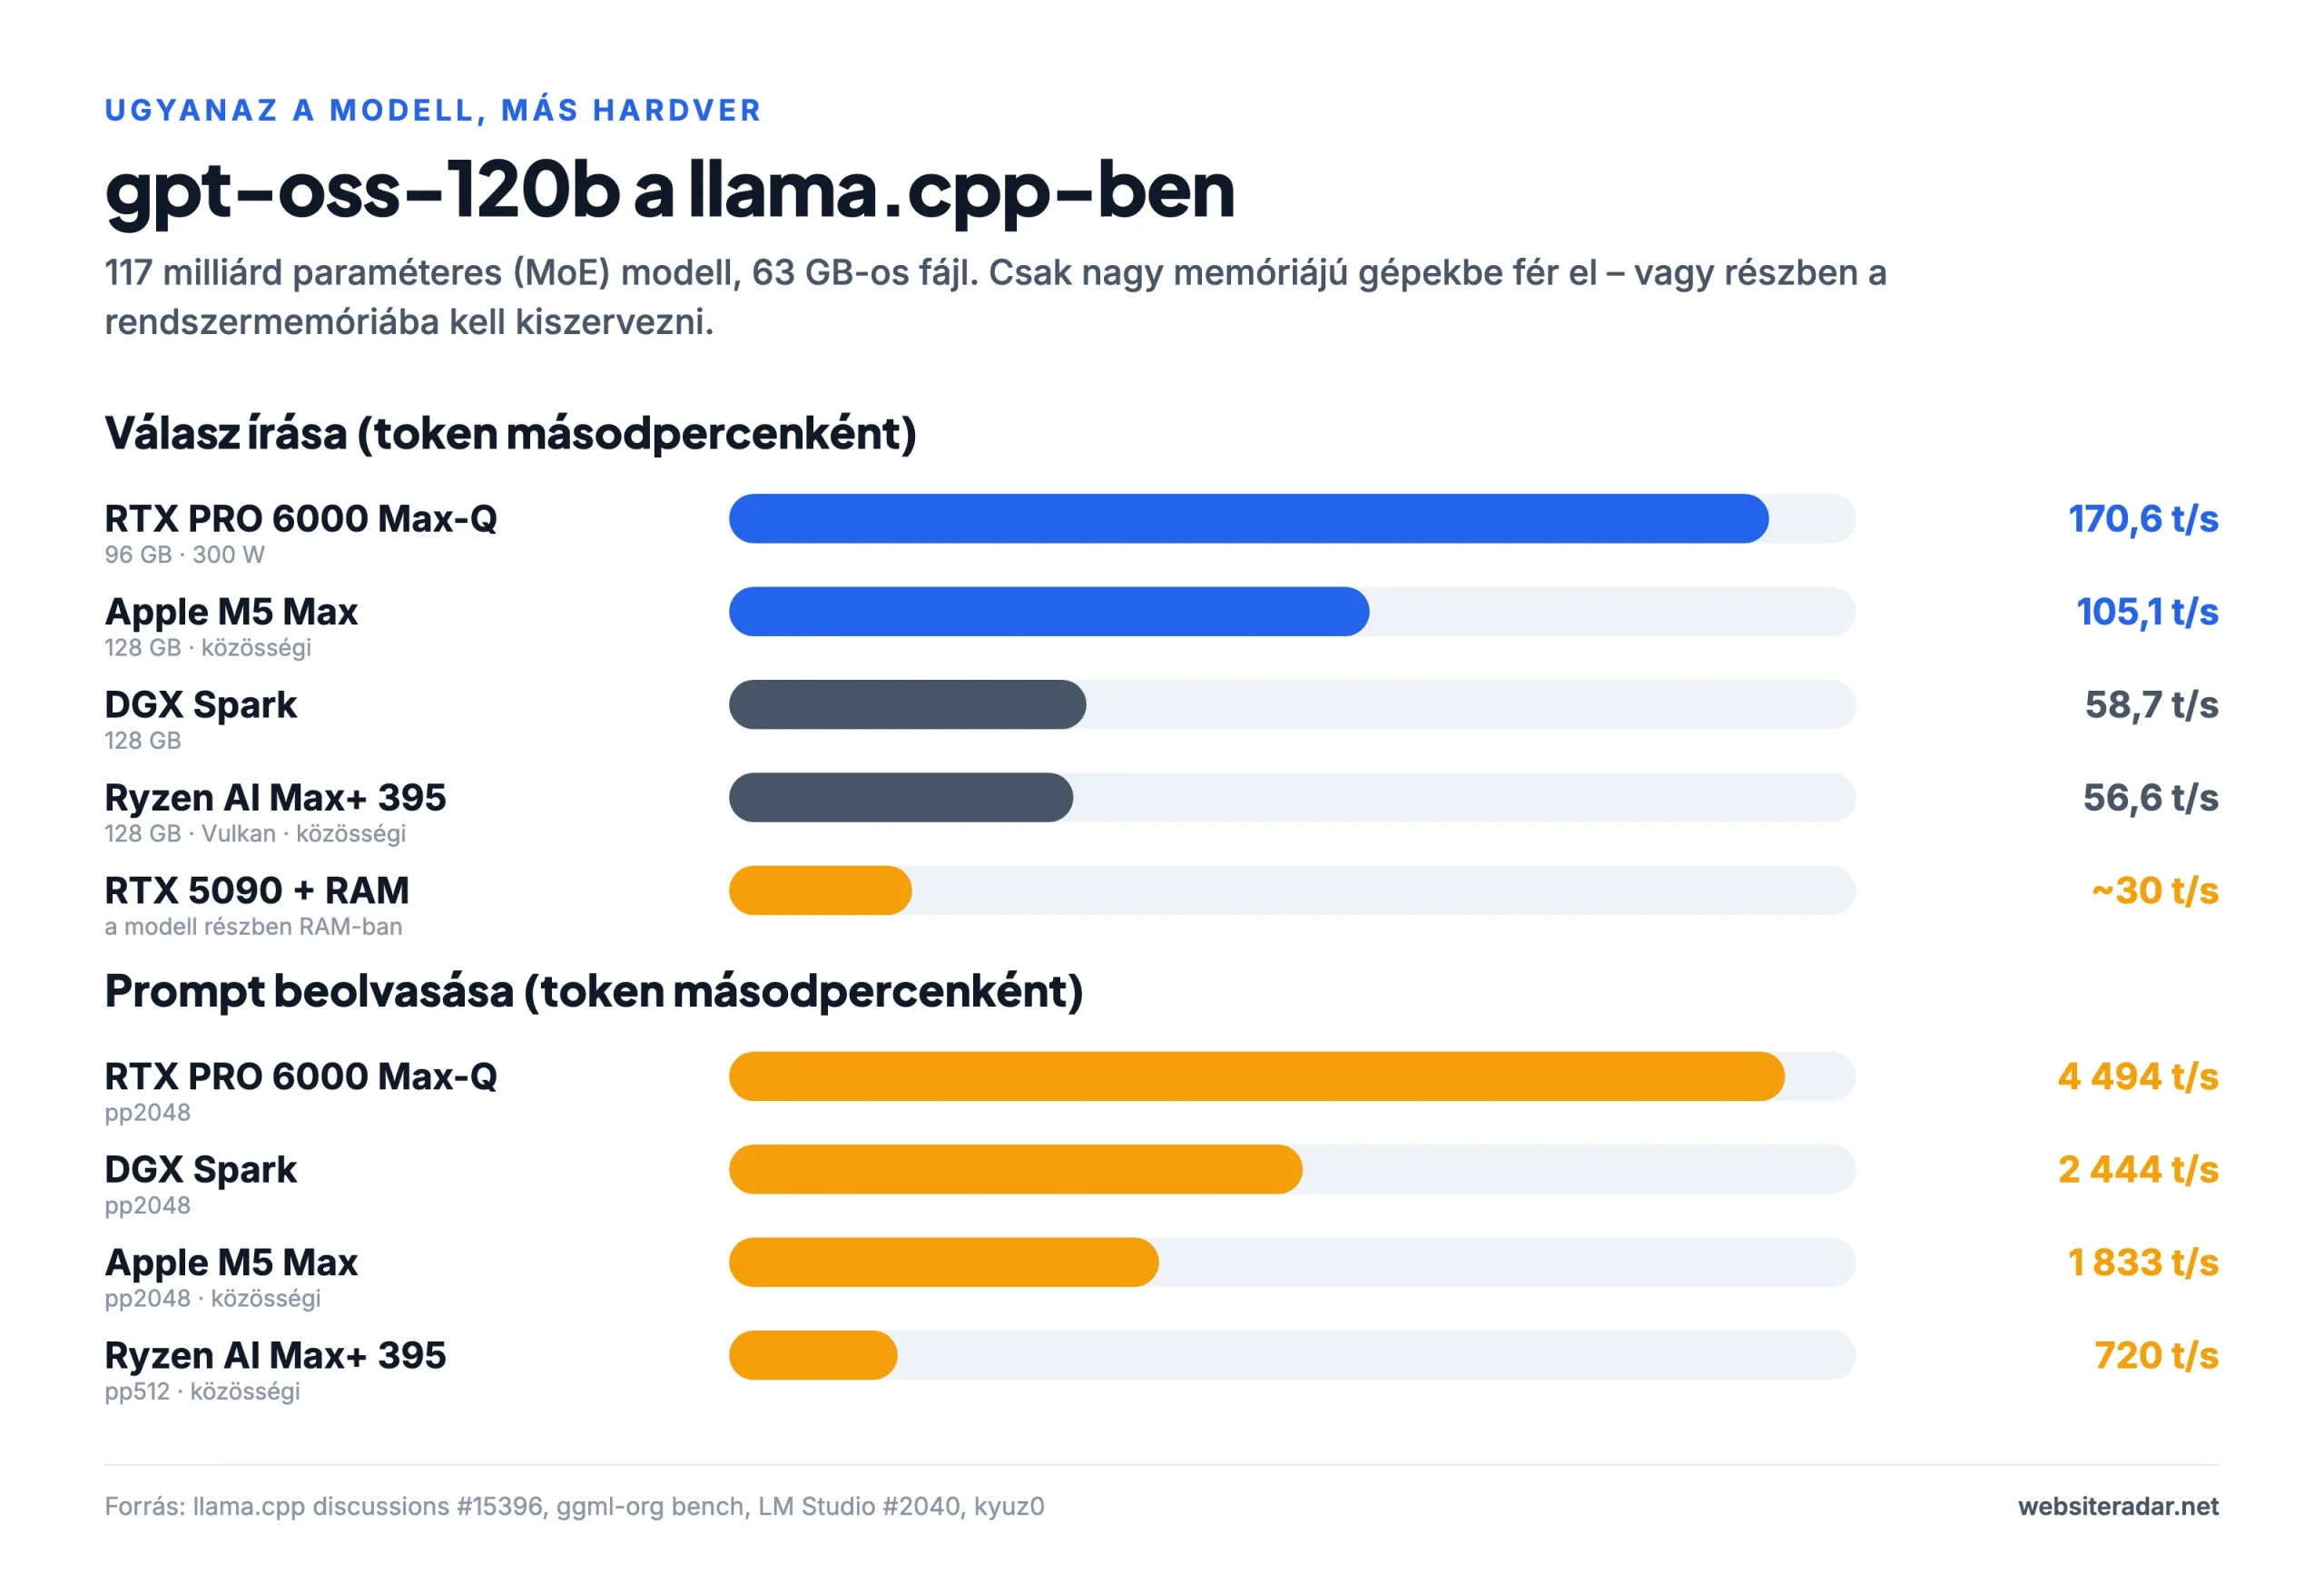
A legtisztességesebb összehasonlítás ugyanazt a modellt ugyanabban a programban futtatja. Az OpenAI gpt-oss-120b modelljét (63 GB) és a llama.cpp-vel – a helyi modellek futtatására legelterjedtebb programmal – készült méréseket választottuk.
Az összes eszköz összehasonlítva
| Eszköz | Memória AI-ra | Sávszélesség | gpt-oss-120b, kimenet |
|---|---|---|---|
| Mac Studio M5 Max | ~96 GB a 128 GB-ból | 614 GB/s | 105 t/s¹ |
| NVIDIA DGX Spark | 128 GB | 273 GB/s | 58,7 t/s |
| RTX Spark notebookok | legfeljebb 96 GB a 128 GB-ból | legfeljebb 300 GB/s | – |
| Ryzen AI Max+ 395 | 96 GB (Windows) / ~124 GB (Linux) | 256 GB/s | 56,6 t/s |
| Mac Studio M5 Ultra | ~192 GB a 256 GB-ból | 1228 GB/s | – |
| Mac mini M5 Pro | ~48 GB a 64 GB-ból | 307 GB/s | nem fér el |
| Mac mini M6 | ~24 GB a 32 GB-ból | 170 GB/s | nem fér el |
| MacBook Pro M5 Max | ~96 GB a 128 GB-ból | 614 GB/s | 105 t/s¹ |
| RTX 5090 | 32 GB | 1792 GB/s | ~30 t/s² |
| RTX 5060 Ti 16 GB | 16 GB | 448 GB/s | nem fér el |
| RTX 5070 Ti / 5080 | 16 GB | 896 / 960 GB/s | nem fér el |
| RTX PRO 6000 Max-Q | 96 GB | 1792 GB/s | 170,6 t/s |
| GB10 az ASUS-tól, MSI-tól, Lenovótól… | 128 GB | 273 GB/s | ~ mint a Spark |
| Radeon AI PRO R9700 | 32 GB | ~640 GB/s | nem fér el |
| Copilot+ notebookok | ~8 GB a 16 GB-ból | ~135 GB/s | nem fér el |
¹ Közösségi mérés egy 128 GB-os MacBook Pro M5 Maxon, llama.cpp. ² A modell egy része a rendszermemóriába kiszervezve.
1. Mac Studio M5 Max – a leggyorsabb kimenet a pénzért
Az M5 Max chipes Mac Studio ma a legésszerűbb választás mindenkinek, aki a lehető leggyorsabb helyi csevegést vagy ügynököt szeretné, és nincs szüksége CUDA-ra. A 614 GB/s-os memória-sávszélességnek köszönhetően a 128 GB-os változat 100 token/s felett futtatja a gpt-oss-120b-t – majdnem kétszer olyan gyorsan, mint egy DGX Spark. Az egyes GPU-magokba épített új neurális gyorsítók a promptbeolvasást is felgyorsították, de csak naprakész szoftverekben (lásd a szoftverekről szóló részt).
- Memória: 36, 48, 64 vagy 128 GB · sávszélesség 460 GB/s (36 GB) / 614 GB/s
- Fogyasztás: 7 W üresjáratban, max. 200 W
- Csatlakozók: 4× Thunderbolt 5, 10GbE
- Figyelem: a 36 GB-os változatban gyengébb, 32 magos GPU van, és a modellnek csak körülbelül 27 GB marad. 48 GB-tól felfelé a teljes chipet kapod.
- Amerikai listaár: 2499 dollártól (alapkonfiguráció, 2026. augusztus)
Kinek való: csevegés és ügynökök MoE-modellekkel, csendes otthoni AI-szerver, illetve azoknak, akik videót is vágnak. Kinek nem: akinek CUDA, vLLM vagy tanítás kell.
2. NVIDIA DGX Spark – fejlesztői munkaállomás, nem csevegőgép
GB10 chip 128 GB közös memóriával és az NVIDIA teljes szoftverkészletével (CUDA, vLLM, TensorRT-LLM) egy 15 × 15 cm-es dobozban. Bármely más kis gépnél gyorsabban olvassa be a promptot – a gpt-oss-120b-n 2444 token/s-mal –, de 273 GB/s-os sávszélességgel lassabban ír, mint egy Mac: 58,7 token/s-mal, a sűrű Llama 70B-n pedig csak 4,4-del. Modellfuttatás közben 60–90 W-ot fogyaszt, és két egység QSFP-kábellel összekapcsolható, nagyjából 400 milliárd paraméteres modellekig.
- Memória: 128 GB LPDDR5x · sávszélesség 273 GB/s
- GPU: Blackwell, 6144 CUDA-mag · AI-teljesítmény 1 PFLOP FP4 (ritkítással; a gyakorlatban nagyjából a fele)
- OS: DGX OS (Ubuntu Arm architektúrán)
- Amerikai listaár: 3999 dollár a megjelenéskor (2025. október), 2026 februárjától 4699 dollár; a ServeTheHome 2026 októberében arról számolt be, hogy az ár egy „6950 dollár körüli” sávba lépett
Kinek való: CUDA-fejlesztés, kódoló ügynökök nagy kontextussal, finomhangolás 70B-ig. Kinek nem: gyors csevegés sűrű 70B-s modellekkel, Windows és játék, kezdők.
3. NVIDIA RTX Spark notebookok – 128 GB a hátizsákban
Az N1X chip Windows-notebookokhoz igazított GB10, gyorsabb memóriával (legfeljebb 300 GB/s) és 45–80 W-os fogyasztási kerettel. A The Register tesztjében egy notebook 67,6 token/s-mal futtatta a Qwen3.6 35B-A3B-t – gyorsabban, mint az asztali DGX Spark. A bökkenő a Windows: a GPU a memóriának csak egy rögzített részét kapja – 32 GB-ból legfeljebb 16 GB-ot, 64 GB-ból 48 GB-ot, 128 GB-ból pedig 96 GB-ot.
- Memória: 32, 64 vagy 128 GB · sávszélesség legfeljebb 300 GB/s
- GPU: Blackwell, 6144 mag (teljesítményben nagyjából egy notebookos RTX 5070)
- OS: Windows 11 on Arm, CUDA a 13.4-es verziótól
- Figyelem: az első példányok (Surface, HP) a tesztekben több órányi teljes terhelés után lefagytak; a Linux hivatalosan nem támogatott
- Amerikai ár: 2599 dollártól (Surface Laptop Ultra 24 GB-tal) 5899,99 dollárig (Surface 128 GB-tal), 2026. október
Kinek való: nagy modellek Windows-notebookon, kódoló ügynökök, kreatív munka. Kinek nem: a 32 GB-os változat, hosszú tanítások, csak x86-ra elérhető szoftverek.
4. Ryzen AI Max+ 395 – a legolcsóbb 128 GB
A 16 magos Ryzennel és Radeon 8060S grafikával szerelt mini PC-kben 128 GB közös memória van. A kimeneti sebesség a DGX Sparkéhoz hasonló (gpt-oss-120b 56,6 token/s-mal) nagyjából feleannyi pénzért, és Windowst, Linuxot – meg játékokat – is futtatnak. A gyenge pont a promptbeolvasás: kétszer-háromszor lassabb, mint a Sparkon, és hosszú kontextusnál tovább esik – a Vulkan-meghajtóval 146, ROCm-mel 371 token/s-ra.
- Memória: 128 GB LPDDR5x · sávszélesség 256 GB/s (mérve ~215)
- A GPU-nak: 96 GB Windows alatt, ~124 GB Linux alatt
- Szoftver: Vulkan vagy ROCm (a gfx1151 2026 óta hivatalosan támogatott)
- A HP Z2 Mini G1a drágább, de ECC memóriás, hároméves garanciás, minősített munkaállomás
- Amerikai árpélda: a 128 GB-os Framework Desktop 1999 dollárért jelent meg, a 2026-os memóriaár-emelés után 2459 dollárba kerül
Kinek való: a legtöbb memória a pénzért, nagy MoE-modellek, csevegés és összefoglalók. Kinek nem: ügynökök hatalmas kontextussal, CUDA, illetve a 32–64 GB-os ROG Flow Z13 tablet nagy modellekhez.
5. Mac Studio M5 Ultra – a memória királya
Akár 512 GB memória és 1,2 TB/s sávszélesség. A MacStories tesztjében az M5 Ultra négyszer gyorsabban olvasta be a promptot, mint az előző M3 Ultra, és 50%-kal gyorsabban írt. A 256 GB-os változatba még a Qwen3 235B is belefér. Több egység összekapcsolható Thunderbolt 5-ön és RDMA-n keresztül: az Apple szerint négy M5 Ultra 36,7 token/s-mal futtat egy 816 milliárd paraméteres modellt.
- Memória: 96, 256 vagy 512 GB (az 512 GB-os október végén érkezik) · sávszélesség 1228 GB/s
- Fogyasztás: 9 W üresjáratban, modellfuttatás közben 300 W körül
- Csatlakozók: 6× Thunderbolt 5
- Figyelem: a memória utólag nem bővíthető; szeptemberben a várakozási idő akár 18 hét is volt
- Amerikai listaár: 5499 dollártól (2026. augusztus); a 96 helyett 256 GB 4000 dollár felár
Kinek való: 100–250B-s modellek, ügynökök hosszú kontextussal, kis csapatok. Kinek nem: legfeljebb 30B-s modellek, CUDA, szűk költségvetés.
6. Mac mini M5 Pro – az ésszerű belépő
A legolcsóbb Mac, amely valóban hasznos modelleket futtat. 307 GB/s sávszélesség, legfeljebb 64 GB memória és Thunderbolt 5. A neurális gyorsítóknak köszönhetően nagyjából háromszor gyorsabban olvassa be a promptot, mint az előző M4 Pro. A 64 GB-os változat kényelmesen futtat 32 milliárd paraméterig terjedő modelleket; a sűrű Llama 70B belefér, de csak körülbelül 7 token/s-ra képes, a gpt-oss-120b pedig nem fér bele.
- Memória: 24, 48 vagy 64 GB · sávszélesség 307 GB/s
- Fogyasztás: 6 W üresjáratban, max. 145 W · üresjáratban gyakorlatilag hangtalan
- Amerikai listaár: 1699 dollártól (alapkonfiguráció, 2026. augusztus)
Kinek való: 20–35B-s modellek, csendes otthoni AI-szerver. Kinek nem: gpt-oss-120b, sűrű 70B, a 24 GB-os változat.
7. Mac mini M6 – olcsó, de nem 16 GB-tal
A legolcsóbb Mac neurális gyorsítókkal. 32 GB-nál és 170 GB/s-nál megáll – a 16 GB-os változat sávszélessége csak 153 GB/s, és a modellnek körülbelül 12 GB-ot hagy. Az előző, M4-es Mac minihez képest 4,5-szer gyorsabban olvassa be a promptot és 50%-kal gyorsabban ír, gyakorlatilag ugyanazon az áron, ezért a régi modellt akciósan se vedd meg.
- Memória: 16, 24 vagy 32 GB (maximum) · sávszélesség 153 / 170 GB/s
- Fogyasztás: 4 W üresjáratban, max. 70 W
- Figyelem: csak Thunderbolt 4, így több egység nem kapcsolható össze
- Amerikai listaár: 899 dollártól (alapkonfiguráció, 2026. augusztus)
Kinek való: 7–14B-s modellek, gpt-oss-20b, Qwen3 30B-A3B. Kinek nem: a 16 GB-os változat, 70B-s és nagyobb modellek.
8. MacBook Pro M5 Max – AI útközben
Ugyanaz a chip, mint a Mac Studióban, így ugyanaz a sebesség is: ez a leggyorsabb notebook helyi modellekhez. A közepes méretű Qwen3.6 35B-A3B-vel 90 token/s felett generál. A 14 hüvelykes változat azonban tartós terhelés alatt visszafogja magát (96-ról 42 W-ra), a töltés pedig 97 W-ban maximált. Egy azonos chipes, 128 GB-os Mac Studio jóval olcsóbb.
- Memória: 36, 48, 64 vagy 128 GB · sávszélesség 460 / 614 GB/s
- Akkumulátor: 72,4 Wh (14″) / 100 Wh (16″)
- Amerikai listaár: 3599 dollártól (14″) és 3899 dollártól (16″), 2026. március; a 64 helyett 128 GB 1000 dollár felár
Kinek való: akinek útközben is nagy modellek kellenek, ideálisan a 16 hüvelykes, 64–128 GB-os változat. Kinek nem: a 36 GB-os változat, éjjel-nappali terhelés, aki asztalnál dolgozik.
9. RTX 5090 – a leggyorsabb, de csak 32 GB
1792 GB/s sávszélesség: a gpt-oss-20b közel 300 token/s-mal ír, a kártya pedig nagyjából kétszer olyan gyorsan olvassa be a hosszú promptot, mint egy M5 Ultrás Mac Studio. A 32 GB 4 biten nagyjából 32 milliárd paraméteres modelleket fogad be, még hosszú kontextussal is; egy 70 milliárd paraméteres modell nem fér bele. A nagy MoE-modellek részben kiszervezhetők a rendszermemóriába – a gpt-oss-120b így körülbelül 30 token/s-mal fut.
- Memória: 32 GB GDDR7 · sávszélesség 1792 GB/s
- Fogyasztás: 575 W, 1000 W-os táp ajánlott
- Amerikai listaár: 1999 dollár a megjelenéskor (2025. január); a bolti árak 2026-ban a memóriahiány miatt jóval magasabbak
Kinek való: kódoló ügynökök és RAG legfeljebb 32B-s modellekkel, CUDA-fejlesztés, játék. Kinek nem: 70B-s és nagyobb modellek, csendes, alacsony fogyasztású szerver.
10. RTX 5060 Ti 16 GB – a legolcsóbb értelmes belépő
A legolcsóbb új, 16 GB-os videokártya. A gpt-oss-20b-t körülbelül 92, a Qwen3 8B-t 69, a Qwen3 14B-t 41 token/s-mal futtatja – gyorsabban, mint ahogy olvasni tudsz. A memória-sávszélessége viszont fele az RTX 5070 Ti-énak, így nagyjából feleakkora tempóban ír, és a 30 milliárd paraméter körüli modellek nem férnek bele a 16 GB-ba.
- Memória: 16 GB GDDR7 · sávszélesség 448 GB/s
- Fogyasztás: 180 W, egy 600 W-os táp elég
- Amerikai listaár: 429 dollár a 16 GB-os változatért a megjelenéskor (2025. április)
Kinek való: első komoly kísérletek, 8–20B-s modellek, költségkímélő AI PC. Kinek nem: 27B-s és nagyobb modellek.
11. RTX 5070 Ti vs. RTX 5080 – AI-ra szinte egyformák
Mindkét kártyán 16 GB memória és szinte ugyanakkora sávszélesség (896 vs. 960 GB/s) van, így közel azonos sebességgel írnak: a szabványos llama.cpp-tesztben 182,4 vs. 184,7 token/s-mal, a Qwen3 14B-n 74 vs. 81 token/s-mal. Pontosan ugyanazok a modellek férnek beléjük. Az 5080 főleg játékokban gyorsabb – és a megjelenési ára 250 dollárral magasabb volt (999 vs. 749 dollár).
Tanácsunk: AI-ra vedd az RTX 5070 Ti-t, a megspórolt pénzt pedig fordítsd nagyobb SSD-re vagy több RAM-ra. RTX 5080-at csak akkor vegyél, ha főleg játszani fogsz rajta.
12. RTX PRO 6000 – 96 GB egyetlen kártyán
Az egyetlen kártya, amelybe teljes egészében belefér a Llama 3.3 70B (32 token/s), a gpt-oss-120b (170,6 token/s a Max-Q változatban) és a Qwen3.5 122B (körülbelül 98 token/s). A CUDA-nak és a vLLM-nek köszönhetően egyszerre több felhasználót is kiszolgálhat. Önálló kártyaként és előre összeszerelt munkaállomásban is megvásárolható.
- Memória: 96 GB GDDR7, ECC-vel · sávszélesség 1792 GB/s
- Fogyasztás: 300 W (Max-Q); a teljes, 600 W-os változat körülbelül 13%-kal gyorsabban ír
- Amerikai listaár: 8565 dollár a megjelenéskor; az NVIDIA később 13 250 dollárra emelte
Kinek való: cégek és csapatok, amelyek házon belül akarnak nagy modelleket futtatni vagy tanítani. Kinek nem: magánszemélyek és hobbisták.
13. DGX Spark az ASUS-tól, MSI-tól, Lenovótól, Delltől és Gigabyte-tól – melyiket válaszd
Öt másik gyártó is ugyanazzal a GB10 chippel árul gépet, mint amilyen a DGX Sparkban van. Az AI-teljesítmény csak néhány százalékban tér el; a különbségek a tárhelyben, a tápegységben, a hűtésben és a támogatásban vannak – no meg az árban.
| Modell | Tárhely | Tápegység | Kiemelkedő jellemző |
|---|---|---|---|
| NVIDIA / PNY DGX Spark | 4 TB, öntitkosító | 240 W | az eredeti |
| GIGABYTE AI TOP ATOM | 4 TB PCIe 5.0 | 240 W | leggyorsabb SSD |
| ASUS Ascent GX10 | 1 TB PCIe 4.0 / 4 TB PCIe 5.0 | 240 W | elöl elhelyezett bekapcsológomb |
| Lenovo ThinkStation PGX | 1 / 2 / 4 TB, öntitkosító | 240 W | egyéves helyszíni szerviz |
| Dell Pro Max with GB10 | PCIe 4.0 (a 2 TB-os QLC) | 280 W | erősebb táp, legforróbb SSD |
| MSI EdgeXpert | 4 TB | – | új, még nincs független teszt |
Tanácsunk: ésszerű pénzért a legjobb felszereltséget a Gigabyte AI TOP ATOM adja 4 TB gyors tárhellyel; a legolcsóbb bevált kiindulópont az 1 TB-os ASUS Ascent GX10, amely az USA-ban nagyjából 3000 dollárért jelent meg. Ha két egységet akarsz összekapcsolni, QSFP-kábelre lesz szükséged. 2026. október 23. óta újdonság: a GB10 64 GB-os változata, amelyet csak a partnermárkák árulnak, 4999 dollártól.
14. Radeon AI PRO R9700 – 32 GB az RTX 5090 árának töredékéért
A legolcsóbb új kártya 32 GB-tal. Ugyanabban a Vulkan-tesztben körülbelül 40%-kal lassabban ír, mint az RTX 5090, de ugyanazok a modellek férnek bele – nagyjából 30 milliárd paraméterig, akár hosszabb kontextussal is. A gpt-oss-20b és a Qwen3 30B-A3B 150 token/s felett fut rajta. Óvatosan a marketinggel: az „akár ötször gyorsabb, mint az RTX 5080” állítás csak olyan modellre igaz, amely nem fér bele 16 GB-ba.
- Memória: 32 GB GDDR6 · sávszélesség ~640 GB/s · fogyasztás 300 W
- Szoftver: Vulkan (általában gyorsabb kimenet) vagy ROCm (gyorsabb promptbeolvasás); CUDA nincs
- Amerikai listaár: 1299 dollár (2025. október)
Kinek való: 27–32B-s modellek hosszú kontextussal, több kártya egy PC-ben. Kinek nem: csak CUDA-val működő eszközök, maximális sebesség.
15. „AI PC-k” és Copilot+ notebookok – egy mítosz
A Copilot+ a Microsoft tanúsítványa a Windows-funkciókhoz – kameraeffektusok, élő feliratozás, Recall vagy a beépített kis Phi Silica modell. A nagy nyelvi modellek futtatásának képességéről semmit nem árul el. Sem az Ollama, sem az LM Studio nem használja a neurális feldolgozóegységet (NPU-t), a llama.cpp pedig csak kísérleti jelleggel; az NPU-t csak gyártói eszközök használják, például a Microsoft Foundry Local vagy az AMD Lemonade, kiválasztott modellekkel.
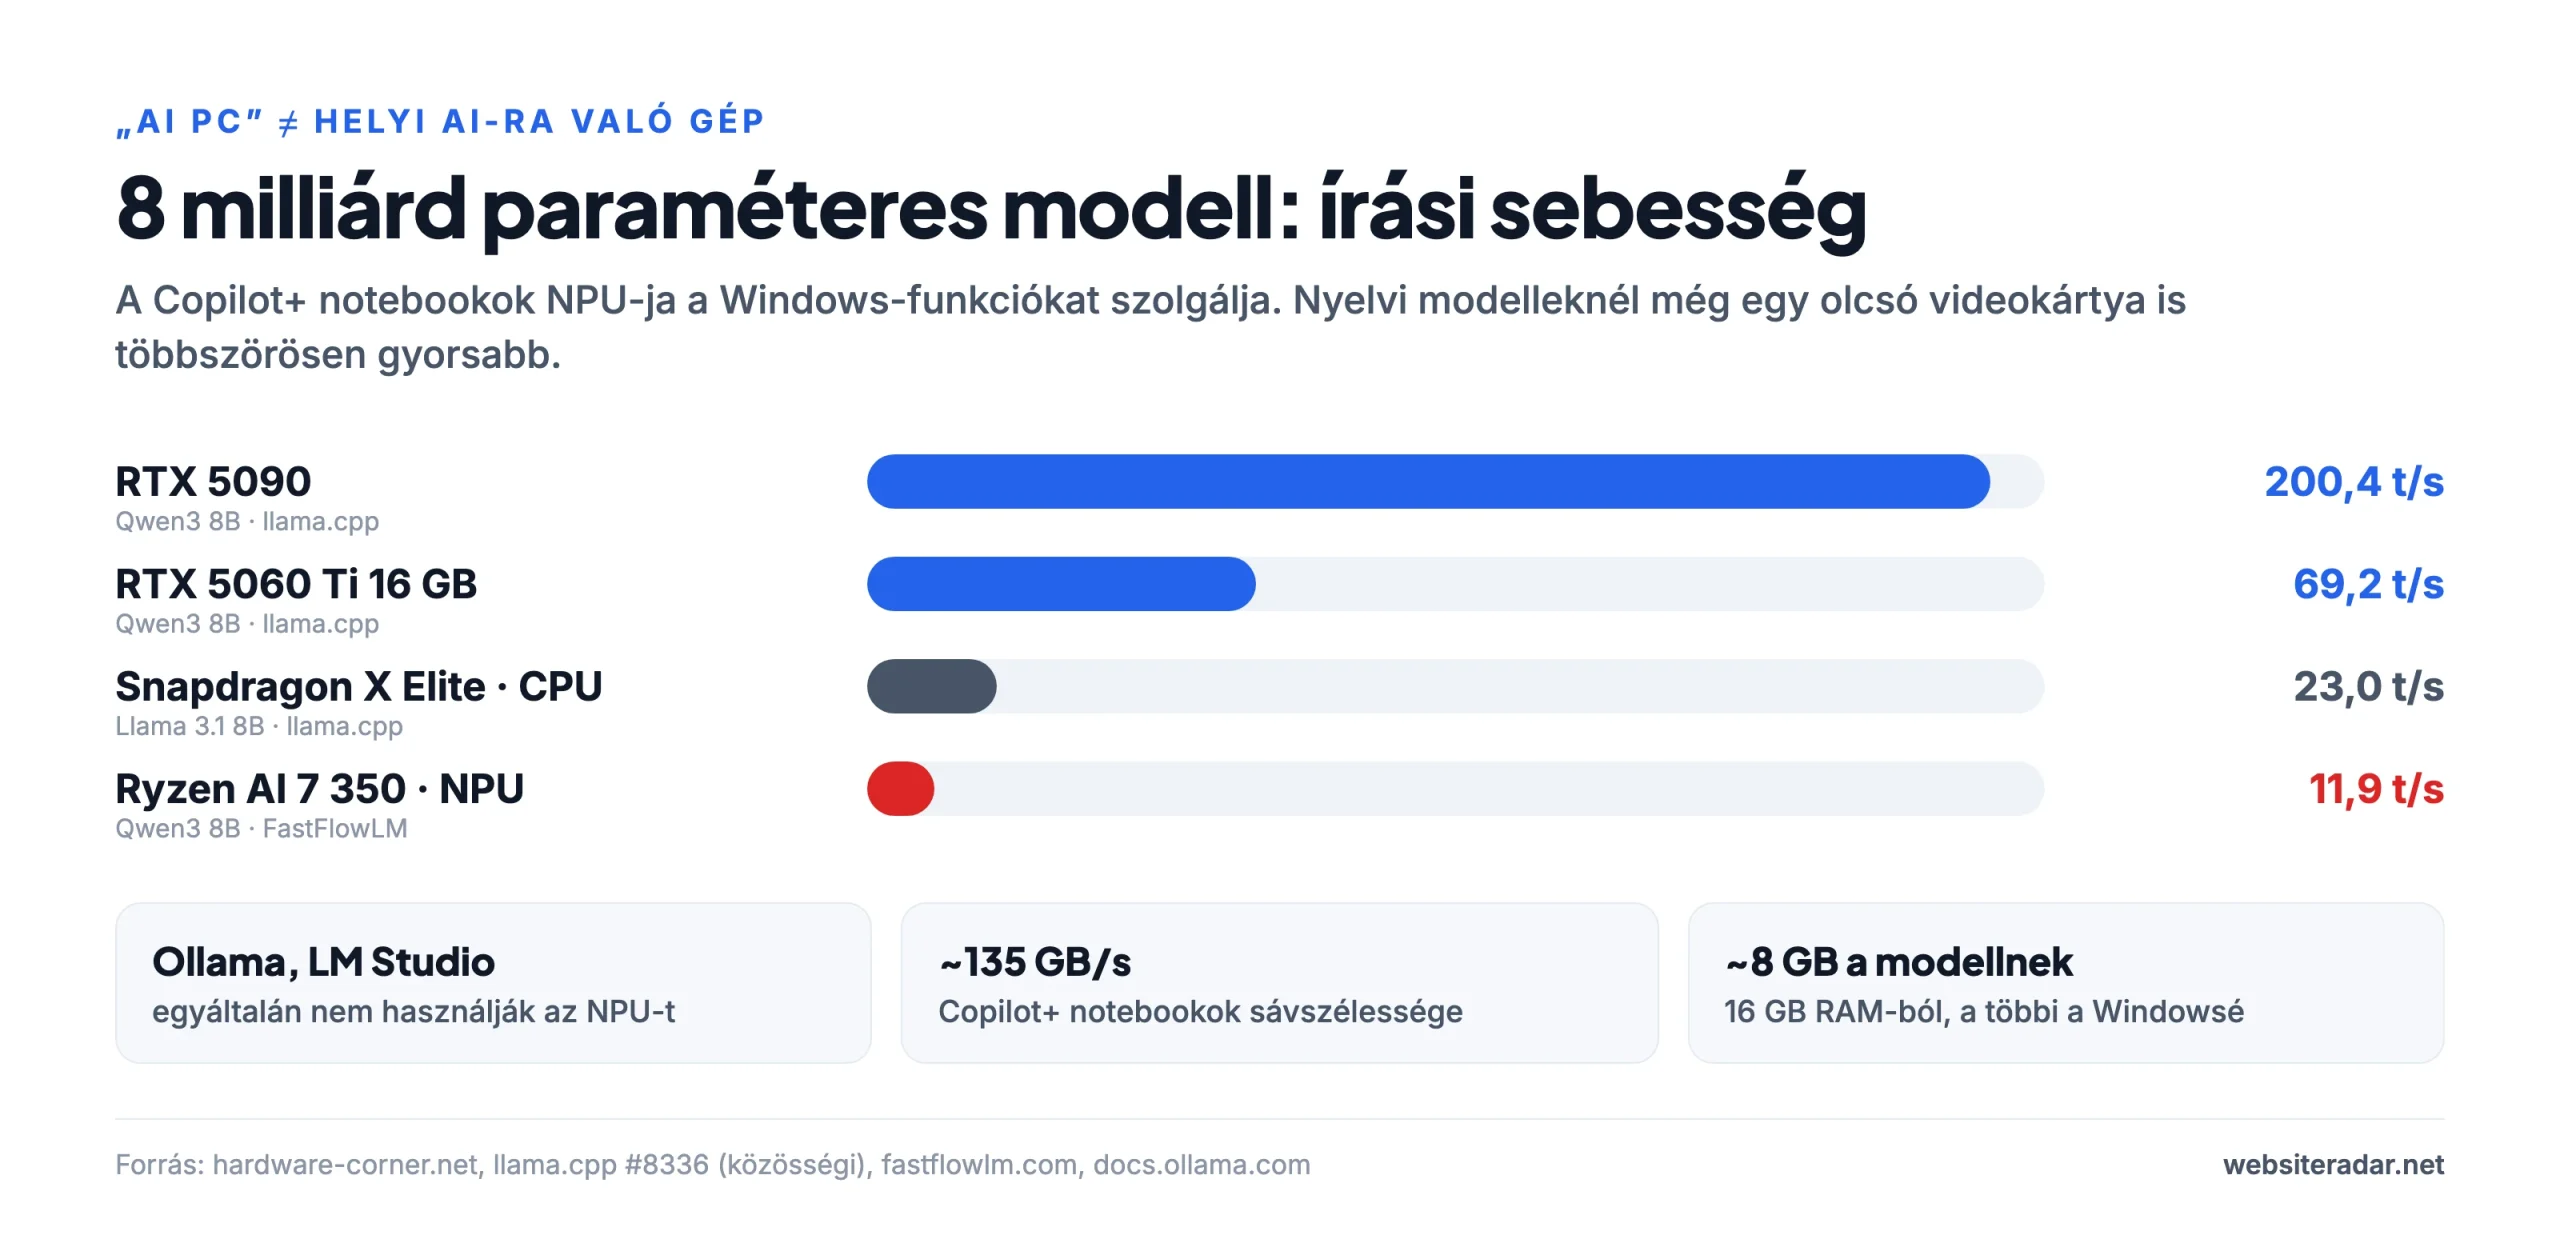
Ráadásul ezekben a notebookokban körülbelül 135 GB/s sávszélességű memória és 16 GB RAM van, ami nagyjából 8 GB-ot hagy a modellnek. 4 milliárd paraméterig terjedő modellekhez és a Windows-funkciókhoz megfelelnek – a „saját ChatGPT otthon” élményhez nem.
Kinek való: irodai munka, hosszú akkumulátor-üzemidő, kis 1–4B-s modellek. Kinek nem: aki 14B-s vagy nagyobb modelleket akar futtatni.
Fogyasztás és üzemeltetési költségek
Ha a gép éjjel-nappal otthoni AI-szerverként fog futni, az áramfogyasztás és a zaj is számít.
| Eszköz | Üresjárat | Modellfuttatás / maximum | Megjegyzés |
|---|---|---|---|
| Mac mini M6 | 4 W | max. 70 W | gyakorlatilag hangtalan |
| Mac mini M5 Pro | 6 W | max. 145 W | 5 dBA üresjáratban (Apple) |
| Mac Studio M5 Max | 7 W | max. 200 W | csendes |
| Mac Studio M5 Ultra | 9 W | ~300 W AI futtatásakor | a tesztek szerint csendes |
| DGX Spark | 25–45 W | 60–90 W AI futtatásakor, csúcsban akár 200 W | a firmware verziójától függ |
| Ryzen AI Max+ 395 mini PC | ~13 W | 120–160 W | a HP Z2 Mini terhelés alatt hangos |
| RTX 5090 (csak a kártya) | – | legfeljebb 575 W | plusz a PC többi része |
| RTX 5060 Ti (csak a kártya) | – | legfeljebb 180 W |
Az adatok gyártóktól és tesztekből (ServeTheHome, Tom’s Hardware, Notebookcheck) származnak, és nem azonos módszerrel mérték őket – tekintsd őket tájékoztató jellegűnek.
Szoftver: mivel futtasd a modellt
- Ollama – a legkönnyebb kezdés minden platformon; egyetlen paranccsal letöltheted a modellt. Macen a 0.19-es verziótól (egyelőre előzetes változatban, kiválasztott modelleknél) az MLX-et és az M5 neurális gyorsítóit használja.
- LM Studio – áttekinthető alkalmazás grafikus felülettel. Tipp M5-ös Macekhez: GGUF-modelleknél még nem használja a neurális gyorsítókat, és nagyjából feleakkora sebességgel olvassa be a promptot; használj helyettük MLX formátumú modelleket.
- llama.cpp – a legtöbb más eszköz alapja, a legtöbb beállítási lehetőséggel és az új hardverek leggyorsabb támogatásával. Ryzen AI Maxon próbáld ki mindkét backendet: a Vulkan általában gyorsabban ír, a ROCm gyorsabban olvassa be a hosszú promptot.
- MLX – az Apple könyvtára, a legjobb teljesítménnyel Macen, beleértve több Mac összekapcsolását Thunderbolt 5-ön keresztül.
- vLLM, SGLang, TensorRT-LLM – szervereszközök NVIDIA-hoz, amikor egy modell egyszerre több felhasználót szolgál ki.
A leggyakoribb vásárlási hibák
- 36 GB-os Mac „AI-ra”. Gyengébb a chipje, és a modellnek csak körülbelül 27 GB marad.
- RTX Spark notebook 32 GB-tal. A Windows legfeljebb 16 GB-ot ad a GPU-nak.
- Mac mini M6 16 GB-tal. Lassabb memória, és a modellnek csak körülbelül 12 GB jut.
- Copilot+ notebook helyi AI-ra. A hétköznapi eszközök nem használják az NPU-t.
- RTX 5080 az 5070 Ti helyett, csak AI-ra. Ugyanaz a 16 GB, szinte ugyanaz a sebesség.
- A memória-sávszélesség figyelmen kívül hagyása. A nagy, de lassú memória sűrű modelleknél lassú kimenetet jelent.
- Spórolás a memórián. A Maceken, a Ryzen AI Maxon és az RTX Sparkon a memória be van forrasztva, utólag nem bővíthető.
Gyakori kérdések
Elég a 16 GB a helyi AI-hoz? 14–20 milliárd paraméteres modellekig igen – például a gpt-oss-20b-hez vagy a Qwen3 14B-hez. A 30 milliárd körüli modellekhez 24–32 GB, a 70 milliárdosokhoz legalább 48 GB kell.
Mac vagy NVIDIA? A Mac gyorsabban ír, és több memóriát ad a pénzért; az NVIDIA gyorsabban olvassa be a promptot, és ott a CUDA. Csevegéshez és MoE-modellekkel dolgozó ügynökökhöz a Mac jön ki jobban, fejlesztéshez, tanításhoz és több felhasználó kiszolgálásához az NVIDIA.
Mit jelent a „MoE”? Mixture of experts, azaz szakértőkeverék: a modellnek sok paramétere van, de minden szóhoz csak egy kis részüket használja. Sok memória kell neki, de egy kisebb modell sebességével ír.
Milyen gyorsan kell írnia a modellnek? Körülbelül 15 token/s felel meg az olvasási sebességnek. Gördülékeny csevegéshez 30 vagy több a kényelmes; sok szöveget generáló kódoló ügynököknél 50 vagy több a jobb.
Olcsóbb a helyi AI, mint az előfizetés? Általában nem – a legjobb felhőszolgáltatásokhoz mérhető modellekhez sok ezer dolláros gépek kellenek. A fő érvek az adatvédelem, az adatok feletti kontroll és a függetlenség.
Összekapcsolhatok több számítógépet? Igen. Két DGX Spark QSFP-kábellel köthető össze, a Macek Thunderbolt 5-ön, RDMA-val (MLX vagy exo segítségével). A Mac mini M6 erre nem képes, mert csak Thunderbolt 4-e van.
Módszertan és források
Az eszközöket nem teszteltük saját magunk. A számok ellenőrzött forrásokból származnak, és a grafikonokon mindig megadjuk őket. A sebességet egyetlen programban (llama.cpp) hasonlítjuk össze, mert egy másik program vagy kvantálás könnyen 20–50%-kal eltolhatja az eredményeket. A közösségi méréseket (GitHub, fórumok) külön jelöljük. Az árak a gyártói bejelentésekből és tesztekből vett, dátummal ellátott amerikai listaárak.
- A modell kiszorulása a RAM-ba, RTX 5060 Ti: inventivehq.com/blog/vram-offload-cliff-gpu-layers-benchmark
- DGX Spark benchmark: github.com/ggml-org/llama.cpp/blob/master/benches/dgx-spark/dgx-spark.md
- gpt-oss útmutató és GPU-mérések: github.com/ggml-org/llama.cpp/discussions/15396
- M5 Max és LM Studio: github.com/lmstudio-ai/lmstudio-bug-tracker/issues/2040
- Ryzen AI Max (Strix Halo): strix-halo-toolboxes.com, llm-tracker.info/_TOORG/Strix-Halo
- Apple: apple.com/mac-studio/specs, apple.com/mac-mini/specs, machinelearning.apple.com/research/mlx-distributed-inference
- M5 Ultra: macstories.net/stories/m5-ultra-mac-studio-review-the-dream-mac-for-local-ai-agents
- RTX Spark: theregister.com (2026. október 16.), servethehome.com, storagereview.com
- GeForce videokártyák: nvidia.com/en-us/geforce/graphics-cards/compare, hardware-corner.net/gpu-llm-benchmarks
- llama.cpp ranglisták: github.com/ggml-org/llama.cpp/discussions/15013 és /10879
- Copilot+ PC: microsoft.com/windows/windows-11-specifications, docs.ollama.com/gpu, fastflowlm.com
- Modellméretek: huggingface.co (ggml-org, unsloth és bartowski repozitóriumok)
- Árak: Apple Newsroom, NVIDIA Newsroom és fejlesztői fórumok, servethehome.com, storagereview.com, notebookcheck.net, tomshardware.com